
Этот материал — самый распространенный тип контента у создателей: 48-секундное вертикальное селфи, телефон на вытянутой руке, простая комната на фоне, сиреневая футболка, естественные жесты и речь на русском языке. Цель состояла в том, чтобы поместить того же спикера в уютную гостиную в теплый вечер, одев его в приталенный синий блейзер, не меняя того, что делает этот клип уникальным: лицо, волосы, каждый жест, артикуляцию и голос.
Это исключает многие варианты. Зритель смотрит прямо на говорящее лицо, поэтому даже нескольких кадров с несовпадающей мимикой или слегка измененными чертами лица достаточно, чтобы он потерял интерес. Приведенные ниже клипы намеренно без звука: речь на русском языке, а здесь важно то, что вы видите.
Удачный процесс
- Сначала выберите короткий тестовый фрагмент. Мы отрежем пять секунд (35.4–40.4 с) из файла с телефона, конвертируем из 4K при 120 fps в 1080×1920 при 30 fps с сохранением звука. Протестируйте пять секунд, прежде чем оплачивать сорок восемь.
- Подготовьте один референсный стоп-кадр желаемого образа. Один кадр с тем же человеком, но уже в новом наряде и в новом помещении. Одно изображение может передать и гардероб, и локацию, если в промпте указано, что он не определяет ничего иного.
- Запустите Seedance 2.5 в режиме редактирования видео. Исходный клип служит видеореференсом, стоп-кадр — изображением-референсом, а промпт написан как команда для монтажа: что меняется, что остается основой, а что должно оставаться неподвижным. Генерация звука отключена.
- Проверьте длительность. Наш исходник длиной 5.00 секунд превратился в 4.71 секунд, при этом движение воспроизводилось примерно на 6% быстрее. После растягивания обратно до 5.00 с жесты совпали с исходником с точностью до двух кадров.
- Верните оригинальный голос. Собственная запись спикера накладывается на видео с измененным таймингом, поэтому голос никогда не является реконструкцией.
- Сначала проверьте лицо в полном размере, затем губы со звуком. Кадрируйте лицо в соотношении 1:1 относительно оригинала, прежде чем считать работу завершенной. Наложения, титры и вставки добавляются на этапе монтажа, они никогда не пропускаются через модель.
Необходимые входные данные
- Исходный клип должен быть не менее 4 секунд и не более 30 секунд за один проход (длинные дубли нужно разбивать).
- Референсный стоп-кадр целевого наряда и комнаты, в идеале с тем же человеком.
- Оригинальный звук, отложенный для последующего наложения на результат.
- Разговорный язык, чтобы артикуляция губ соответствовала правильной фонетике.
- Простой список того, что должно сохраниться (лицо, волосы, руки, тайминг), и того, что должно исчезнуть (старая комната, старая одежда, любые надписи на стене).
Путь 1: рестайлинг реальных съемок
Этот путь сохраняет записанную игру и перерисовывает только то, что должно измениться. Мы протестировали это на двух моделях Higgsfield с одним и тем же пятисекундным клипом и одним и тем же референсным стоп-кадром.
Источник
Запись на телефон
Вводные данные: пустая комната, сиреневая футболка, естественные жесты, эффект селфи с рук.
Источник
Локация и образ
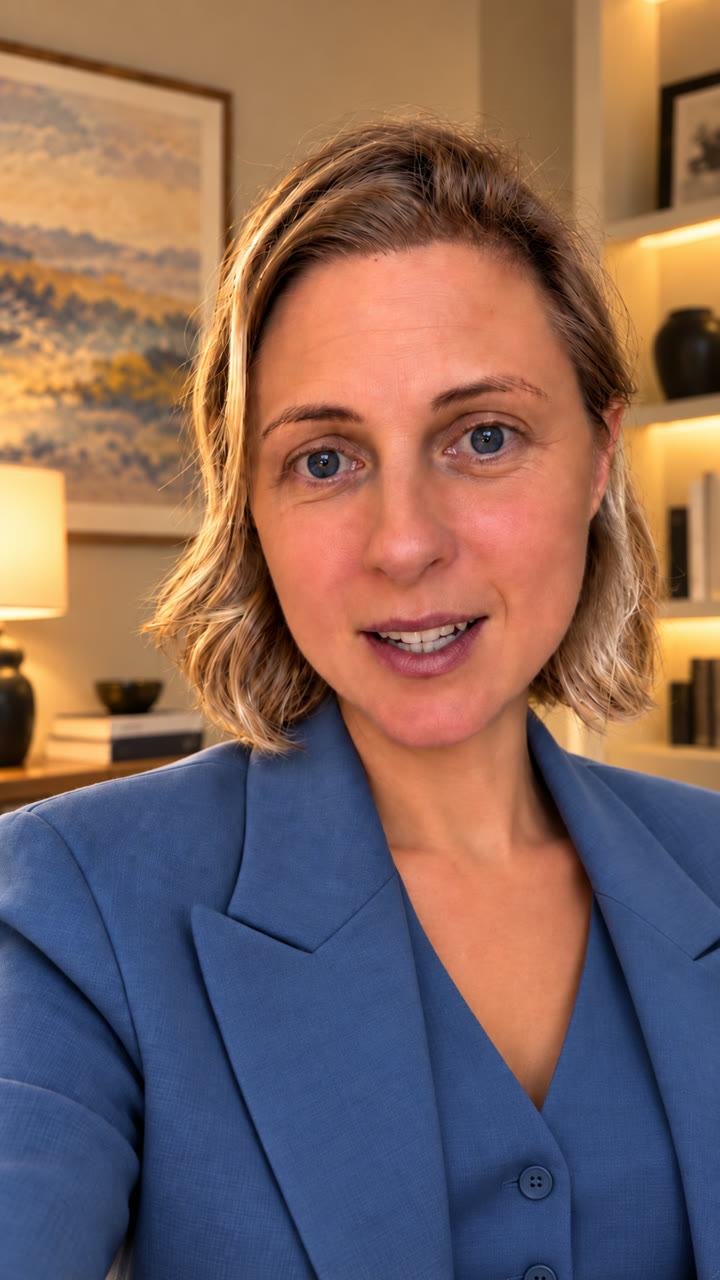
Референс, полученный в обоих дублях: он определяет одежду и комнату, и ничего больше.
Дубль А · выбрано
Seedance 2.5 Видеомонтаж
И комната, и наряд изменились; при этом черты лица и текстура кожи сохраняются, а моргание, мимика и жесты рук совпадают с исходником. Мы скорректировали тайминг результата перед добавлением оригинальной озвучки.
Дубль B
Higgsfield Genjutsu
Motion transfer точно копирует движения и добавляет блейзер, но старая комната остается прежней, а лицо получается более гладким и менее похожим на оригинал. Genjutsu не требует промпта.
Seedance 2.5 — это модель, которую следует использовать, если реальный человек остается в кадре. Она была единственной, которая смогла изменить комнату и одежду, сохранив при этом лицо, которое можно узнать на полноразмерном плане. Genjutsu справилась лишь наполовину, размыв черты лица. Мы также увеличили разрешение клипа Genjutsu с 720p до 1080p с помощью ByteDance Video Upscale: апскейлер дорисовывает ресницы и текстуру, и на лице, которое уже начало терять сходство, это только ухудшило результат. Апскейлинг не исправит слабую модель.
Режим работы важен так же, как и сама модель. Наши первые два дубля Seedance 2.5 использовали режим референса (omni) с прикрепленным клипом в качестве видеореференса. Оба завершились неудачей примерно через 45 секунд, средства были возвращены без объяснения причин через API. Ответ нашелся на веб-странице Higgsfield: Ваш промпт похож на запрос для видеомонтажа. Переключитесь в режим Video Edit, чтобы результат соответствовал вашему исходному видео.
В режиме Video Edit та же задача была выполнена с первой попытки. В Video Edit оплата идет за длину исходного клипа: 38 кредитов за пять секунд в 720p.
Путь 2: отделение человека и композитинг
Более дешевый способ не перерисовывает человека. Модель маттинга определяет, какие пиксели принадлежат спикеру; затем оригинальные пиксели накладываются на новый фон с помощью ffmpeg. Мы сравнили трех провайдеров на семисекундном фрагменте одной и той же записи, где новым фоном стал вид на город из окна. Этот фрагмент содержит три небольших вставленных видео-оверлея, показанных в том виде, в котором они были во входных данных.
Источник
Рабочий клип
То, что было предоставлено каждому провайдеру, включая оверлеи.
Вырезать 1 · ноутбук
RobustVideoMatting
Бесплатно и конфиденциально, но вокруг волос проглядывает старая комната, а вставленные оверлеи были восприняты как фон и заменены.
Cut-out 2 · HuggingFace
BiRefNet
Бесплатно в рамках ежедневной нормы GPU. Каждый кадр вырезается отдельно, поэтому края могут мерцать от кадра к кадру.
Cut-out 3 · fal.ai
VEED · отточенные детали
Самый чистый из трех вариантов, на нем сохранились наложения, но по краям волос все еще заметна легкая кайма старого фона.
| Провайдер | Модель | Время | Стоимость | Что получилось |
|---|---|---|---|---|
| Ноутбук (Intel i7, CPU) | RobustVideoMatting | 2 мин 01 с | бесплатно | Старый фон вокруг волос; наложения заменены |
| HuggingFace Space | BiRefNet | 3 мин 52 с | бесплатная квота | Покадровая прорисовка краев; челка |
| fal.ai | Удаление фона в VEED | 1 мин 16 с | $0.16 | Самый чистый; наложения сохранены; легкая челка |
| Higgsfield | Удаление фона на видео | не запущено | 1 кредит | Ошибка на этом клипе из настроек входа; в отдельном тестовом клипе он выдал человека на черном фоне |
Слабое место любого вырезания одно и то же: тонкие волосы на фоне светлой стены. В каждом результате между прядями остается часть старой комнаты, что выглядит как ореол на фоне нового неба. Вставленные оверлеи — вторая ловушка: модель кеинга знает только человека и всё остальное, поэтому не включайте оверлеи в отправляемый клип, а добавляйте их позже при монтаже.
Путь 3: регенерация спикера по одной фотографии
Третий вариант отбрасывает отснятый материал и анимирует одну фотографию с оригинальной озвучкой. Мы дали двум моделям аватаров одно и то же статичное фото спикера на пристани у озера и первые 5.55 секунд её записанной речи, заканчивающейся естественной паузой.
Исходное фото
Портрет Марины
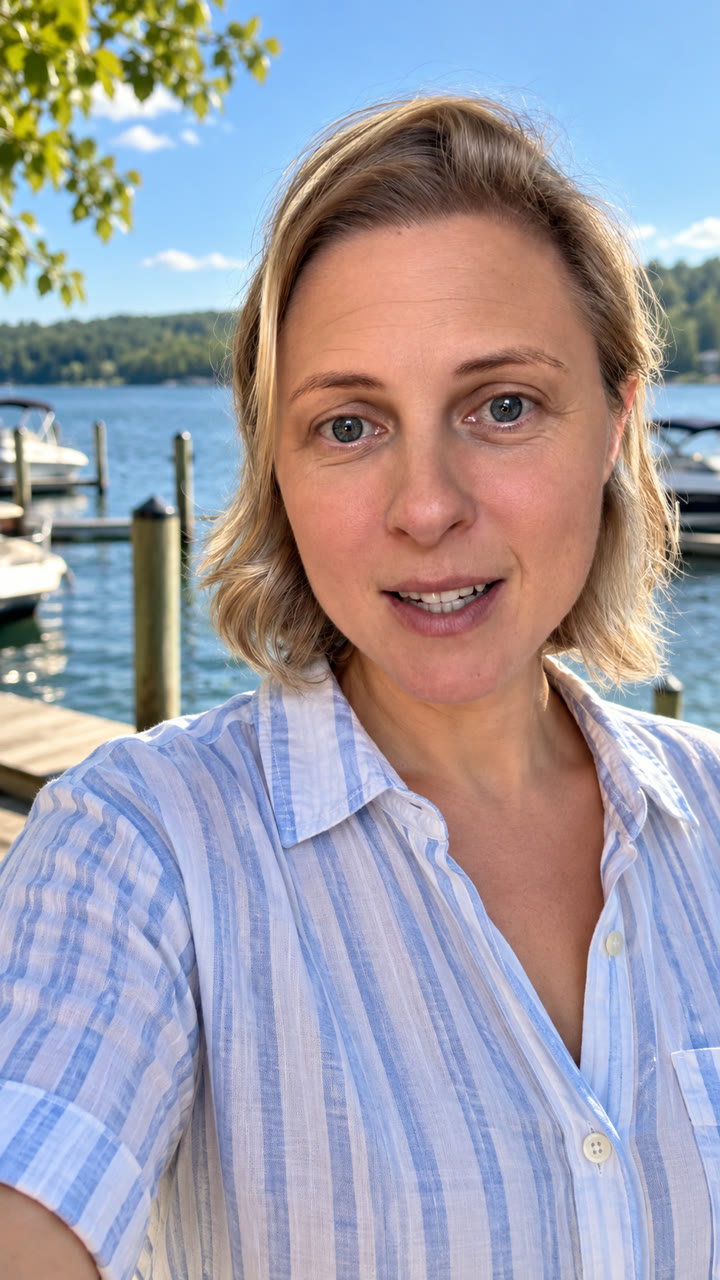
Анимация обеих моделей аватаров по одной фотографии с использованием собственного голоса спикера.
Аватар 1
OmniHuman 1.5
Живая мимика и движения головы, но кожа слишком сглажена, и она выглядит чуть моложе. $0.89 на fal, 3 мин.
Аватар 2
Kling AI Avatar v2 Pro
Ближе к фото, с сохранением веснушек и текстуры, и реалистичной тряской камеры. $0.83 на fal, 7 минут.
В обоих случаях сохраняется реальный голос, так как анимируется только лицо под него. Но невозможно сохранить реальную игру: каждый жест и поворот головы выдуманы. Это подходит для нового обращения в камеру, но это уже другое видео, а не оригинал в новой локации.
Шаблон
Это полный шаблон рестайлинга в его наиболее общем виде: он может заменить комнату, гардероб и прическу, сохранить выбранный реквизит из исходника и перемонтировать один дубль в несколько планов. Заполните данные в скобках и удалите то, что не требуется для вашей задачи. В Higgsfield отправляйте запрос в режиме Seedance 2.5 Video Edit.
- Сохранение собственных волос спикера: создание только
@Lookгардероба. - От старой комнаты ничего не оставляем: удалите строку с реквизитом.
- Один непрерывный дубль, например, селфи: используйте один этап и удалите строки о новых ракурсах и размерах кадра.
- Телефонная съемка: замените строку о стиле кинокамеры на «фотореалистичное видео с телефона, соответствующее исходнику», иначе результат не стыкуется с остальной записью.
- Оригинальный голос: отключите сгенерированный звук и наложите запись заново после обработки.
| Маршрут | Комната | Наряд | Реальная производительность | Лицо | Стоимость |
|---|---|---|---|---|---|
| Seedance 2.5 Видеомонтаж | новый | новый | сохранено | максимально близко к исходнику | 38 кредитов / 5 с |
| Перенос движения Genjutsu | старая комната | новый | сохранено | сглаженный | 35 кредитов / 5 с |
| Genjutsu + апскейл 1080p | старая комната | новый | сохранено | хуже, чем 720p | +1 кредит |
| Вырезание и композитинг | новый | старый | нетронутый | без изменений; челка | бесплатно — $0.16 / 7 с |
| Фотоаватар | на фото | на фото | выдуманный | сглаженный или близкий | $0.83–0.89 / 5.6 с |
Доказательства
- Дата
- 1–2 октября 2026
- Основа
- На основе анализа семи сгенерированных результатов, одной исходной записи, одного референсного кадра и одной фотографии; стоимость рассчитана по платежным записям Higgsfield и Fal за каждый запуск
- Объект
- Вертикальное селфи с говорящей головой на русском языке: 5-секундный фрагмент для рестайлинга и аватаров, 7-секундный фрагмент для вырезания объектов
- Измерено
- Смена комнаты и одежды, сходство лица в полный рост, синхронизация жестов и мимики с исходником, края волос, длительность и стоимость
- Предостережение
- Один спикер, один тестовый образец на каждый маршрут, оценка визуальная. Это производственный кейс, а не бенчмарк модели.
Сохраните человека, измените мир вокруг него
easyai.video сохраняет исходный клип, референсный кадр, промпт и выбранную модель вместе, чтобы следующая стилизация начиналась с того, что уже сработало.
Вступить в список ожидания ↗