
O material é o tipo mais comum que um criador possui: uma selfie vertical de 48 segundos, com o telemóvel estendido, uma divisão simples ao fundo, uma t-shirt lilás, gestos naturais e fala em russo. O objetivo era colocar a mesma pessoa numa sala de estar acolhedora ao entardecer, vestindo um blazer azul sob medida, sem alterar o que torna o clip único: o rosto, o cabelo, cada gesto, os movimentos da boca e a voz.
Isso exclui muitas opções. O espectador está a olhar diretamente para um rosto que fala, por isso, alguns fotogramas de uma boca que não coincide com as palavras, ou um rosto suavizado que parece alguém ligeiramente diferente, são suficientes para o perder. Os clipes abaixo não têm som de propósito: a fala é em russo, e o que importa aqui é o que consegue ver.
O processo que funcionou
- Escolha primeiro um pequeno teste. Cortamos cinco segundos (35.4–40.4 s) do ficheiro do telemóvel, convertido de 4K a 120 fps para 1080×1920 a 30 fps, mantendo o som. Teste cinco segundos antes de pagar por quarenta e oito.
- Prepare uma imagem de referência do visual pretendido. Um único fotograma da mesma pessoa já com o novo vestuário e no novo cenário. Uma única imagem pode conter tanto o guarda-roupa como a localização, desde que o prompt indique que não define mais nada.
- Execute Seedance 2.5 no modo Video Edit. O clipe de origem é a referência de vídeo, a imagem estática é a referência de imagem e o prompt é escrito como uma ordem de edição: o que muda, o que é o mestre e o que não deve mover. O som gerado está desligado.
- Verifique a duração. A nossa fonte de 5.00 segundos resultou em 4.71 segundos, com o movimento a decorrer cerca de 6% mais rápido. Ao ser estendida para 5.00 s, os gestos alinharam-se com a fonte num intervalo de dois fotogramas.
- Recupere a voz original. A gravação do próprio interlocutor é sobreposta à imagem reajustada, para que a voz nunca seja uma reconstrução.
- Verifique o rosto em tamanho real, depois os lábios com o som. Corte o rosto em 1:1 em relação à fonte antes de dar o trabalho como concluído. Sobreposições, legendas e inserções são adicionadas na montagem posteriormente, nunca através do modelo.
Inputs necessários
- O clipe de origem, com pelo menos 4 segundos e no máximo 30 segundos por execução (divida tomadas mais longas).
- Uma imagem de referência do traje e do ambiente pretendidos, idealmente com a mesma pessoa.
- O áudio original, colocado de parte para ser aplicado novamente no resultado.
- O idioma falado, para que os movimentos da boca sigam a fonética correta.
- Uma lista simples do que deve permanecer (rosto, cabelo, mãos, timing) e do que deve sair (a sala antiga, as roupas antigas, qualquer coisa impressa na parede).
Rota 1: reestilizar a filmagem real
Este método mantém a performance gravada e redesenha apenas o que deve mudar. Executámos-no em dois modelos Higgsfield com o mesmo clipe de cinco segundos e a mesma imagem de referência.
Fonte
Gravação de telemóvel
A entrada: uma sala simples, uma t-shirt lilás, gestos naturais, movimento de selfie manual.
Referência
Cenário e vestuário pretendidos
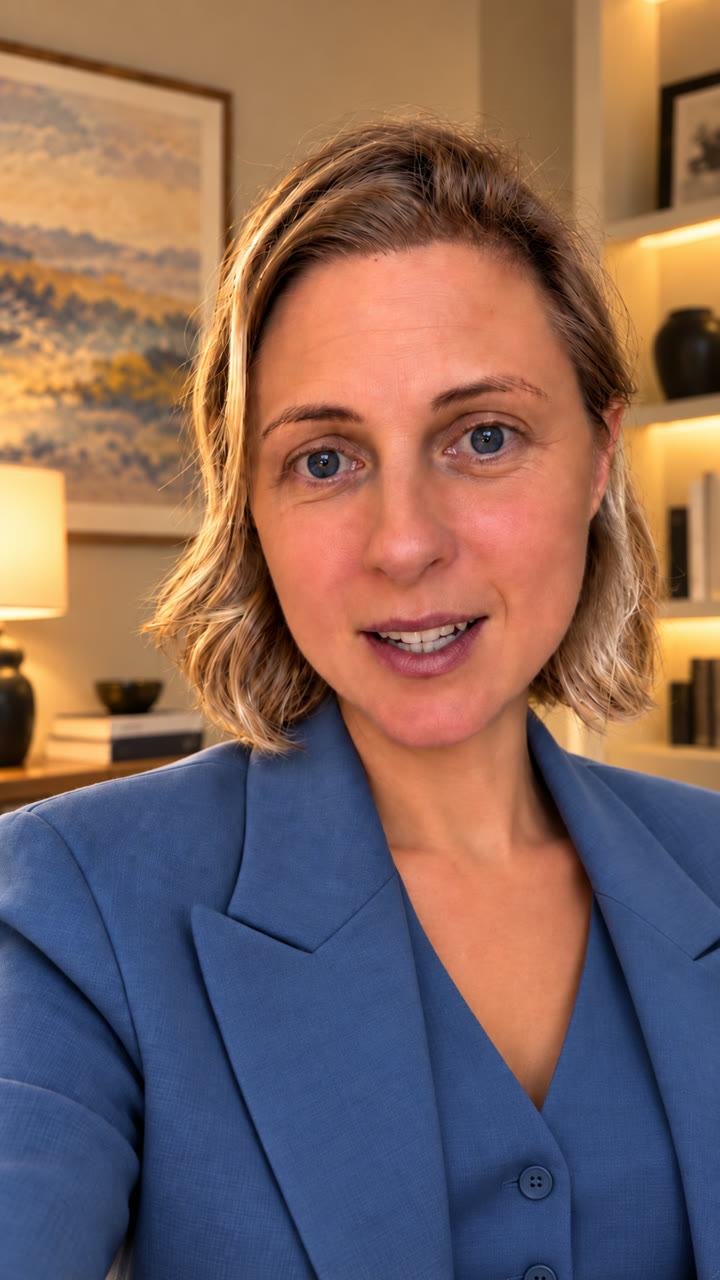
A referência que ambas as tomadas receberam: define o traje e a divisão, nada mais.
Tomada A · selecionada
Seedance 2.5 Edição de Vídeo
Tanto o cenário como o traje foram alterados; o rosto mantém as suas linhas e textura de pele, e os piscar de olhos, as formas da boca e os gestos das mãos coincidem com a fonte. Ajustámos o tempo do resultado antes de adicionar a voz original.
Take B
Higgsfield Genjutsu
A transferência de movimento copia fielmente a performance e adiciona o blazer, mas a sala antiga permanece, e o rosto fica mais suave e menos parecido com a fonte. O Genjutsu não utiliza prompt.
Seedance 2.5 é o modelo a utilizar quando uma pessoa real permanece no plano. Foi o único que alterou a sala e a roupa, mantendo um rosto que reconheceria em tamanho real. O Genjutsu fez metade do trabalho e suavizou o rosto. Também aumentámos a resolução do clipe Genjutsu de 720p para 1080p com o ByteDance Video Upscale: o upscaler inventa pestanas e textura e, num rosto que já tinha perdido a fidelidade, tornou o resultado pior, não melhor. O upscaling não corrige um modelo mais fraco.
O modo é tão importante como o modelo. As nossas duas primeiras tentativas de Seedance 2.5 utilizaram o modo de referência (omni) com o clipe anexado como referência de vídeo. Ambas falharam após cerca de 45 segundos e foram reembolsadas, sem que fosse dada qualquer razão através da API. A página web da Higgsfield deu a resposta: O seu prompt parece um pedido de edição de vídeo. Mude para o modo Video Edit para que o resultado siga o seu vídeo de entrada.
No modo Video Edit, o mesmo trabalho foi concluído à primeira tentativa. O Video Edit fatura com base na duração do clipe de origem: 38 créditos para cinco segundos em 720p.
Rota 2: isolar a pessoa e fazer composição
A rota mais barata nunca redesenha a pessoa. Um modelo de matting identifica quais os píxeis que pertencem ao orador; os píxeis originais são depois sobrepostos a um novo fundo com ffmpeg. Comparamos três fornecedores numa peça de sete segundos da mesma gravação, com uma vista da cidade através de uma janela como novo fundo. Esta peça contém três pequenas sobreposições de vídeo inseridas, mostradas tal como apareceram no input.
Fonte
Clipe de trabalho
O que foi atribuído a todos os fornecedores, incluindo sobreposições.
Recorte 1 · portátil
RobustVideoMatting
Gratuito e privado, mas a divisão antiga transparece em redor do cabelo e as sobreposições inseridas foram tratadas como fundo e substituídas.
Cut-out 2 · HuggingFace
BiRefNet
Gratuito dentro da quota diária de GPU. Cada fotograma é recortado individualmente, pelo que as bordas podem oscilar de fotograma para fotograma.
Recorte 3 · fal.ai
VEED · contornos refinados
O mais limpo dos três e manteve as sobreposições, mas ainda se nota uma leve margem do fundo antigo no cabelo.
| Fornecedor | Modelo | Tempo | Custo | O que apareceu |
|---|---|---|---|---|
| Portátil (Intel i7, CPU) | RobustVideoMatting | 2 min 01 s | grátis | Fundo antigo em redor do cabelo; sobreposições substituídas |
| HuggingFace Space | BiRefNet | 3 min 52 s | quota gratuita | Contornos fotograma a fotograma; franja do cabelo |
| fal.ai | Remoção de fundo VEED | 1 min 16 s | $0.16 | Mais limpo; sobreposições mantidas; franja de cabelo leve |
| Higgsfield | Removedor de fundo de vídeo | não executado | 1 crédito | Falhou neste clipe de uma configuração de login; num clipe de teste separado, apresentou a pessoa em fundo preto |
O ponto fraco de cada recorte é o mesmo: cabelo fino contra uma parede clara. Cada resultado mantém parte do antigo cenário entre os fios, o que cria um efeito de halo contra um novo céu. Sobreposições inseridas são a segunda armadilha: um modelo de matting só reconhece a pessoa e todo o resto, por isso mantenha as sobreposições fora do clipe que enviar e adicione-as novamente na montagem.
Rota 3: regenerar o orador a partir de uma fotografia
A terceira via descarta o metraje e anima uma única fotografia com a voz original. Fornecemos a dois modelos de avatar a mesma imagem estática da oradora numa marina à beira-lago e os primeiros 5.55 segundos do seu discurso gravado, terminando numa pausa natural.
Foto de origem
Retrato da Marina
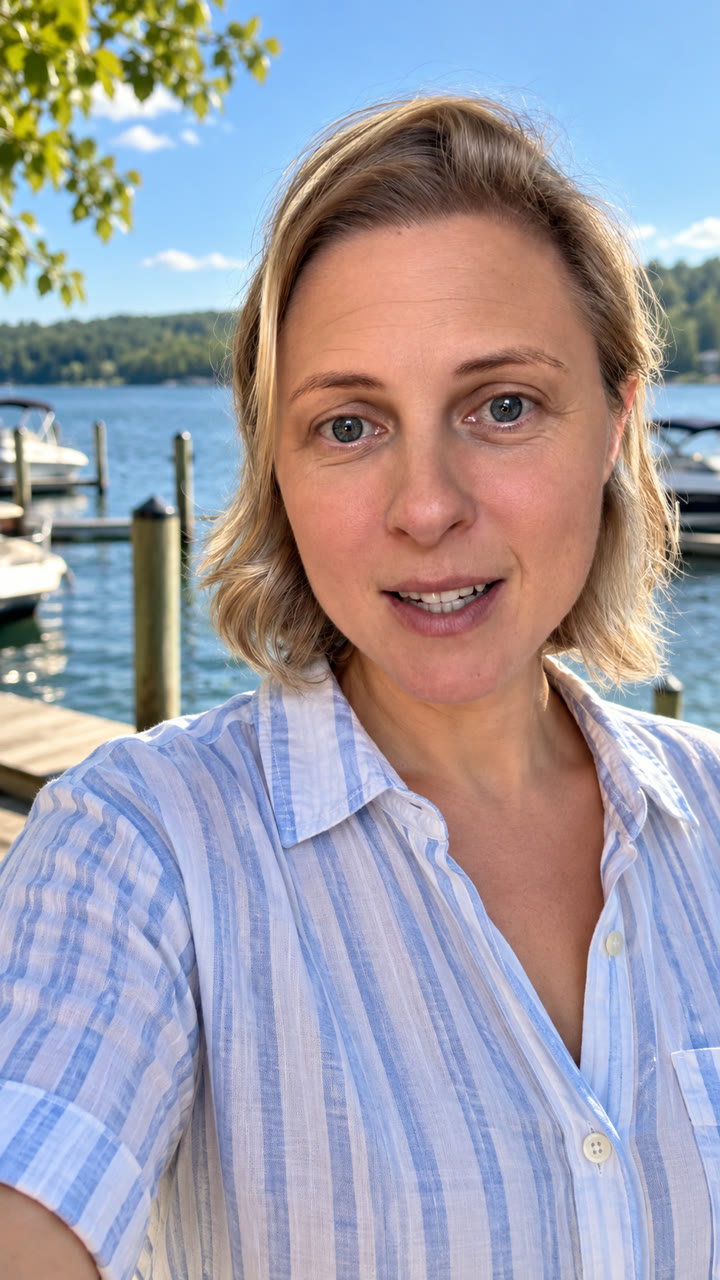
A única fotografia com ambos os modelos de avatar animados, utilizando a própria voz do orador.
Avatar 1
OmniHuman 1.5
Movimento vívido da cabeça e da boca, mas a pele está suavizada e ela parece ligeiramente mais jovem. $0.89 na fal, 3 minutos.
Avatar 2
Kling AI Avatar v2 Pro
Mais próximo da foto, mantendo as sardas e a textura, com um balanço de câmara à mão credível. $0.83 em fal, 7 minutos.
Ambos mantêm a voz real, porque apenas animam o rosto para ela. O que não conseguem manter é a performance real: cada gesto e movimento de cabeça é inventado. Isso adequa-se a um novo plano para a câmara, mas é um vídeo diferente, não o original num novo cenário.
O modelo
Este é o modelo de restilização completo na sua forma mais geral: pode substituir a divisão, o guarda-roupa e o cabelo, manter os objetos escolhidos da fonte e re-editar uma tomada em vários ângulos. Preencha os campos entre parênteses e apague o que não for necessário para o seu trabalho. No Higgsfield, submeta-o no modo Seedance 2.5 Video Edit.
- Manter o cabelo do próprio orador: criar apenas
@Lookde vestuário. - Nada a manter da sala antiga: apague a linha de adereços.
- Uma única tomada contínua, como uma selfie: utilize um único cenário e elimine as linhas sobre novos ângulos e tamanhos de plano.
- Filmagem de telemóvel: substitua a linha do estilo de câmara de cinema por "vídeo de telemóvel fotorrealista correspondente à fonte", caso contrário, o resultado não fará uma boa montagem com o resto da gravação.
- A voz original: desligue o som gerado e sobreponha a gravação original depois.
| Rota | Sala | Roupa | Desempenho real | Rosto | Custo |
|---|---|---|---|---|---|
| Seedance 2.5 Edição de Vídeo | novo | novo | mantido | mais próximo da fonte | 38 créditos / 5 s |
| Transferência de movimento Genjutsu | sala antiga | novo | mantido | suavizado | 35 créditos / 5 s |
| Genjutsu + upscale 1080p | sala antiga | novo | mantido | pior que 720p | +1 crédito |
| Recorte e composição | novo | antigo | intocado | intocado; franja | grátis–$0.16 / 7 s |
| Avatar fotográfico | a partir da foto | a partir da foto | inventado | suavizado ou próximo | $0.83–0.89 / 5.6 s |
Evidência
- Data
- 1–2 de Outubro de 2026
- Base
- Observado a partir de sete resultados gerados, uma gravação de origem, uma imagem de referência e uma fotografia; custos baseados nos registos de faturação da Higgsfield e fal de cada execução
- Assunto
- Um selfie vertical de uma pessoa a falar em russo: uma peça de 5 segundos para restilização e avatares, uma peça de 7 segundos para recortes
- Medido
- Alteração de cenário e de roupa, semelhança facial em tamanho real, sincronização de gestos e boca com a fonte, contornos do cabelo, tempo de execução e custo
- Nota
- Um orador, uma peça de teste por rota, avaliada visualmente. Um estudo de caso de produção, não um benchmark de modelo.
Mantenha a pessoa, mude o mundo à volta dela
easyai.video mantém o clipe de origem, a imagem de referência, o prompt e a escolha do modelo juntos, para que a próxima reestilização parta do que já funcionou.
Junte-se à lista de espera ↗