
El metraje es el tipo más común que tiene un creador: un selfie vertical de 48 segundos, con el teléfono a brazo extendido, una habitación sencilla de fondo, una camiseta lila, gestos naturales y habla en ruso. El objetivo era situar a la misma persona en un cálido salón al atardecer, vistiendo una americana azul a medida, sin alterar lo que hace que el clip sea suyo: el rostro, el cabello, cada gesto, la forma de la boca y la voz.
Eso descarta muchas opciones. El espectador mira directamente a un rostro que habla, así que unos pocos fotogramas de una boca que no coincide con las palabras, o un rostro suavizado que parece alguien ligeramente distinto, bastan para perder su atención. Los clips de abajo no tienen sonido a propósito: el discurso es en ruso, y lo que importa aquí es lo que puedes ver.
El proceso que funcionó
- Elige primero una pieza de prueba corta. Cortamos cinco segundos (35.4–40.4 s) del archivo del móvil, convertido de 4K a 120 fps a 1080×1920 a 30 fps, manteniendo el sonido. Haz una prueba con cinco segundos antes de pagar por cuarenta y ocho.
- Prepara una imagen de referencia del estilo deseado. Un único fotograma de la misma persona ya con el nuevo atuendo y en la nueva estancia. Una sola imagen puede contener tanto el vestuario como la localización, siempre que el prompt indique que no define nada más.
- Ejecuta Seedance 2.5 en modo Edición de Vídeo. El clip de origen es la referencia de vídeo, la imagen fija es la referencia de imagen y el prompt se escribe como una orden de edición: qué cambia, qué es el máster y qué no debe moverse. El sonido generado está desactivado.
- Comprueba la duración. Nuestra fuente de 5.00 segundos resultó en 4.71 segundos; su movimiento se reprodujo aproximadamente un 6% más rápido. Al estirarlo de nuevo a 5.00 s, los gestos coincidieron con la fuente en un margen de dos fotogramas.
- Recupera la voz original. La propia grabación del interlocutor se superpone a la imagen reajustada, por lo que la voz nunca es una reconstrucción.
- Revisa la cara a tamaño completo, luego los labios con el sonido. Recorta la cara a 1:1 respecto a la fuente antes de darlo por terminado. Las superposiciones, subtítulos e insertos se añaden en el montaje posteriormente, nunca se pasan por el modelo.
Entradas necesarias
- El clip de origen, de al menos 4 segundos y como máximo 30 segundos por ejecución (divide las tomas más largas).
- Una imagen de referencia del atuendo y la habitación de destino, idealmente con la misma persona.
- El audio original, reservado para volver a integrarlo en el resultado final.
- El idioma hablado, para que los movimientos de la boca sigan la fonética correcta.
- Una lista simple de lo que debe permanecer (cara, pelo, manos, ritmo) y lo que debe desaparecer (la habitación antigua, la ropa antigua, cualquier cosa impresa en la pared).
Ruta 1: reestilizar el metraje real
Esta ruta mantiene la interpretación grabada y redibuja solo lo que debe cambiar. Lo probamos en dos modelos de Higgsfield con el mismo clip de cinco segundos y la misma imagen de referencia.
Fuente
Grabación de teléfono
La entrada: una habitación sencilla, una camiseta lila, gestos naturales, movimiento de selfie con la mano.
Referencia
Habitación y atuendo objetivo
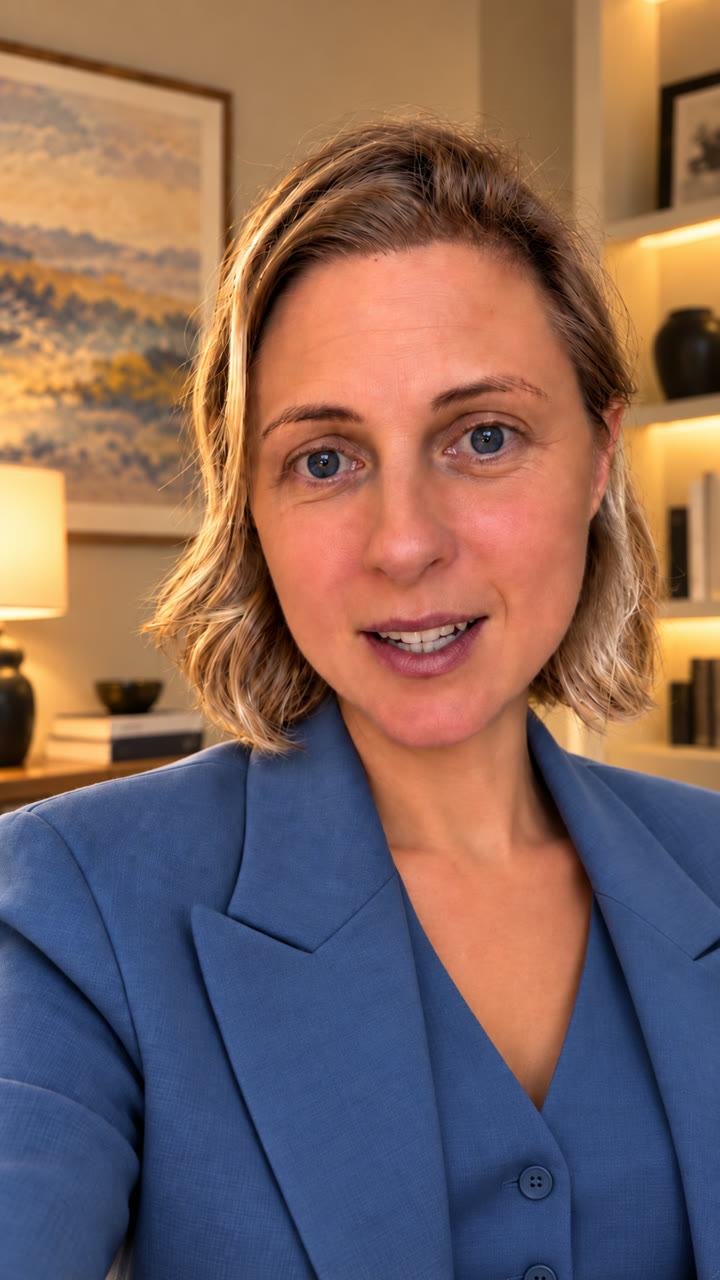
La referencia que recibieron ambas tomas: define el atuendo y la habitación, nada más.
Toma A · seleccionada
Seedance 2.5 Edición de vídeo
Tanto la habitación como el atuendo han cambiado; el rostro mantiene sus líneas y textura de la piel, y los parpadeos, las formas de la boca y los gestos de las manos coinciden con la fuente. Ajustamos el tiempo del resultado antes de añadir la voz original.
Toma B
Higgsfield Genjutsu
Motion transfer copia fielmente la interpretación y añade la americana, pero la habitación antigua permanece y el rostro sale más suave y menos parecido al original. Genjutsu no requiere prompt.
Seedance 2.5 es el modelo que debes usar cuando una persona real permanece en plano. Fue el único que cambió la habitación y la ropa manteniendo un rostro que reconocerías a tamaño completo. Genjutsu hizo la mitad del trabajo y suavizó el rostro. También escalamos el clip de Genjutsu de 720p a 1080p con ByteDance Video Upscale: el escalador inventa pestañas y texturas, y en un rostro que ya había perdido definición, hizo que el resultado pareciera peor, no mejor. Escalar no arregla un modelo débil.
El modo es tan importante como el modelo. Nuestros dos primeros intentos de Seedance 2.5 utilizaron el modo de referencia (omni) con el clip adjunto como referencia de vídeo. Ambos fallaron tras unos 45 segundos y se reembolsaron, sin que se diera ninguna razón a través de la API. La página web de Higgsfield dio la respuesta: Tu prompt parece una solicitud de edición de vídeo. Cambia al modo Video Edit para que el resultado siga tu vídeo de entrada.
En el modo Video Edit, el mismo trabajo se logró al primer intento. Video Edit factura según la duración del clip de origen: 38 créditos por cinco segundos a 720p.
Ruta 2: recortar a la persona y realizar el compuesto
La ruta más económica nunca redibuja a la persona. Un modelo de matting identifica qué píxeles pertenecen al interlocutor; luego, los píxeles originales se superponen a un nuevo fondo con ffmpeg. Comparamos tres proveedores en una pieza de siete segundos de la misma grabación, con una vista de la ciudad desde una ventana como nuevo fondo. Esta pieza incluye tres pequeñas superposiciones de vídeo insertadas, mostradas tal como aparecieron en la entrada.
Fuente
Clip en funcionamiento
Lo que se entregó a cada proveedor, incluyendo superposiciones.
Recorte 1 · portátil
RobustVideoMatting
Gratis y privado, pero la habitación antigua se trasluce alrededor del cabello y las superposiciones insertadas se trataron como fondo y fueron reemplazadas.
Cut-out 2 · HuggingFace
BiRefNet
Gratis dentro del límite diario de GPU. Cada fotograma se recorta de forma independiente, por lo que los bordes pueden parpadear de un fotograma a otro.
Recorte 3 · fal.ai
VEED · bordes refinados
Es la más limpia de las tres y ha mantenido las superposiciones, pero todavía se aprecia un ligero borde del fondo antiguo en el cabello.
| Proveedor | Modelo | Tiempo | Coste | Lo que apareció |
|---|---|---|---|---|
| Portátil (Intel i7, CPU) | RobustVideoMatting | 2 min 01 s | gratis | Fondo antiguo alrededor del cabello; superposiciones reemplazadas |
| HuggingFace Space | BiRefNet | 3 min 52 s | cuota gratuita | Bordes fotograma a fotograma; flequillo |
| fal.ai | Eliminación de fondo de VEED | 1 min 16 s | $0.16 | El más limpio; con superposiciones; flequillo de pelo claro |
| Higgsfield | Eliminador de fondo de vídeo | no ejecutado | 1 crédito | Error en este clip desde un ajuste de inicio de sesión; en una toma de prueba distinta, devolvió a la persona sobre fondo negro |
El punto débil de cada recorte es el mismo: pelo fino contra una pared brillante. Cada resultado conserva parte de la habitación antigua entre las hebras, lo que se percibe como un halo contra un cielo nuevo. Las superposiciones insertadas son la segunda trampa: un modelo de recorte solo conoce a la persona y todo lo demás, así que mantén las superposiciones fuera del clip que envíes y añádelas de nuevo en el montaje.
Ruta 3: regenerar al interlocutor a partir de una foto
La tercera ruta descarta el metraje y anima una sola foto con la voz original. Le dimos a dos modelos de avatar la misma imagen fija del ponente en un puerto deportivo junto al lago y los primeros 5.55 segundos de su discurso grabado, terminando en una pausa natural.
Foto de origen
Retrato de Marina
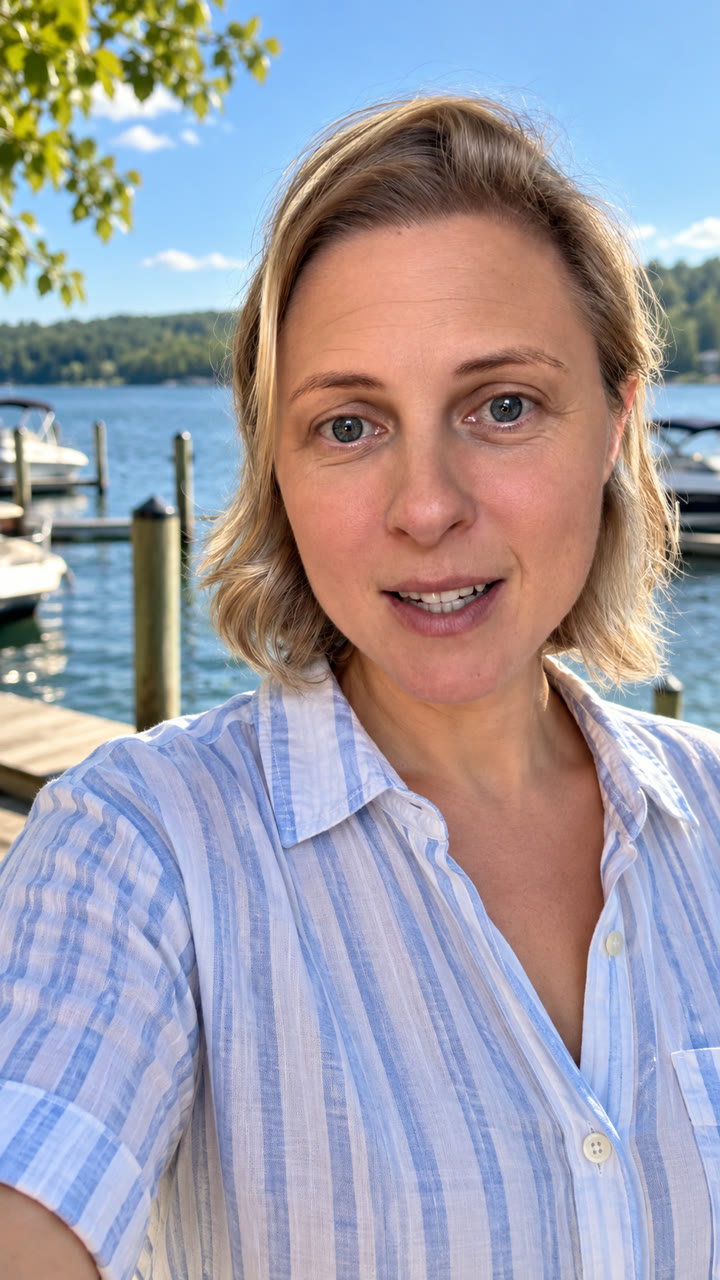
La única foto con ambos modelos de avatar animados, con la propia voz del interlocutor.
Avatar 1
OmniHuman 1.5
Movimiento de cabeza y boca animado, pero la piel está suavizada y parece algo más joven. $0.89 en fal, 3 minutos.
Avatar 2
Kling AI Avatar v2 Pro
Más parecido a la foto, manteniendo las pecas y la textura con un balanceo de cámara en mano creíble. 0.83$ en fal, 7 minutos.
Ambos mantienen la voz real, ya que solo animan el rostro para sincronizarla. Lo que no pueden mantener es la interpretación real: cada gesto y movimiento de cabeza es inventado. Esto funciona para un nuevo mensaje directo a cámara, pero es un vídeo distinto, no el original en una sala nueva.
La plantilla
Esta es la plantilla de reestilización completa en su forma más general: puede sustituir la habitación, el armario y el cabello, mantener los accesorios elegidos de la fuente y re-montar una toma en varios planos. Rellena los campos entre corchetes y elimina lo que no necesites para tu trabajo. En Higgsfield, envíalo en el modo Seedance 2.5 Video Edit.
- Mantener el propio cabello del interlocutor: crear
@Looksolo vestuario. - No queda nada de la sala antigua: elimina la línea de accesorios.
- Una toma continua, como un selfie: usa una sola etapa y elimina las líneas sobre nuevos ángulos y tamaños de plano.
- Metraje de móvil: sustituye la línea de estilo de cámara de cine por "vídeo de móvil fotorrealista que coincida con el origen", de lo contrario, el resultado no encajará en el montaje con el resto de la grabación.
- La voz original: desactiva el sonido generado y vuelve a colocar la grabación después.
| Ruta | Habitación | Atuendo | Rendimiento real | Rostro | Coste |
|---|---|---|---|---|---|
| Seedance 2.5 Edición de vídeo | nuevo | nuevo | mantenido | lo más parecido al original | 38 créditos / 5 s |
| Transferencia de movimiento Genjutsu | habitación vieja | nuevo | mantenido | suavizado | 35 créditos / 5 s |
| Genjutsu + escalado 1080p | habitación vieja | nuevo | mantenido | peor que 720p | +1 de crédito |
| Recorte y composición | nuevo | antiguo | intacto | sin tocar; flequillo | gratis–$0.16 / 7 s |
| Avatar fotográfico | desde la foto | desde la foto | inventado | suavizado o cercano | $0.83–0.89 / 5.6 s |
Evidencia
- Fecha
- 1–2 de octubre de 2026
- Base
- Observado a partir de siete resultados generados, una grabación de origen, una imagen de referencia y una fotografía; costes basados en los registros de facturación de Higgsfield y fal de cada ejecución
- Sujeto
- Un selfie vertical de una persona hablando en ruso: una pieza de 5 segundos para reestilizar y crear avatares, y una pieza de 7 segundos para recortes.
- Medido
- Cambio de habitación y de atuendo, parecido facial a tamaño completo, sincronización de gestos y boca con la fuente, bordes del cabello, duración y coste
- Advertencia
- Un ponente, una pieza de prueba por ruta, evaluada visualmente. Un caso de estudio de producción, no un benchmark de un modelo.
Mantén a la persona, cambia el mundo que la rodea
easyai.video mantiene juntos el clip de origen, la imagen de referencia, el prompt y la elección del modelo, para que el siguiente reestilizado parta de lo que ya funcionó.
Apúntate a la lista de espera ↗