
Das Videomaterial ist die häufigste Art von Material, die Creator haben: ein 48-sekündiges vertikales Selfie, das Handy in ausgestrecktem Arm, ein schlichter Raum im Hintergrund, ein fliederfarbenes T-Shirt, natürliche Gesten und Sprache auf Russisch. Das Ziel war es, dieselbe Sprecherin in ein gemütliches Wohnzimmer am Abend zu versetzen, in einem maßgeschneiderten blauen Blazer, ohne das zu verändern, was den Clip zu ihrem macht: das Gesicht, die Haare, jede Geste, die Mundbewegungen und die Stimme.
Das schließt vieles aus. Der Zuschauer blickt direkt in ein sprechendes Gesicht; schon wenige Frames, in denen der Mund nicht zu den Worten passt oder das Gesicht glattgebügelt wurde, sodass es einer anderen Person ähnelt, reichen aus, um die Aufmerksamkeit zu verlieren. Die folgenden Clips sind absichtlich ohne Ton: Die Sprache ist Russisch, und entscheidend ist hier nur das Visuelle.
Der erfolgreiche Prozess
- Wählen Sie zuerst ein kurzes Teststück. Wir schneiden fünf Sekunden (35.4–40.4 s) aus der Handydatei, konvertiert von 4K mit 120 fps zu 1080×1920 mit 30 fps, wobei der Ton beibehalten wird. Testen Sie fünf Sekunden, bevor Sie für achtundvierzig bezahlen.
- Bereiten Sie ein Referenzbild des Ziel-Looks vor. Ein einzelner Frame derselben Person, die bereits das neue Outfit und den neuen Raum trägt. Ein Bild kann sowohl die Garderobe als auch den Ort enthalten, solange der Prompt besagt, dass nichts anderes definiert wird.
- Starten Sie Seedance 2.5 im Videobearbeitungsmodus. Der Quellclip dient als Video-Referenz, das Standbild als Bild-Referenz und der Prompt ist als Bearbeitungsbefehl formuliert: was sich ändert, was das Master-Element ist und was sich nicht bewegen darf. Generierter Ton ist ausgeschaltet.
- Prüfen Sie die Länge. Unsere 5.00-sekündige Quelle ergab 4.71 Sekunden, wobei die Bewegung etwa 6% zu schnell war. Nach dem Zurückdehnen auf 5.00 s stimmten die Gesten innerhalb von zwei Frames mit der Quelle überein.
- Bringen Sie die Originalstimme zurück. Die eigene Aufnahme des Sprechers wird über das zeitlich angepasste Bild gelegt, sodass die Stimme niemals eine Rekonstruktion ist.
- Überprüfen Sie das Gesicht in voller Größe, dann die Lippen mit Ton. Schneiden Sie das Gesicht bei 1:1 gegen die Quelle zu, bevor Sie es abschließen. Overlays, Untertitel und Einblendungen werden nachträglich in der Montage hinzugefügt und niemals durch das Modell geschickt.
Benötigte Inputs
- Der Quellclip muss mindestens 4 Sekunden und darf pro Durchgang höchstens 30 Sekunden lang sein (längere Takes aufteilen).
- Ein Referenzbild des Zieloutfits und des Raums, idealerweise mit derselben Person darauf.
- Das Original-Audio, das beiseitegelegt wurde, um es später wieder auf das Ergebnis aufzulegen.
- Die gesprochene Sprache, damit die Mundbewegungen der richtigen Phonetik folgen.
- Eine einfache Liste dessen, was erhalten bleiben muss (Gesicht, Haar, Hände, Timing) und was weg muss (der alte Raum, die alte Kleidung, alles, was an der Wand steht).
Route 1: Echtes Videomaterial umgestalten
Dieser Weg bewahrt die aufgezeichnete Performance und zeichnet nur das neu, was sich ändern soll. Wir haben dies mit zwei Higgsfield-Modellen mit demselben fünfsekündigen Clip und demselben Referenz-Standbild getestet.
Quelle
Telefonaufnahme
Der Input: ein schlichter Raum, ein fliederfarbenes T-Shirt, natürliche Gesten, Handkamera-Selfie-Bewegung.
Referenz
Zielraum und Outfit
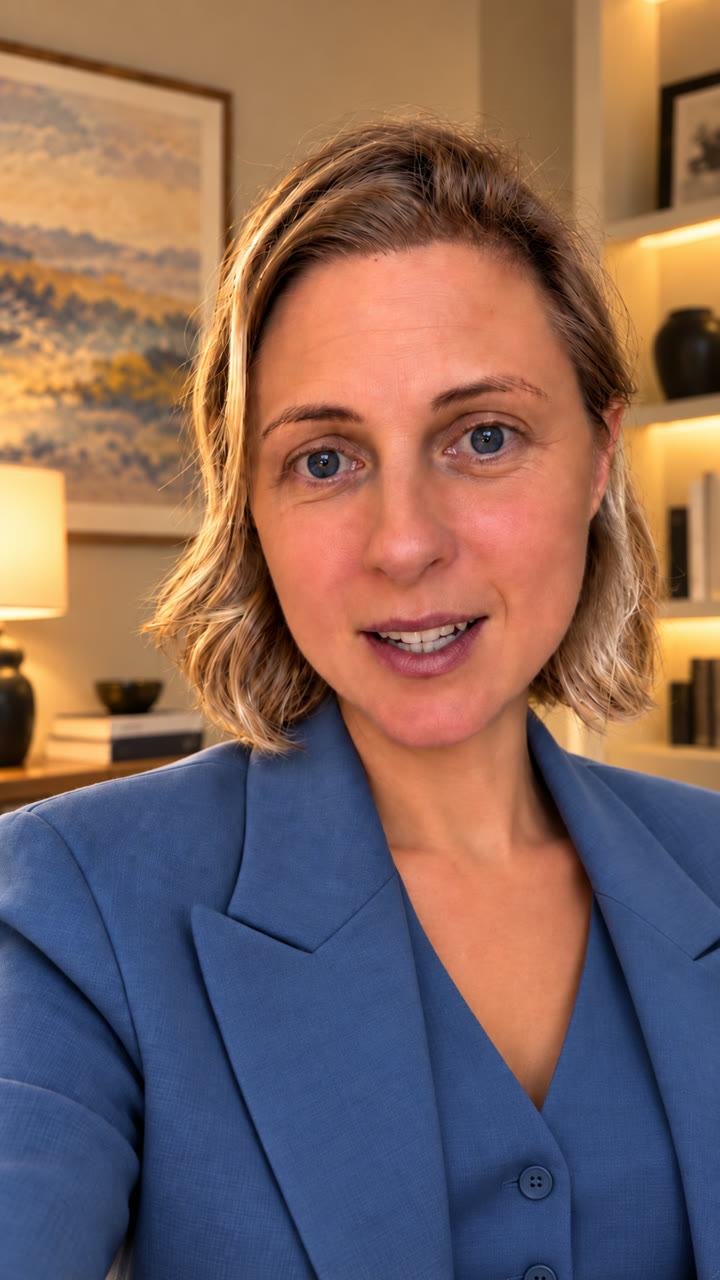
Die Referenz, die beide Takes erhalten haben: Sie definiert das Outfit und den Raum, sonst nichts.
Take A · ausgewählt
Seedance 2.5 Videoschnitt
Sowohl der Raum als auch das Outfit wurden geändert; das Gesicht behält seine Linien und Hautstruktur bei, und das Blinzeln, die Mundformen sowie die Handgesten entsprechen denen der Quelle. Wir haben das Ergebnis zeitlich angepasst, bevor wir die Originalstimme hinzugefügt haben.
Take B
Higgsfield Genjutsu
Motion Transfer kopiert die Performance präzise und fügt den Blazer hinzu, aber der alte Raum bleibt bestehen, und das Gesicht wirkt glatter und weniger wie das Original. Genjutsu benötigt keinen Prompt.
Seedance 2.5 ist das Modell, das zu verwenden ist, wenn eine reale Person im Bild bleibt. Es war das einzige, das den Raum und die Kleidung änderte, während das Gesicht auch in voller Größe erkennbar blieb. Genjutsu hat nur die halbe Arbeit geleistet und das Gesicht weichgezeichnet. Wir haben den Genjutsu-Clip zudem mit ByteDance Video Upscale von 720p auf 1080p hochskaliert: Der Upscaler erfindet Wimpern und Texturen hinzu, was bei einem Gesicht, das bereits leicht abgewichen war, das Ergebnis verschlechterte statt verbesserte. Upscaling kann ein schwächeres Modell nicht korrigieren.
Der Modus ist ebenso wichtig wie das Modell. Unsere ersten zwei Seedance 2.5 Versuche nutzten den Referenz-(Omni)-Modus mit dem angehängten Clip als Videoreferenz. Beide scheiterten nach etwa 45 Sekunden und wurden erstattet, ohne dass über die API ein Grund genannt wurde. Die Higgsfield-Webseite lieferte die Antwort: Ihr Prompt sieht wie eine Anforderung für den Videoschnitt aus. Wechseln Sie in den Video-Edit-Modus, damit das Ergebnis Ihrem Eingabevideo entspricht.
Im Video-Edit-Modus war die Aufgabe beim ersten Versuch erfolgreich. Video Edit wird nach der Länge des Quellclips abgerechnet: 38 Credits für fünf Sekunden bei 720p.
Route 2: Person ausschneiden und compositen
Der günstigere Weg zeichnet die Person nicht neu. Ein Matting-Modell ermittelt, welche Pixel zur sprechenden Person gehören; die ursprünglichen Pixel werden dann mit ffmpeg über einen neuen Hintergrund gelegt. Wir haben drei Anbieter anhand eines siebensekündigen Ausschnitts derselben Aufnahme verglichen, wobei eine Stadtansicht aus einem Fenster als neuer Hintergrund diente. Dieser Ausschnitt enthält drei kleine eingefügte Video-Overlays, wie sie im Input erschienen sind.
Quelle
Arbeitsclip
Was jeder Anbieter erhalten hat, einschließlich Overlays.
Ausschnitt 1 · Laptop
RobustVideoMatting
Kostenlos und privat, aber der alte Raum schimmert um die Haare herum durch, und die eingefügten Overlays wurden als Hintergrund behandelt und ersetzt.
Cut-out 2 · HuggingFace
BiRefNet
Kostenlos innerhalb des täglichen GPU-Kontingents. Jeder Frame wird einzeln ausgeschnitten, weshalb die Kanten von Frame zu Frame flimmern können.
Cut-out 3 · fal.ai
VEED · verfeinerte Kanten
Die sauberste der drei Varianten; die Overlays blieben erhalten, aber am Haar ist noch ein leichter Rand des alten Hintergrunds zu sehen.
| Anbieter | Modell | Zeit | Kosten | Was angezeigt wurde |
|---|---|---|---|---|
| Laptop (Intel i7, CPU) | RobustVideoMatting | 2 Min. 01 s | kostenlos | Alter Hintergrund um das Haar; Overlays wurden ersetzt |
| HuggingFace Space | BiRefNet | 3 Min. 52 s | Gratis-Kontingent | Frame-für-Frame-Kanten; Haaransatz |
| fal.ai | VEED Hintergrundentfernung | 1 Min. 16 s | $0.16 | Sauberste Version; Overlays beibehalten; leichter Haaransatz |
| Higgsfield | Video-Hintergrundentferner | nicht ausgeführt | 1 Credit | Fehler bei diesem Clip aus einer Login-Einstellung; bei einem separaten Testclip wurde die Person vor schwarzem Hintergrund ausgegeben |
Die Schwachstelle jeder Freistellung ist dieselbe: feine Haare vor einer hellen Wand. Jedes Ergebnis behält etwas vom alten Raum zwischen den Strähnen, was als Halo-Effekt gegen einen neuen Himmel wirkt. Eingefügte Overlays sind die zweite Falle: Ein Matting-Modell kennt nur die Person und alles andere, also lassen Sie Overlays aus dem Clip heraus, den Sie senden, und fügen Sie diese in der Montage wieder hinzu.
Route 3: Den Sprecher aus einem Foto regenerieren
Der dritte Weg verwirft das Videomaterial und animiert ein einzelnes Foto mit der Originalstimme. Wir haben zwei Avatar-Modellen dasselbe Standbild der Sprecherin an einem Yachthafen am See und die ersten 5.55 Sekunden ihrer aufgenommenen Sprache gegeben, endend bei einer natürlichen Pause.
Quellfoto
Porträt von Marina
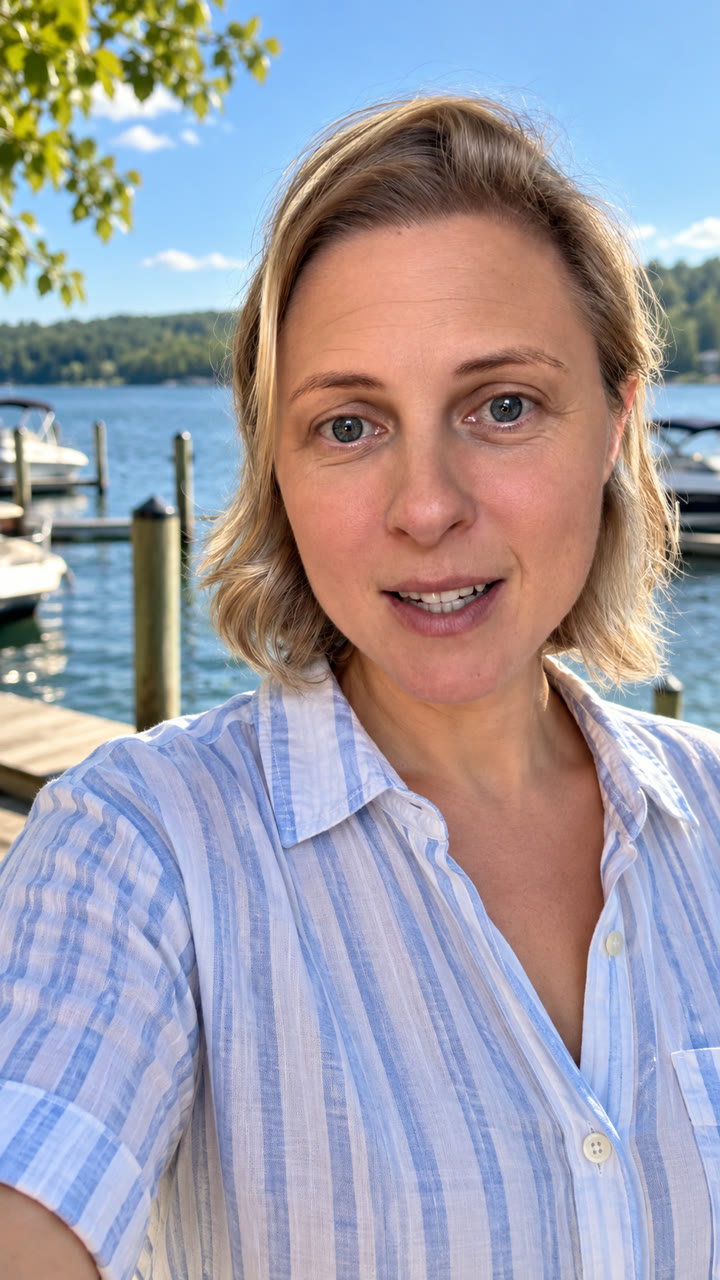
Das einzelne Foto, bei dem beide Avatar-Modelle mit der eigenen Stimme des Sprechers animiert werden.
Avatar 1
OmniHuman 1.5
Lebendige Kopf- und Mundbewegungen, aber die Haut ist geglättet und sie sieht etwas jünger aus. $0.89 auf fal, 3 Minuten.
Avatar 2
Kling AI Avatar v2 Pro
Näher am Foto, mit erhaltenen Sommersprossen und Texturen sowie einem glaubwürdigen Handkamera-Schwanken. 0.83 $ bei fal, 7 Minuten.
Beide behalten die echte Stimme bei, da nur das Gesicht dazu animiert wird. Was sie nicht beibehalten können, ist die echte Performance: Jede Geste und jede Kopfbewegung ist erfunden. Das eignet sich für eine neue Ansprache in die Kamera, aber es ist ein anderes Video, nicht das Original in einem neuen Raum.
Die Vorlage
Dies ist die vollständige Restyle-Vorlage in ihrer allgemeinsten Form: Sie kann den Raum, den Kleiderschrank und die Haare ersetzen, ausgewählte Requisiten aus der Quelle beibehalten und einen Take in mehrere Einstellungen umschneiden. Füllen Sie die Platzhalter in Klammern aus und löschen Sie alles, was für Ihre Aufgabe nicht benötigt wird. Reichen Sie dies auf Higgsfield im Seedance 2.5 Video Edit Modus ein.
- Behalten Sie das Haar des Sprechers bei: Erstellen Sie nur
@LookGarderobe. - Nichts aus dem alten Raum behalten: Die Zeile mit den Requisiten löschen.
- Eine einzige, durchgehende Aufnahme, wie zum Beispiel ein Selfie: Verwenden Sie nur eine einzige Bühne und löschen Sie die Zeilen über neue Winkel und Einstellungsgrößen.
- Handy-Aufnahmen: Ersetzen Sie die Zeile „Cinema-Kamera-Stil“ durch „fotorealistisches Handyvideo passend zur Quelle“, andernfalls wird das Ergebnis nicht zum Rest der Aufnahme passen.
- Die Originalstimme: Schalten Sie den generierten Ton aus und legen Sie die Aufnahme nachträglich wieder darüber.
| Route | Raum | Outfit | Echte Performance | Gesicht | Kosten |
|---|---|---|---|---|---|
| Seedance 2.5 Videoschnitt | neu | neu | beibehalten | nah am Quellmaterial | 38 Credits / 5 s |
| Genjutsu Motion Transfer | altes Zimmer | neu | beibehalten | geglättet | 35 Credits / 5 s |
| Genjutsu + 1080p Upscale | altes Zimmer | neu | beibehalten | schlechter als 720p | +1 Guthaben |
| Ausschneiden und Compositing | neu | alt | unberührt | unberührt; Haarfransen | kostenlos–$0.16 / 7 s |
| Foto-Avatar | aus dem Foto | aus dem Foto | erfunden | geglättet oder nah | $0.83–0.89 / 5.6 s |
Belege
- Datum
- 1–2 Oktober 2026
- Basis
- Beobachtet anhand von sieben generierten Outputs, einer Quellaufnahme, einem Referenzbild und einem Foto; Kosten aus den Higgsfield- und Fal-Abrechnungen jedes Durchlaufs
- Motiv
- Ein vertikales Selfie eines sprechenden Kopfes auf Russisch: ein 5-sekündiges Stück für Restyling und Avatare, ein 7-sekündiges Stück für Cut-outs
- Gemessen
- Raum- und Outfitwechsel, Gesichtslikeness in Originalgröße, Gestik- und Mundsynchronität zur Vorlage, Haar-Kanten, Laufzeit und Kosten
- Hinweis
- Ein Sprecher, ein Teststück pro Route, visuell beurteilt. Eine Produktions-Fallstudie, kein Modell-Benchmark.
Die Person beibehalten, die Welt um sie herum verändern
easyai.video hält den Quellclip, das Referenzbild, den Prompt und die Modellwahl zusammen, sodass das nächste Restyling direkt an das anknüpft, was bereits funktioniert hat.
Warteliste abonnieren ↗