
Цей матеріал — найпоширеніший тип контенту для творця: 48-секундне вертикальне селфі, телефон на витягнутій руці, порожня кімната на фоні, лілова футболка, природні жести та мова українською. Мета полягала в тому, щоб помістити ту саму героїню у затишну вітальню в теплий вечір, одягнувши на неї підібраний синій блейзер, не змінюючи те, що робить цей ролик її власним: обличчя, волосся, кожен жест, артикуляцію та голос.
Це відсікає багато варіантів. Глядач дивиться прямо на обличчя, що говорить, тому кількох кадрів із ротом, який не збігається зі словами, або обличчя, що стало занадто гладким чи змінило риси, достатньо, щоб втратити увагу. Наведені нижче кліпи навмисно без звуку: мова російська, а тут важливо лише те, що ви бачите.
Перевірений процес
- Спочатку оберіть короткий тестовий фрагмент. Ми вирізаємо п'ять секунд (35.4–40.4 с) із файлу з телефону, конвертованого з 4K при 120 fps у 1080×1920 при 30 fps, зі збереженням звуку. Протестуйте п'ять секунд, перш ніж оплачувати сорок вісім.
- Підготуйте одне референтне нерухоме зображення бажаного вигляду. Один кадр із тією самою людиною, яка вже одягнена в новий одяг і перебуває в новій кімнаті. Одне зображення може містити і гардероб, і локацію, якщо в промпті зазначено, що він не визначає нічого іншого.
- Запустіть Seedance 2.5 у режимі редагування відео. Вихідний кліп є відеореференсом, стоп-кадр — зображенням-референсом, а промпт написаний як команда для монтажу: що змінюється, що є основним і що не повинно рухатися. Згенерований звук вимкнено.
- Перевірте тривалість. Наш 5.00-секундний вихідний файл перетворився на 4.71 секунди, а його рух відтворився приблизно на 6% швидше. Після розтягування назад до 5.00 с жести збіглися з оригіналом із похибкою у два кадри.
- Поверніть оригінальний голос. Власне запис спікера накладається на змінений за часом відеоряд, тому голос ніколи не є реконструкцією.
- Перевірте обличчя у повному розмірі, потім губи зі звуком. Кадруйте обличчя у форматі 1:1 відносно джерела, перш ніж вважати роботу завершеною. Накладання, субтитри та вставки додаються під час монтажу вже потім, вони ніколи не проходять через модель.
Необхідні вхідні дані
- Вихідний кліп має тривати не менше 4 секунд і не більше 30 секунд за один запуск (довші дублі потрібно розділяти).
- Референтне фото цільового вбрання та приміщення, в ідеалі — з тією самою людиною.
- Оригінальне аудіо, відкладене для подальшого накладання на результат.
- Мова мовлення, щоб рухи губ відповідали правильній фонетиці.
- Простий список того, що має залишитися (обличчя, волосся, руки, таймінг), і того, що має зникнути (стара кімната, старий одяг, будь-що надруковане на стіні).
Шлях 1: зміна стилю реального відео
Цей шлях зберігає записану дію і перемальовує лише те, що має змінитися. Ми протестували це на двох моделях Higgsfield з одним і тим самим п'ятисекундним кліпом та одним і тим самим референсним стоп-кадром.
Джерело
Запис із телефону
Вхідні дані: звичайна кімната, лілоowa футболка, природні жести, рух селфі з рук.
Джерела
Цільова кімната та вбрання
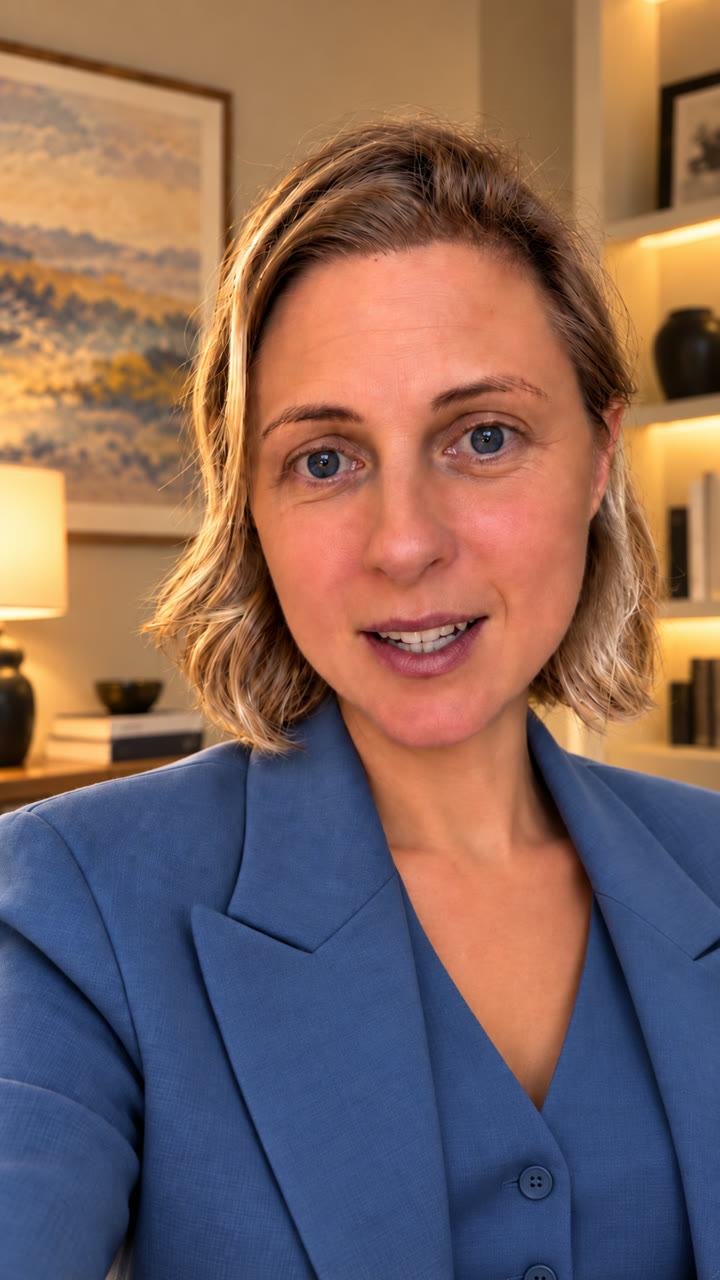
Референс, отриманий для обох дублів: він визначає лише одяг та кімнату, і нічого більше.
Дубль А · обрано
Seedance 2.5 Монтаж відео
Змінено і приміщення, і вбрання; обличчя зберігає свої риси та текстуру шкіри, а моргання, форми рота та жести рук збігаються з джерелом. Ми змінили таймінг результату перед додаванням оригінального голосу.
Дубль B
Higgsfield Genjutsu
Motion transfer точно копіює гру актора та додає блейзер, але стара кімната залишається, а обличчя виходить занадто гладким і менш схожим на оригінал. Genjutsu не потребує промптів.
Seedance 2.5 — це модель, яку слід використовувати, коли реальна людина залишається в кадрі. Це була єдина модель, яка змінила кімнату та одяг, зберігши обличчя, яке можна впізнати на повний зріст. Genjutsu зробила лише половину роботи та розмила обличчя. Ми також збільшили роздільну здатність кліпу Genjutsu з 720p до 1080p за допомогою ByteDance Video Upscale: апскейлер вигадує вії та текстуру, і на обличчі, яке вже почало змінюватися, це зробило результат гіршим, а не кращим. Апскейлінг не виправляє слабку модель.
Режим має таке ж значення, як і модель. Наші перші два дублі Seedance 2.5 використовували режим референсу (omni) із прикріпленим кліпом як відеореференсом. Обидва завершилися невдачею приблизно через 45 секунд, кошти було повернуто без пояснення причин через API. Відповідь знайшлася на вебсторінці Higgsfield: Ваш промпт схожий на запит для монтажу відео. Перейдіть у режим Video Edit, щоб результат відповідав вашому вхідному відео.
У режимі Video Edit те саме завдання було виконано з першої спроби. Video Edit тарифікується за довжиною вихідного кліпу: 38 кредитів за п'ять секунд у 720p.
Шлях 2: вирізати людину та зробити композитинг
Дешевший шлях не перемальовує людину. Модель матування визначає, які пікселі належать спікеру; потім оригінальні пікселі накладаються на новий фон за допомогою ffmpeg. Ми порівняли трьох провайдерів на семисекундному уривку одного й того самого запису, де новим фоном слугував вигляд на місто з вікна. Цей уривок містить три невеликі вставлені відеооверлеї, показані так, як вони були у вхідних даних.
Джерело
Робочий кліп
Те, що було надано кожному постачальнику, включаючи накладення.
Вирізати 1 · ноутбук
RobustVideoMatting
Безкоштовно та приватно, але навколо волосся проступає стара кімната, а вставлені оверлеї були сприйняті як фон і замінені.
Cut-out 2 · HuggingFace
BiRefNet
Безкоштовно в межах щоденної норми GPU. Кожен кадр вирізається окремо, тому краї можуть мерехтіти від кадру до кадру.
Вирізання 3 · fal.ai
VEED · досконаліші краї
Найчистіший із трьох варіантів, він зберіг накладення, проте на волоссі все ще помітна легка межа старого фону.
| Провайдер | Модель | Час | Вартість | Що з'явилося |
|---|---|---|---|---|
| Ноутбук (Intel i7, CPU) | RobustVideoMatting | 2 хв 01 с | безкоштовно | Старий фон навколо волосся; накладення замінено |
| HuggingFace Space | BiRefNet | 3 хв 52 с | безкоштовна квота | Контури по кадрах; пасма волосся |
| fal.ai | Видалення фону у VEED | 1 хв 16 с | $0.16 | Найчистіший; накладення збережено; легка пасмо волосся |
| Higgsfield | Видалення фону з відео | не запущено | 1 кредит | Помилка на цьому кліпі з налаштування входу; на окремому тестовому кліпі він повернув людину на чорному фоні |
Слабке місце кожного вирізання однакове: тонке волосся на фоні світлої стіни. У кожному результаті між пасмами залишається частина старого приміщення, що виглядає як ореол на фоні нового неба. Накладені оверлеї — це друга пастка: модель кеїнгу знає лише людину та все інше, тому не додавайте оверлеї до кліпу, який ви надсилаєте, а додавайте їх знову під час монтажу.
Шлях 3: регенерація спікера з одного фото
Третій шлях видаляє відзнятий матеріал і анімує одне фото з оригінальним голосом. Ми надали двом моделям аватара одне й те саме нерухоме фото спікера на березі марини та перші 5.55 секунд її записаної мови, що закінчується природною паузою.
Вихідне фото
Портрет Марини
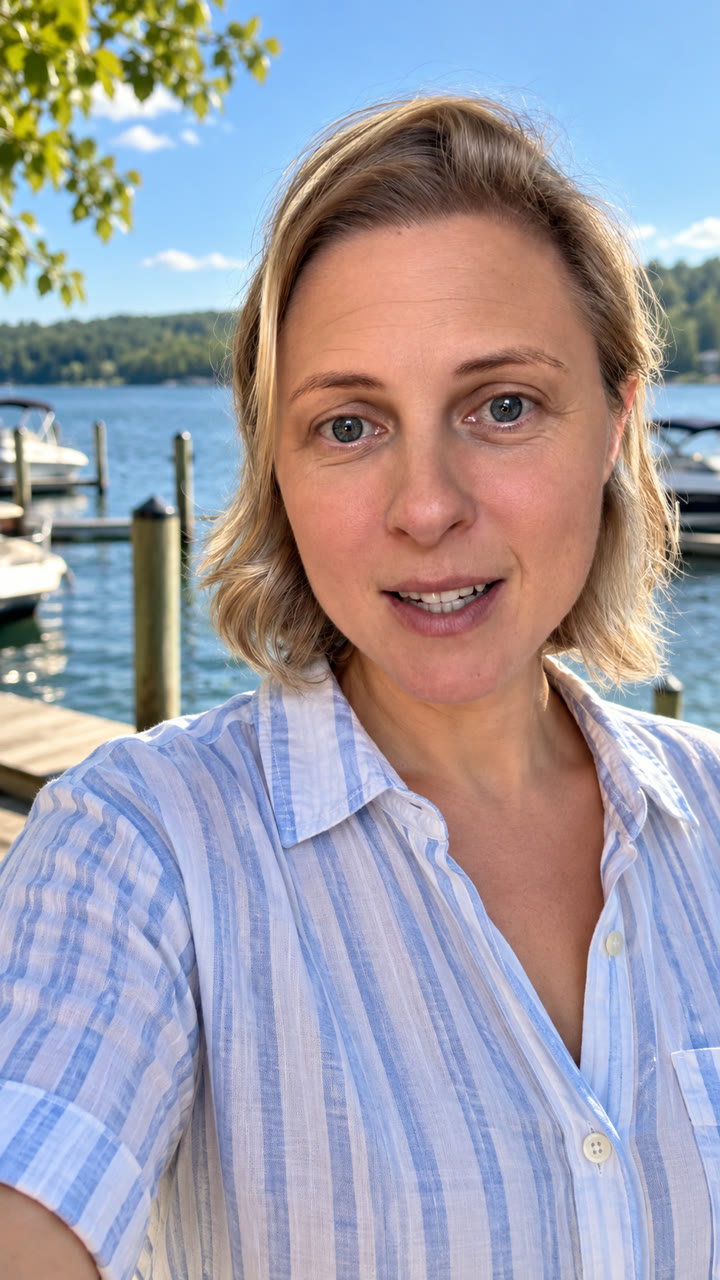
Одна фотографія, де анімовані обидві моделі аватара, з використанням власного голосу спікера.
Аватар 1
OmniHuman 1.5
Жива міміка голови та рота, але шкіра розгладжена, і вона виглядає трохи молодшою. $0.89 на fal, 3 хв.
Аватар 2
Kling AI Avatar v2 Pro
Ближче до фото, зі збереженням веснянок та текстури та реалістичним ефектом ручної камери. $0.83 на fal, 7 хв.
Обидва варіанти зберігають справжній голос, оскільки вони лише анімують обличчя під нього. Проте вони не можуть зберегти справжню гру: кожен жест і поворот голови створюються штучно. Це підходить для нового звернення до камери, але це вже інше відео, а не оригінал у новій кімнаті.
Шаблон
Це повний шаблон рестайлінгу в його найбільш загальній формі: він може замінити кімнату, гардероб та зачіску, зберегти обраний реквізит із джерела та перемонтувати один дубль у кілька планів. Заповніть поля у дужках і видаліть те, що не потрібно для вашого завдання. На Higgsfield надішліть його в режимі Seedance 2.5 Video Edit.
- Збереження власного волосся спікера: створення лише
@Lookгардероба. - Нічого не залишати зі старої кімнати: видалити рядок з реквізитом.
- Один безперервний дубль, як-от селфі: використовуйте один етап і видаліть рядки про нові ракурси та розміри кадрів.
- Зйомка на телефон: замініть рядок про стиль кінокамери на "фотореалістичне відео з телефону, що відповідає вихідному файлу", інакше результат не стикуватиметься з рештою запису.
- Оригінальний голос: вимкніть згенерований звук і накладіть запис знову після завершення.
| Маршрут | Кімната | Вбрання | Реальна продуктивність | Обличчя | Вартість |
|---|---|---|---|---|---|
| Seedance 2.5 Монтаж відео | новий | новий | збережено | найближчий до джерела | 38 кредитів / 5 с |
| Перенесення руху Genjutsu | стара кімната | новий | збережено | згладжений | 35 кредитів / 5 с |
| Genjutsu + апскейл 1080p | стара кімната | новий | збережено | гірше за 720p | +1 кредит |
| Вирізання та композитинг | новий | старий | недоторканий | не змінено; чубчик | безкоштовно — $0.16 / 7 с |
| Фотоаватар | з фото | з фото | вигадано | згладжений або близький | $0.83–0.89 / 5.6 с |
Докази
- Дата
- 1–2 жовтня 2026
- Основа
- Спостереження за сімома згенерованими результатами, одним вихідним записом, одним референсним стоп-кадром та одним фото; витрати згідно з платіжними записами Higgsfield та fal за кожен запуск
- Об'єкт
- Вертикальне селфі з людиною, що говорить російською: 5-секундний фрагмент для рестайлінгу та аватарів, 7-секундний фрагмент для вирізання об'єктів
- Виміряно
- Зміна кімнати та вбрання, схожість обличчя у повному розмірі, відповідність жестів і рухів рота джерелу, краї волосся, тривалість і вартість
- Застереження
- Один спікер, один тестовий фрагмент на кожен маршрут, оцінка візуальна. Це кейс виробництва, а не бенчмарк моделі.
Збережіть людину, змініть світ навколо неї
easyai.video зберігає вихідний кліп, референсний стоп-кадр, промпт і обрану модель разом, щоб наступний рестайлінг починався з того, що вже спрацювало.
Приєднатися до списку очікування ↗