
De beelden zijn het meest voorkomende type dat een maker heeft: een verticale selfie van 48 seconden, telefoon op armlengte, een eenvoudige kamer op de achtergrond, een lila T-shirt, natuurlijke gebaren en spraak in het Russisch. Het doel was om dezelfde spreker in een warme avondwoonkamer te plaatsen, gekleed in een op maat gemaakte blauwe blazer, zonder de essentie van de clip aan te tasten: het gezicht, het haar, elk gebaar, de mondbewegingen en de stem.
Dat sluit veel uit. De kijker kijkt recht in een gezicht dat praat, dus een paar frames waarin de mond niet matcht met de woorden, of een gezicht dat te glad is gestreken waardoor het op iemand anders lijkt, is genoeg om de aandacht te verliezen. De onderstaande clips hebben expres geen geluid: de taal is Russisch, en het gaat hier om wat je kunt zien.
Het proces dat werkte
- Kies eerst een kort testfragment. We knippen vijf seconden (35.4–40.4 s) uit het telefoonbestand, geconverteerd van 4K op 120 fps naar 1080×1920 op 30 fps, met behoud van het geluid. Test vijf seconden voordat je betaalt voor achtenveertig.
- Bereid één referentiebeeld voor van de gewenste look. Eén enkel frame van dezelfde persoon, maar dan al in de nieuwe outfit en de nieuwe kamer. Eén afbeelding kan zowel de kleding als de locatie bevatten, zolang de prompt maar aangeeft dat er niets anders wordt gedefinieerd.
- Start Seedance 2.5 in de Video Edit-modus. De bronclip is de videoreferentie, de stilstaande afbeelding is de beeldreferentie, en de prompt is geschreven als een montage-instructie: wat verandert, wat is het meesterbestand, en wat mag niet bewegen. Gegenereerd geluid staat uit.
- Controleer de lengte. Onze 5.00-seconden bron kwam uit op 4.71 seconden; de beweging speelde ongeveer 6% te snel af. Na het uitrekken naar 5.00 s, kwamen de gebaren binnen twee frames overeen met de bron.
- Breng de originele stem terug. De eigen opname van de spreker wordt over de aangepaste beelden gelegd, zodat de stem nooit een reconstructie is.
- Controleer het gezicht op volledige grootte, en daarna de lippen met geluid. Snijd het gezicht bij 1:1 tegen de bron voordat je het als klaar beschouwt. Overlays, ondertiteling en inserts worden achteraf in de montage toegevoegd en worden nooit door het model gehaald.
Benodigde inputs
- De bronclip moet minimaal 4 seconden en maximaal 30 seconden per run zijn (verdeel langere takes).
- Een referentiefoto van de beoogde outfit en kamer, bij voorkeur met dezelfde persoon erop.
- De originele audio, apart gehouden om later weer over het resultaat te leggen.
- De gesproken taal, zodat de mondbewegingen de juiste fonetiek volgen.
- Een eenvoudige lijst van wat behouden moet blijven (gezicht, haar, handen, timing) en wat weg moet (de oude kamer, de oude kleding, alles wat op de muur geprint staat).
Route 1: de echte beelden restylen
Deze route behoudt de opgenomen prestatie en tekent alleen opnieuw wat moet veranderen. We hebben dit uitgevoerd op twee Higgsfield-modellen met dezelfde clip van vijf seconden en hetzelfde referentiebeeld.
Bron
Telefoonopname
De input: een eenvoudige kamer, een lila T-shirt, natuurlijke gebaren, handgehouden selfie-beweging.
Referentie
Doelruimte en outfit
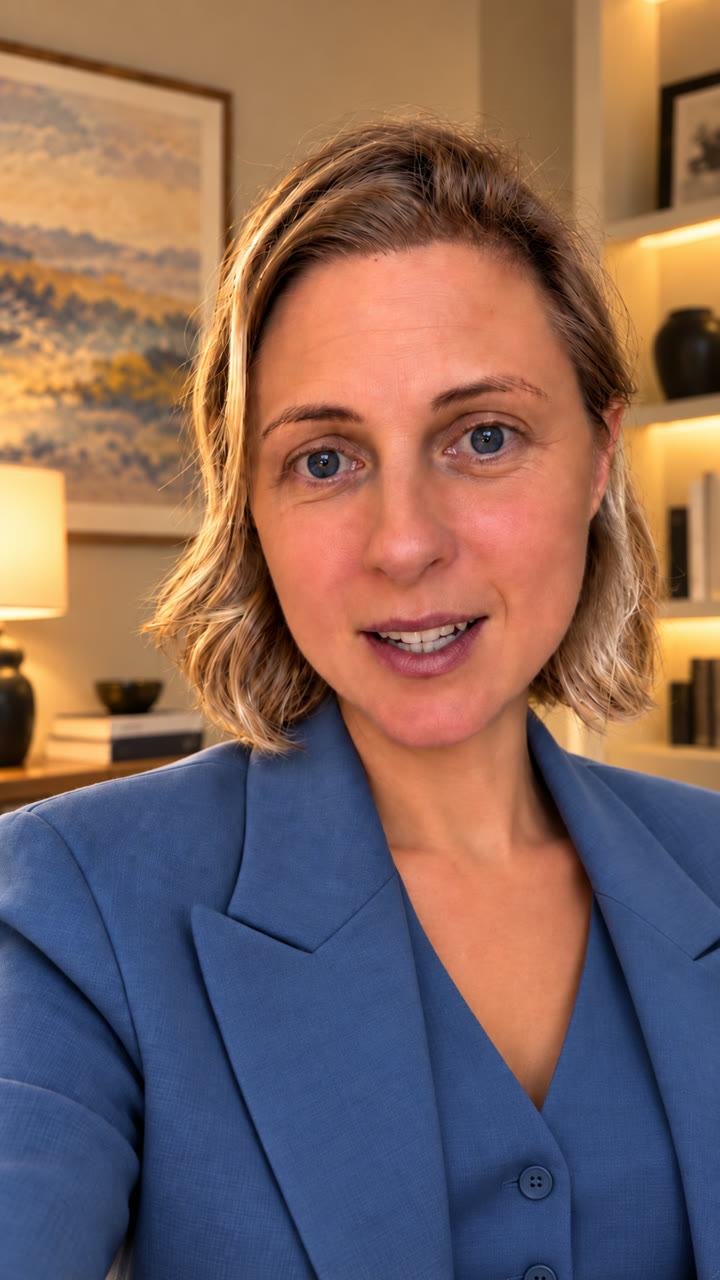
De referentie die beide takes ontvingen: deze bepaalt de outfit en de kamer, niets anders.
Take A · geselecteerd
Seedance 2.5 Videomontage
Zowel de kamer als de outfit zijn veranderd; het gezicht behoudt de lijnen en huidtextuur, en het knipperen, de mondvormen en handgebaren komen overeen met de bron. We hebben de timing van de output aangepast voordat we de originele stem toevoegden.
Take B
Higgsfield Genjutsu
Motion transfer kopieert de uitvoering nauwkeurig en voegt de blazer toe, maar de oude kamer blijft staan en het gezicht wordt gladder en lijkt minder op de bron. Genjutsu heeft geen prompt nodig.
Seedance 2.5 is het model dat je gebruikt wanneer een echt persoon in beeld blijft. Het was de enige die de kamer en de kleding veranderde, terwijl het gezicht op volledige grootte herkenbaar bleef. Genjutsu deed de helft van het werk en verzachtte het gezicht. We hebben de Genjutsu-clip ook opgeschaald van 720p naar 1080p met ByteDance Video Upscale: de upscaler verzint wimpers en texturen, en bij een gezicht dat al was afgeweken, maakte dit het resultaat slechter in plaats van beter. Upscalen repareert een zwakker model niet.
De modus is net zo belangrijk als het model. Onze eerste twee Seedance 2.5 takes gebruikten de referentie (omni) modus met de clip als videoreferentie bijgevoegd. Beide mislukten na ongeveer 45 seconden en werden terugbetaald, zonder reden via de API. De Higgsfield webpagina gaf het antwoord: Je prompt lijkt op een verzoek voor videobewerking. Schakel over naar de Video Edit-modus zodat het resultaat de inputvideo volgt.
In de Video Edit-modus lukte dezelfde opdracht bij de eerste poging. Video Edit wordt gefactureerd op basis van de lengte van de bronclip: 38 credits voor vijf seconden op 720p.
Route 2: de persoon uitknippen en compositen
De goedkopere route tekent de persoon nooit opnieuw. Een matting-model bepaalt welke pixels bij de spreker horen; de originele pixels worden vervolgens met ffmpeg over een nieuwe achtergrond gelegd. We hebben drie aanbieders vergeleken met een fragment van zeven seconden van dezelfde opname, met een stadsgezicht vanuit een raam als nieuwe achtergrond. Dit fragment bevat drie kleine ingevoegde video-overlays, zoals ze in de input verschenen.
Bron
Werkende clip
Wat elke aanbieder heeft gekregen, inclusief overlays.
Uitgesneden 1 · laptop
RobustVideoMatting
Gratis en privé, maar de oude kamer schijnt door rond het haar en de toegevoegde overlays werden als achtergrond behandeld en vervangen.
Cut-out 2 · HuggingFace
BiRefNet
Gratis binnen de dagelijkse GPU vergoeding. Elk frame wordt afzonderlijk uitgesneden, waardoor randen van frame tot frame kunnen flikkeren.
Cut-out 3 · fal.ai
VEED · verfijnde randen
De schoonste van de drie, en de overlays bleven behouden, maar er is nog een lichte rand van de oude achtergrond zichtbaar bij het haar.
| Provider | Model | Tijd | Kosten | Wat er verscheen |
|---|---|---|---|---|
| Laptop (Intel i7, CPU) | RobustVideoMatting | 2 min 01 s | gratis | Oude achtergrond rond het haar; overlays vervangen |
| HuggingFace Space | BiRefNet | 3 min 52 s | gratis quotum | Frame-voor-frame randen; haarlijn |
| fal.ai | VEED achtergrondverwijdering | 1 min 16 s | $0.16 | Schoonste; overlays behouden; lichte haarsluier |
| Higgsfield | Video achtergrond verwijderen | niet uitgevoerd | 1 credit | Lukt niet bij deze clip vanuit een login-instelling; bij een aparte testclip gaf het de persoon op zwart terug |
Het zwakke punt van elke cutout is hetzelfde: fijn haar tegen een lichte muur. Elk resultaat behoudt wat van de oude kamer tussen de haren, wat als een halo tegen een nieuwe lucht verschijnt. Toegevoegde overlays zijn de tweede valkuil: een matting-model herkent alleen de persoon en de rest niet, dus houd overlays buiten de clip die je verstuurt en voeg ze later in de montage weer toe.
Route 3: regenereer de spreker vanuit één foto
De derde route gooit de beelden weg en animeert een enkele foto met de originele stem. We gaven twee avatar-modellen dezelfde stilstaande foto van de spreker bij een jachthaven aan het meer en de eerste 5.55 seconden van haar opgenomen spraak, eindigend op een natuurlijke pauze.
Bronfoto
Portret van Marina
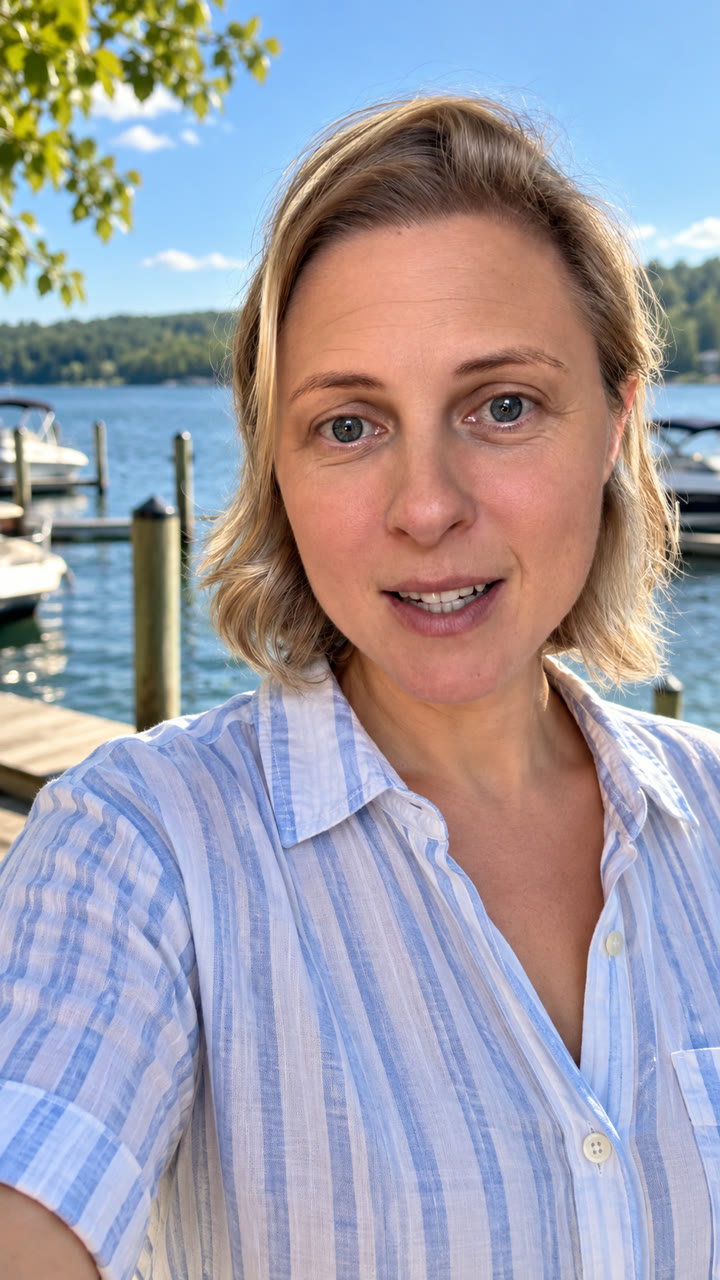
De enkele foto waarbij beide avatar-modellen geanimeerd zijn, met de eigen stem van de spreker.
Avatar 1
OmniHuman 1.5
Levendige hoofd- en mondbewegingen, maar de huid is gladgestreken en ze ziet er iets jonger uit. $0.89 op fal, 3 minuten.
Avatar 2
Kling AI Avatar v2 Pro
Dichter bij de foto, met behoud van sproeten en textuur en een geloofwaardige handgehouden beweging. $0.83 op fal, 7 minuten.
Beiden behouden de echte stem, omdat alleen het gezicht erop wordt geanimeerd. Wat ze niet kunnen behouden is de echte prestatie: elke beweging en hoofdbeweging is verzonnen. Dat past bij een nieuwe opname recht in de camera, maar het is een andere video, niet de originele in een nieuwe ruimte.
Het sjabloon
Dit is het volledige restyle-template in zijn meest algemene vorm: het kan de kamer, de kledingkast en het haar vervangen, de gekozen attributen uit de bron behouden en één take herverdelen in verschillende opnames. Vul de tekst tussen haakjes in en verwijder wat je niet nodig hebt voor je opdracht. Dien het op Higgsfield in via de Seedance 2.5 Video Edit-modus.
- Het haar van de spreker behouden: maak alleen
@Lookgarderobe. - Niets bewaren uit de oude kamer: verwijder de regel met attributen.
- Eén continue take, zoals een selfie: gebruik één fase en verwijder de regels over nieuwe hoeken en opnameformaten.
- Telefoonbeelden: vervang de regel over de cinema-camera stijl door "fotorealistische telefoonvideo die overeenkomt met de bron", anders sluit het resultaat niet aan bij de rest van de opname.
- De originele stem: schakel gegenereerd geluid uit en voeg de opname er achteraf weer aan toe.
| Route | Ruimte | Outfit | Echte prestaties | Gezicht | Kosten |
|---|---|---|---|---|---|
| Seedance 2.5 Videomontage | nieuw | nieuw | bewaard | dichtst bij de bron | 38 credits / 5 s |
| Genjutsu motion transfer | oude kamer | nieuw | bewaard | gladgestreken | 35 credits / 5 s |
| Genjutsu + 1080p upscale | oude kamer | nieuw | bewaard | slechter dan 720p | +1 credit |
| Uitsnijden en samenvoegen | nieuw | oud | onberoerd | ongerept; haarsluik | gratis–$0.16 / 7 s |
| Foto-avatar | van de foto | van de foto | uitgevonden | glad of dichtbij | $0.83–0.89 / 5.6 s |
Bewijs
- Datum
- 1–2 oktober 2026
- Basis
- Geobserveerd op basis van zeven gegenereerde outputs, één bronopname, één referentiebeeld en één foto; kosten gebaseerd op de Higgsfield en fal facturatiegegevens van elke run
- Onderwerp
- Een verticale selfie 'talking head' in het Russisch: een stuk van 5 seconden voor restyling en avatars, een stuk van 7 seconden voor uitsparingen
- Gemeten
- Verandering van kamer en outfit, gezichtslikeness op ware grootte, timing van gebaren en mond ten opzichte van de bron, haarranden, looptijd en kosten
- Kanttekening
- Eén spreker, één teststuk per route, beoordeeld op het oog. Een productie-case study, geen modelbenchmark.
Houd de persoon, verander de wereld om hen heen
easyai.video houdt de bronclip, het referentiebeeld, de prompt en de modelkeuze bij elkaar, zodat de volgende restyle start vanuit wat al werkte.
Meld je aan voor de wachtlijst ↗