
Les images sont du type le plus courant pour un créateur : un selfie vertical de 48 secondes, téléphone tenu à bout de bras, une pièce simple en arrière-plan, un t-shirt lilas, des gestes naturels et un discours en russe. L'objectif était de placer la même personne dans un salon chaleureux en soirée, portant un blazer bleu ajusté, sans modifier ce qui fait l'identité de la séquence : le visage, les cheveux, chaque geste, les mouvements de la bouche et la voix.
Cela exclut beaucoup de possibilités. Le spectateur regarde droit dans un visage qui parle ; quelques images où la bouche ne correspond pas aux mots, ou un visage lissé qui ressemble à quelqu'un d'autre, suffisent à le perdre. Les clips ci-dessous sont volontairement sans son : le discours est en russe, et ce qui importe ici, c'est ce que vous voyez.
Le processus qui a fonctionné
- Choisissez d'abord un court extrait de test. Nous coupons cinq secondes (35.4–40.4 s) du fichier mobile, converti de 4K à 120 fps en 1080×1920 à 30 fps, tout en conservant le son. Testez sur cinq secondes avant de payer pour quarante-huit.
- Préparez une image de référence pour le rendu souhaité. Une seule image de la même personne, déjà dans la nouvelle tenue et la nouvelle pièce. Une seule image peut définir à la fois la garde-robe et le lieu, tant que le prompt précise qu'elle ne définit rien d'autre.
- Lancez Seedance 2.5 en mode Montage Vidéo. Le clip source sert de référence vidéo, l'image fixe de référence image, et le prompt est rédigé comme une commande de montage : ce qui change, ce qui constitue le maître, et ce qui ne doit pas bouger. Le son généré est désactivé.
- Vérifiez la durée. Notre source de 5.00 secondes est devenue une vidéo de 4.71 secondes, avec un mouvement environ 6% plus rapide. Une fois étirée à 5.00 s, les gestes s'alignaient sur la source à deux images près.
- Réintégrez la voix originale. L'enregistrement propre de l'interlocuteur est superposé à l'image réalignée, la voix n'étant donc jamais une reconstruction.
- Vérifiez le visage en taille réelle, puis les lèvres avec le son. Recadrez le visage en 1:1 par rapport à la source avant de valider. Les superpositions, les sous-titres et les inserts sont ajoutés au montage par la suite, et ne passent jamais par le modèle.
Éléments requis
- Le clip source doit durer au moins 4 secondes et au maximum 30 secondes par exécution (divisez les prises plus longues).
- Une image de référence de la tenue et de la pièce cibles, idéalement avec la même personne.
- L'audio original, mis de côté pour être réintégré sur le résultat.
- La langue parlée, afin que les mouvements de la bouche suivent la bonne phonétique.
- Une simple liste de ce qui doit être conservé (visage, cheveux, mains, timing) et de ce qui doit disparaître (l'ancienne pièce, les anciens vêtements, tout ce qui est imprimé sur le mur).
Option 1 : restyler les images réelles
Cette méthode conserve la performance enregistrée et redessine uniquement ce qui doit changer. Nous l'avons testée sur deux modèles Higgsfield avec le même clip de cinq secondes et la même image de référence.
Source
Enregistrement de téléphone
L'entrée : une pièce simple, un t-shirt lilas, des gestes naturels, un mouvement de selfie à la main.
Référence
Décor et tenue cibles
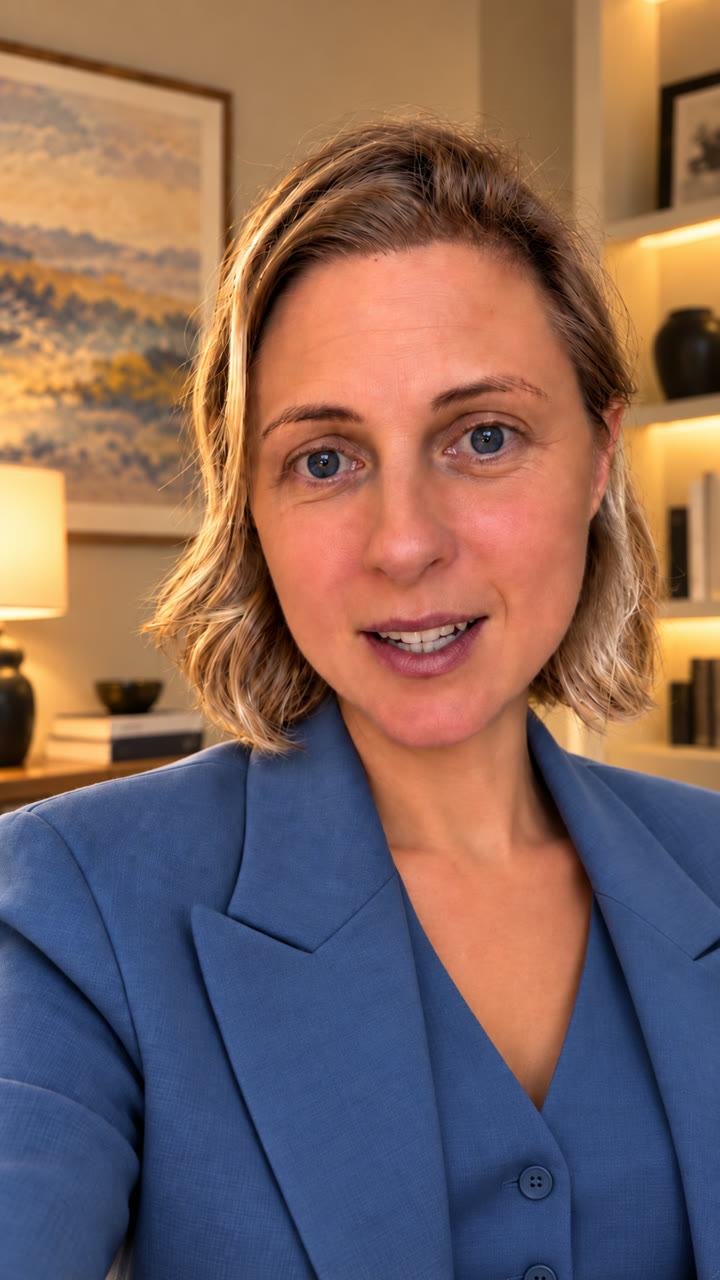
La référence reçue pour les deux prises : elle définit la tenue et la pièce, rien d'autre.
Prise A · sélectionnée
Seedance 2.5 Montage Vidéo
La pièce et la tenue ont toutes deux changé ; le visage conserve ses traits et sa texture de peau, et les clignotements, les formes de la bouche et les gestes des mains correspondent à ceux de la source. Nous avons ajusté le rythme de la sortie avant d'ajouter la voix originale.
Prise B
Higgsfield Genjutsu
Le transfert de mouvement copie fidèlement la performance et ajoute le blazer, mais l'ancienne pièce reste, et le visage ressort plus lisse et moins fidèle à la source. Genjutsu ne nécessite aucun prompt.
Seedance 2.5 est le modèle à utiliser lorsqu'une personne réelle reste dans l'image. C'était le seul capable de modifier la pièce et les vêtements tout en conservant un visage reconnaissable en plein écran. Genjutsu n'a fait que la moitié du travail et a adouci les traits du visage. Nous avons également agrandi le clip Genjutsu de 720p à 1080p avec ByteDance Video Upscale : l'upscaler invente des cils et de la texture, et sur un visage qui avait déjà dérivé, cela a rendu le résultat moins bon, et non meilleur. L'upscaling ne corrige pas un modèle trop faible.
Le mode est tout aussi important que le modèle. Nos deux premières tentatives Seedance 2.5 ont utilisé le mode référence (omni) avec le clip joint comme référence vidéo. Les deux ont échoué après environ 45 secondes et ont été remboursées, sans raison donnée via l'API. La page web de Higgsfield a apporté la réponse : Votre prompt ressemble à une demande de montage vidéo. Passez en mode « Montage Vidéo » pour que le résultat respecte votre vidéo source.
En mode Video Edit, le même travail a été réalisé dès la première tentative. Video Edit est facturé selon la durée du clip source : 38 crédits pour cinq secondes en 720p.
Route 2 : détourage et compositing
La méthode la moins coûteuse ne redessine jamais la personne. Un modèle de détourage identifie les pixels appartenant à l'intervenant ; les pixels originaux sont ensuite superposés à un nouveau décor via ffmpeg. Nous avons comparé trois prestataires sur un extrait de sept secondes de la même prise, avec une vue sur la ville depuis une fenêtre comme nouveau décor. Cet extrait contient trois petits incrustations vidéo, présentées telles qu'elles apparaissaient dans l'entrée.
Source
Clip de travail
Ce qui a été fourni à chaque prestataire, incrustations incluses.
Détourage 1 · ordinateur portable
RobustVideoMatting
Gratuit et privé, mais l'ancienne pièce transparaît autour des cheveux, et les incrustations ont été traitées comme l'arrière-plan et remplacées.
Cut-out 2 · HuggingFace
BiRefNet
Gratuit dans la limite de l'allocation quotidienne de GPU. Chaque image est détourée individuellement, ce qui peut provoquer des scintillements sur les contours d'une image à l'autre.
Détourage 3 · fal.ai
VEED · des finitions affinées
Le plus propre des trois, il a conservé les incrustations, mais un léger liseré de l'ancien arrière-plan est encore visible au niveau des cheveux.
| Fournisseur | Modèle | Temps | Coût | Ce qui est apparu |
|---|---|---|---|---|
| Ordinateur portable (Intel i7, CPU) | RobustVideoMatting | 2 min 01 s | gratuit | Ancien arrière-plan autour des cheveux ; superpositions remplacées |
| HuggingFace Space | BiRefNet | 3 min 52 s | quota gratuit | Contours image par image ; mèches de cheveux |
| fal.ai | Suppression d'arrière-plan VEED | 1 min 16 s | $0.16 | Le plus propre ; superpositions conservées ; légère frange de cheveux |
| Higgsfield | Suppresseur d'arrière-plan vidéo | non exécuté | 1 crédit | Échec sur ce clip provenant d'un paramètre de connexion ; sur un clip de test distinct, il a affiché la personne sur fond noir |
Le point faible de chaque détourage est le même : les cheveux fins sur un mur clair. Chaque résultat conserve des éléments de l'ancienne pièce entre les mèches, ce qui crée un effet de halo sur le nouveau ciel. Les incrustations sont le second piège : un modèle de détourage ne reconnaît que la personne et tout le reste, alors évitez les incrustations dans le clip envoyé et réintégrez-les lors du montage.
Route 3 : régénérer l'interlocuteur à partir d'une seule photo
La troisième option supprime les images et anime une seule photo avec la voix originale. Nous avons donné à deux modèles d'avatars la même image fixe de l'intervenante dans une marina au bord d'un lac et les 5.55 premières secondes de son discours enregistré, se terminant sur une pause naturelle.
Photo source
Portrait de Marina
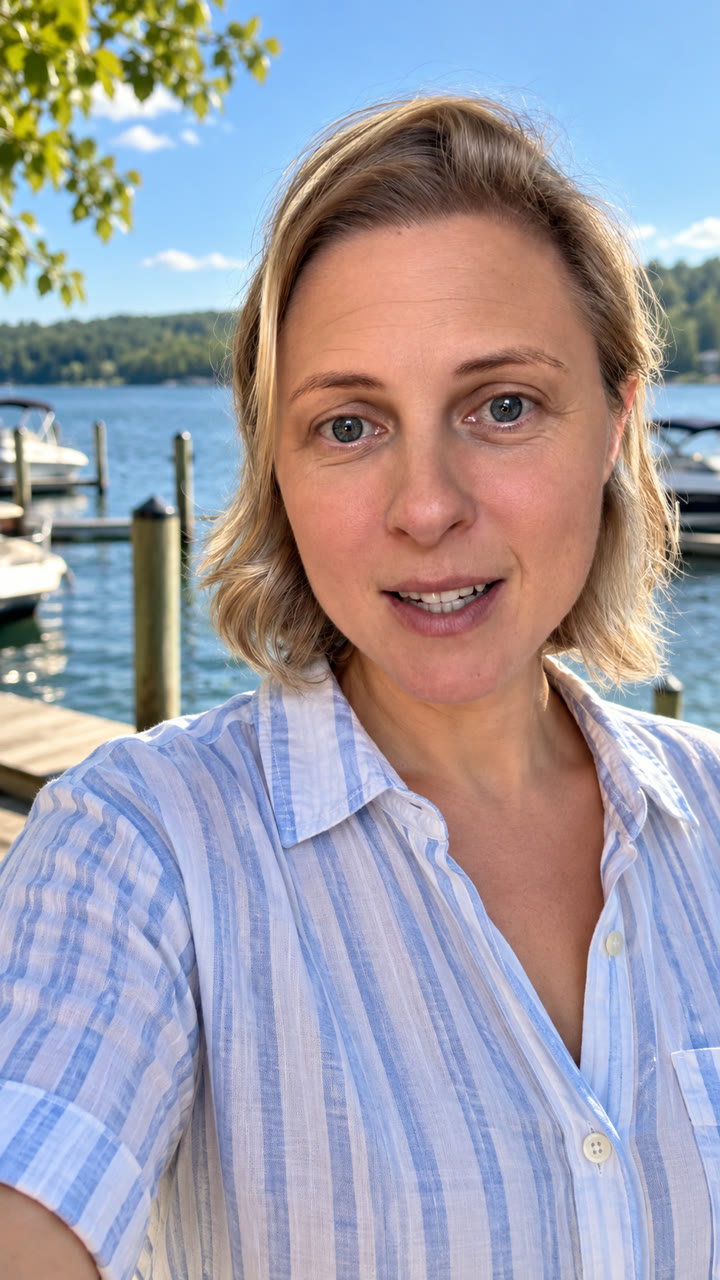
La photo unique anime les deux modèles d'avatar, avec la propre voix de l'intervenant.
Avatar 1
OmniHuman 1.5
Mouvements de tête et de bouche dynamiques, mais la peau est lissée et elle paraît légèrement plus jeune. 0.89 sur fal, 3 minutes.
Avatar 2
Kling AI Avatar v2 Pro
Plus proche de la photo, avec conservation des taches de rousseur et de la texture, et un mouvement caméra à l'épaule crédible. 0.83$ sur fal, 7 minutes.
Les deux conservent la voix réelle, car ils n'animent que le visage en fonction de celle-ci. Ce qu'ils ne peuvent pas conserver, c'est la performance réelle : chaque geste et chaque mouvement de tête est inventé. Cela convient pour une nouvelle prise de vue face caméra, mais il s'agit d'une vidéo différente, et non de l'originale filmée dans une nouvelle pièce.
Le modèle
Voici le modèle de restylage complet dans sa forme la plus générale : il peut remplacer la pièce, la garde-robe et la chevelure, conserver les accessoires choisis de la source, et transformer une prise en plusieurs plans. Remplissez les champs entre crochets et supprimez ce dont votre projet n'a pas besoin. Sur Higgsfield, soumettez-le en mode Seedance 2.5 Video Edit.
- Conserver les cheveux de l'intervenant : créer
@Lookuniquement pour la garde-robe. - Rien à conserver de l'ancienne pièce : supprimez la ligne des accessoires.
- Une seule prise continue, comme un selfie : utilisez un seul étage, et supprimez les lignes concernant les nouveaux angles et les tailles de plans.
- Images de téléphone : remplacez la mention de style caméra cinéma par "vidéo de téléphone photoréaliste correspondant à la source", sinon le résultat ne s'intégrera pas au montage avec le reste de l'enregistrement.
- La voix originale : désactivez le son généré et superposez l'enregistrement par la suite.
| Itinéraire | Pièce | Tenue | Performances réelles | Visage | Coût |
|---|---|---|---|---|---|
| Seedance 2.5 Montage Vidéo | nouveau | nouveau | conservé | au plus proche de la source | 38 crédits / 5 s |
| Transfert de mouvement Genjutsu | vieille pièce | nouveau | conservé | lissé | 35 crédits / 5 s |
| Genjutsu + upscale 1080p | vieille pièce | nouveau | conservé | moins bien que 720p | +1 crédit |
| Détourage et compositing | nouveau | ancien | intact | intact ; frange | gratuit–$0.16 / 7 s |
| Avatar photo | à partir de la photo | à partir de la photo | inventé | lissé ou proche | $0.83–0.89 / 5.6 s |
Preuves
- Date
- 1–2 octobre 2026
- Base
- Observé à partir de sept sorties générées, un enregistrement source, une image de référence et une photo ; coûts basés sur les relevés de facturation Higgsfield et Fal de chaque exécution
- Sujet
- Un selfie vertical face caméra en russe : une séquence de 5 secondes pour le restylage et les avatars, une séquence de 7 secondes pour les détourages
- Mesuré
- Changement de décor et de tenue, ressemblance du visage à taille réelle, synchronisation des gestes et de la bouche par rapport à la source, contours des cheveux, durée et coût
- Avertissement
- Un intervenant, une pièce de test par itinéraire, évaluée à l'œil nu. Une étude de cas de production, pas un benchmark de modèle.
Conservez la personne, changez le monde autour d'elle
easyai.video conserve le clip source, l'image de référence, le prompt et le choix du modèle, afin que la prochaine restylisation reparte de ce qui a déjà fonctionné.
Rejoignez la liste d'attente ↗