Pourquoi le bon modèle d'IA et des compétences spécialisées permettent de réussir le plan
Une courte scène comique dans une maison de poupée miniature, testée sur plusieurs flux de travail : des images dans un chat et avec un flux de montage, de la vidéo avec Google Flow, Seedance 2.5, Wan 3.0 et MiniMax H3. Ce qui a échoué, ce qui l'a corrigé, et chaque prompt.
Publié le 15 octobre 20267 générations vidéo comparées10 min de lecture
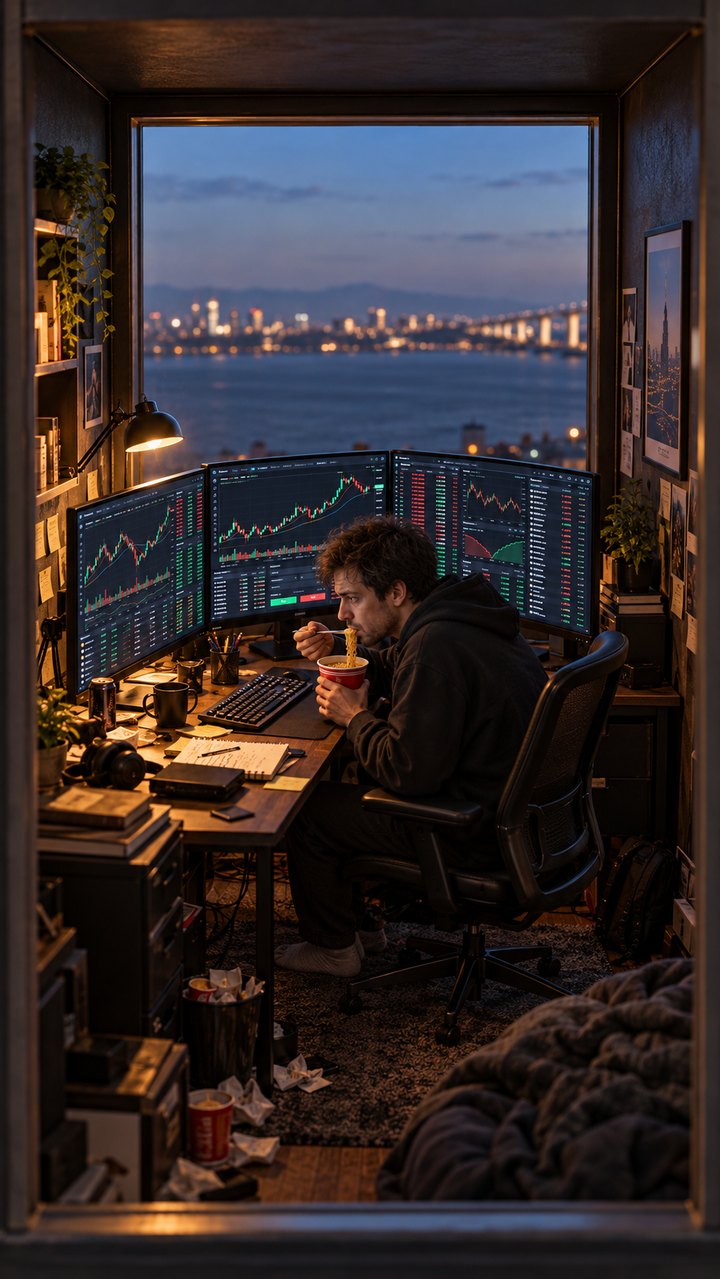
L'objectif était de réaliser un seul plan dans une pièce spécifique d'une maison de poupée photoréaliste, se terminant par un mouvement de caméra vers la pièce suivante. La séquence dure environ neuf secondes. Un minuscule trader mange des nouilles devant trois moniteurs. Un homme géant, moi, l'observe par la fenêtre arrière. Le trader s'exclame « Laisse-moi tranquille ! » et lance quelque chose contre la vitre. Le géant dit « Pardon ! », et la caméra glisse vers la salle de yoga voisine, où une femme garde les yeux fixés sur sa tablette.
Le court plan original semblait simple, mais s'est avéré complexe à chaque étape de la production : deux personnages qui parlent avec synchronisation labiale, un lancer avec une physique réelle, un mouvement de caméra continu entre deux pièces et un visage imposant qui occupe l'image pendant plusieurs secondes. Voici les résultats, côte à côte, avec les prompts.
Le plan : d'abord trois images
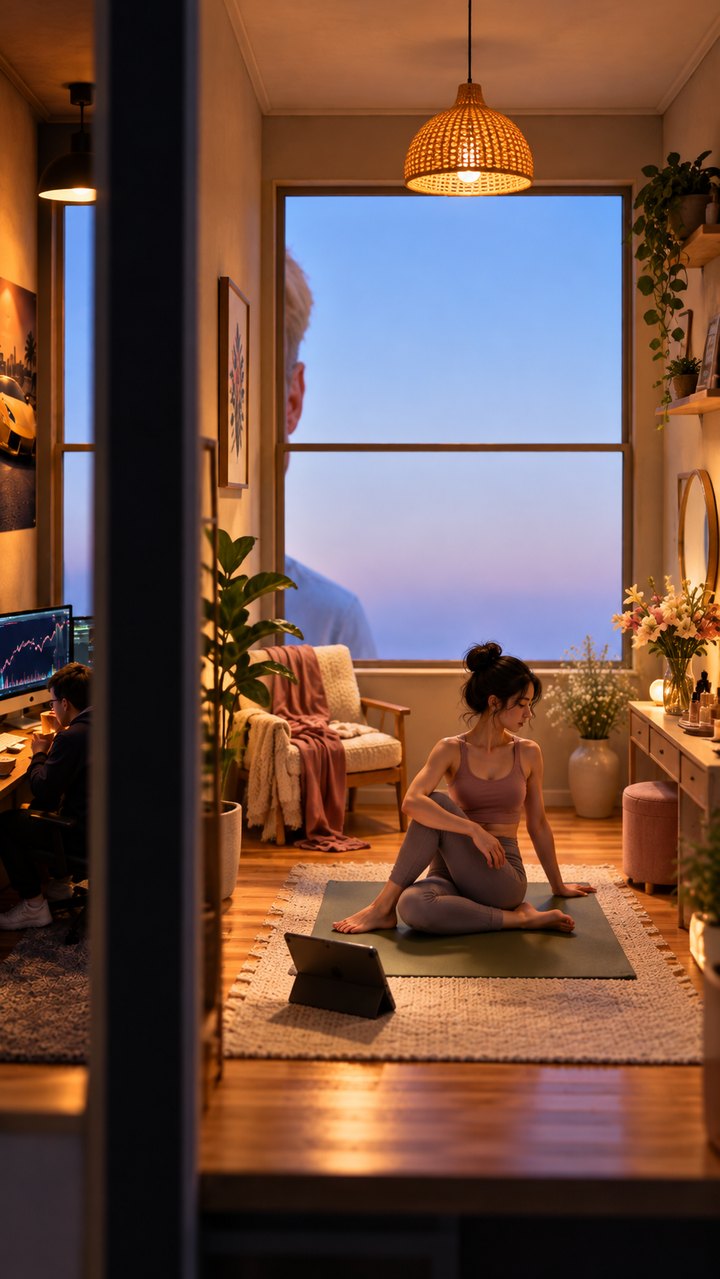
La méthode consistait à approuver les images clés avant de générer toute vidéo : l'ouverture de la chambre du trader, le géant qui l'observe, et l'image de fin dans la salle de yoga.
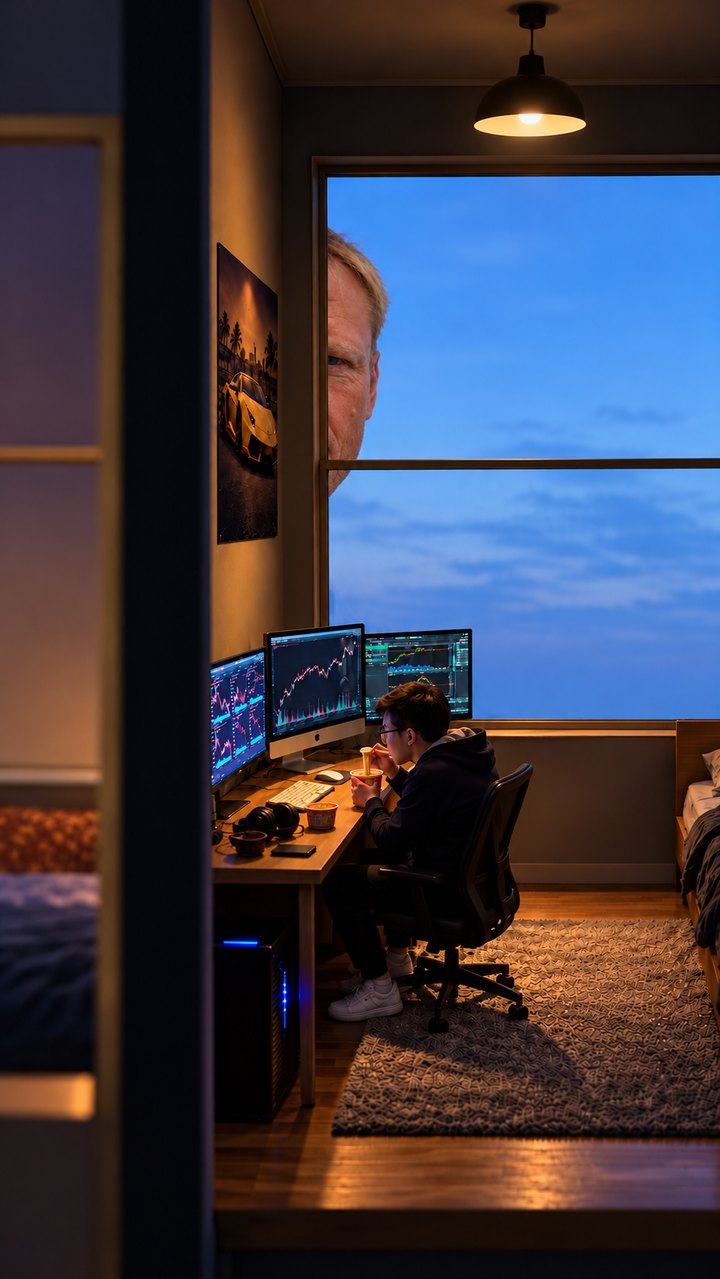
Début
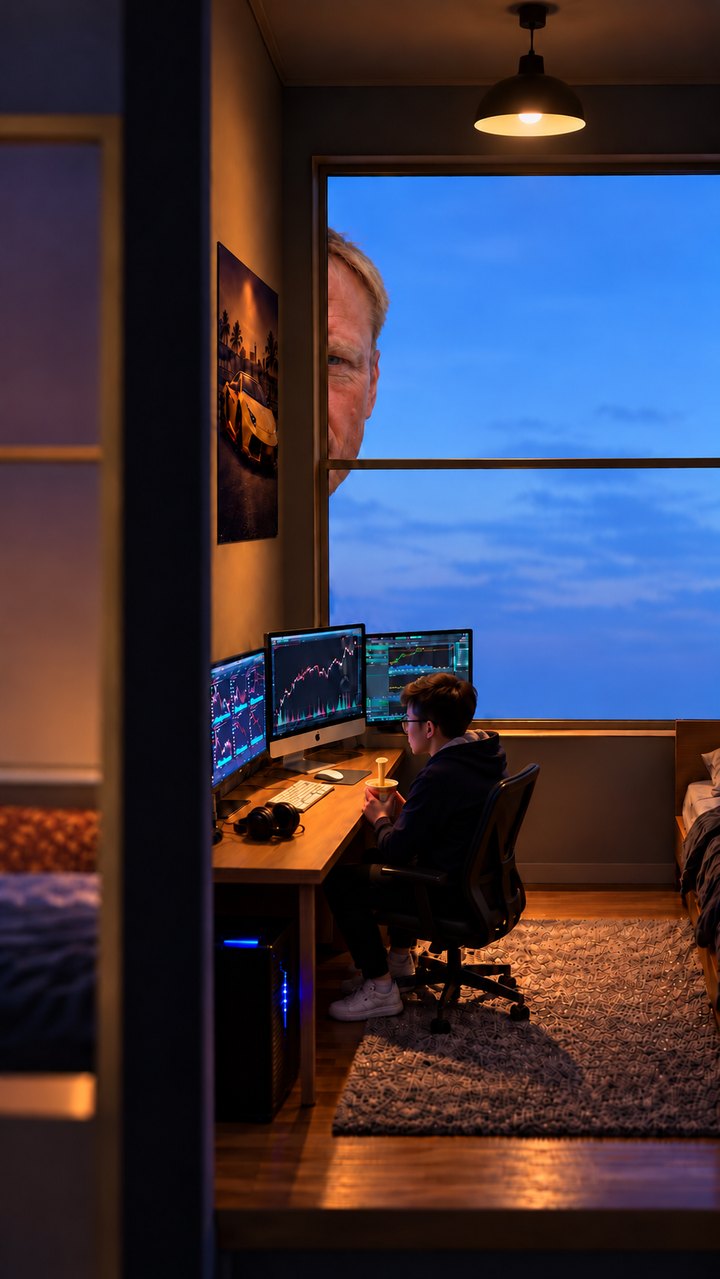
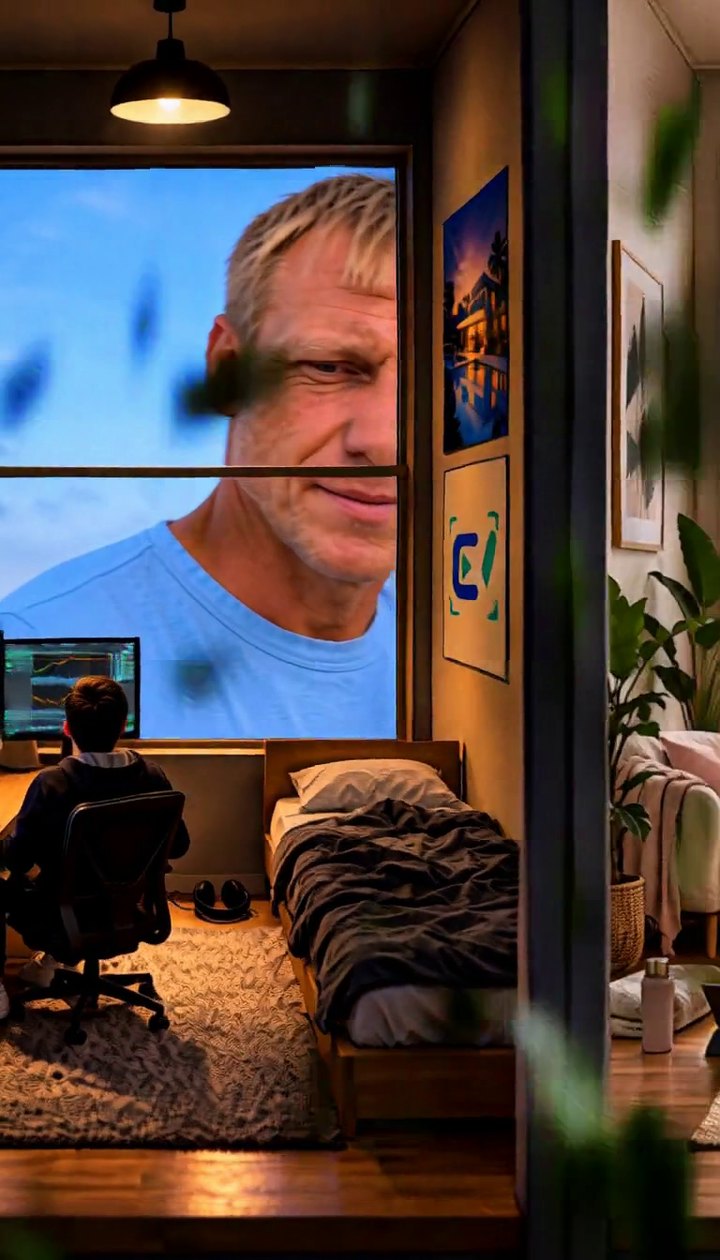
La chambre du trader
Un fragment de la pièce précédente, la cloison, et seulement le bord du visage du géant.
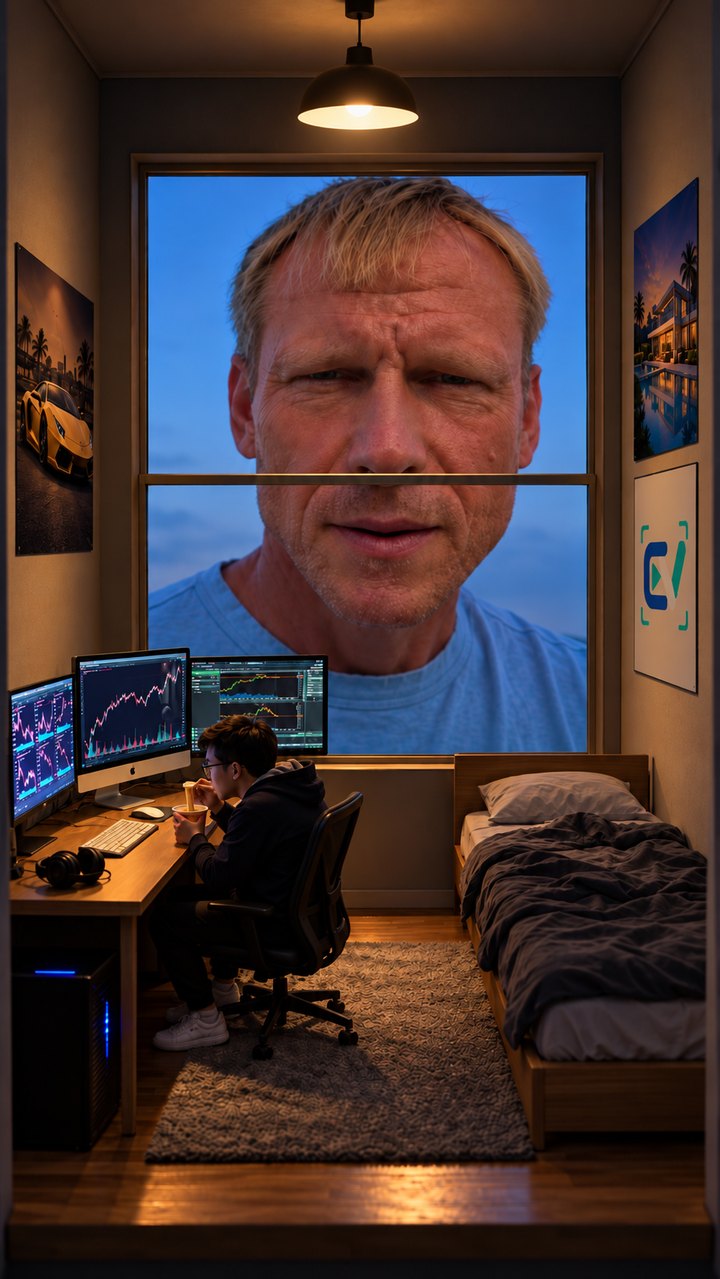
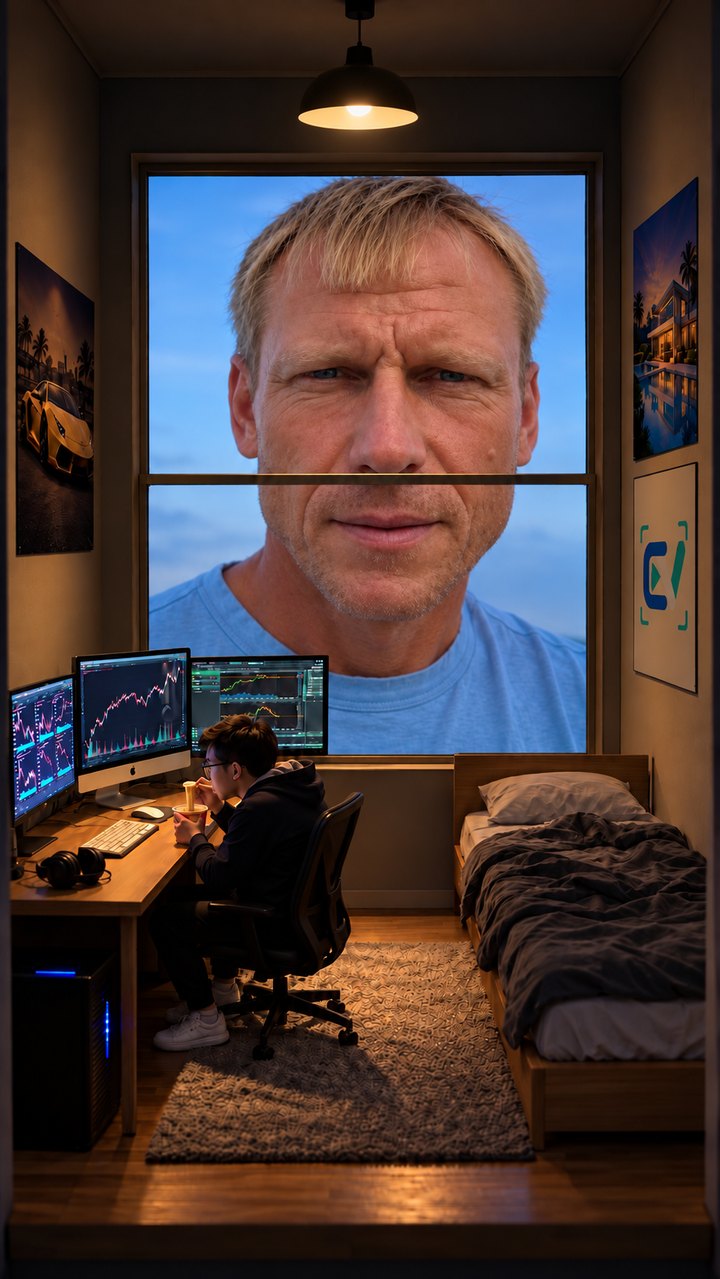
Milieu
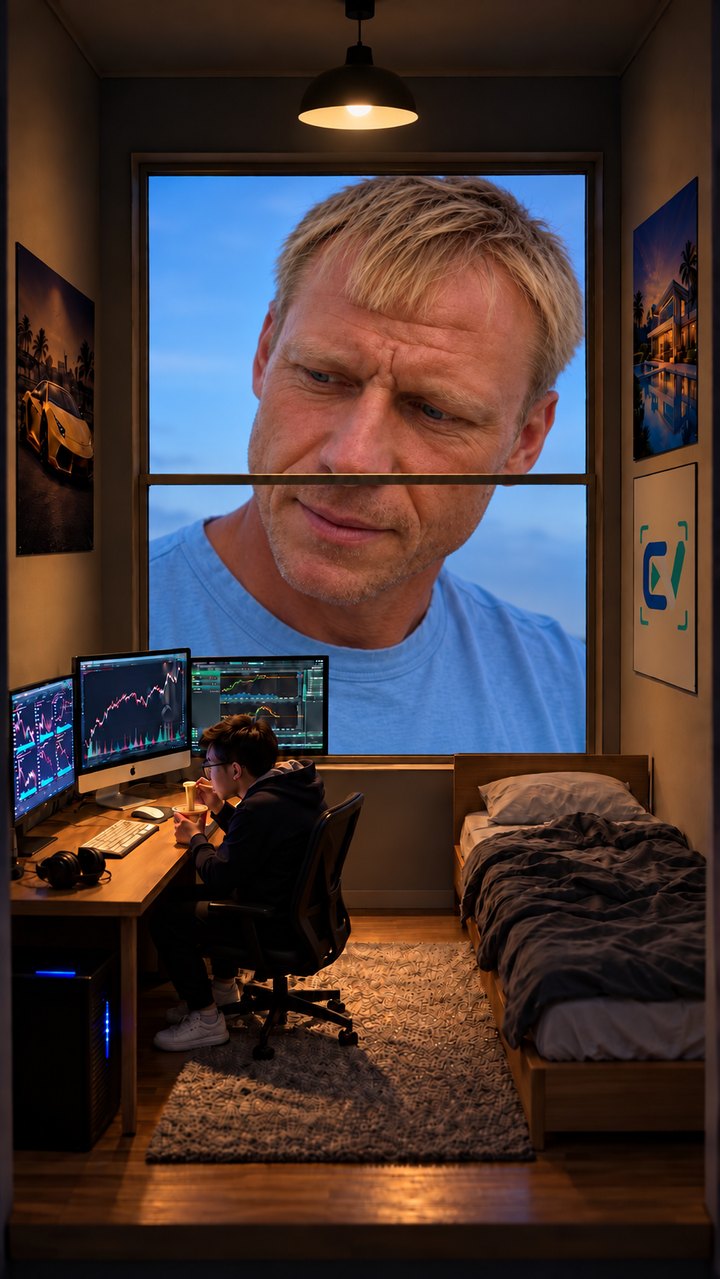
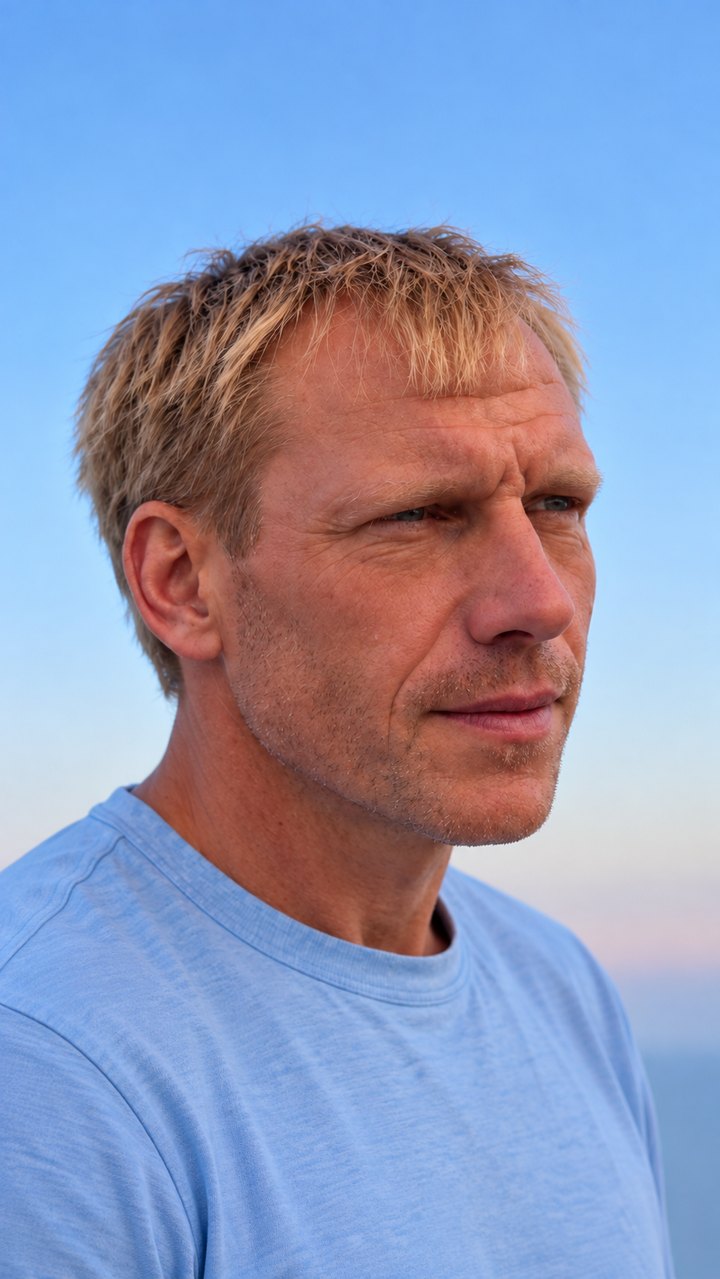
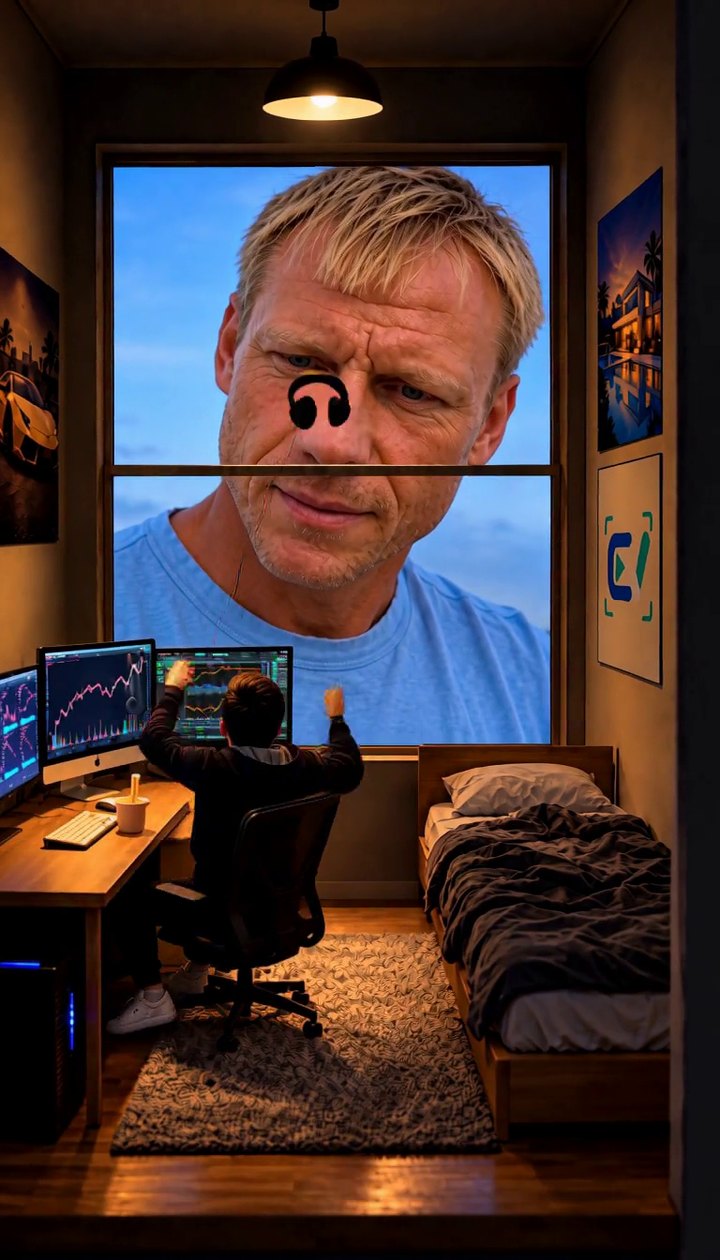
Le géant observe
Son visage remplit la fenêtre, les yeux fixés sur le trader. Cette image deviendra plus tard le point de montage commun.
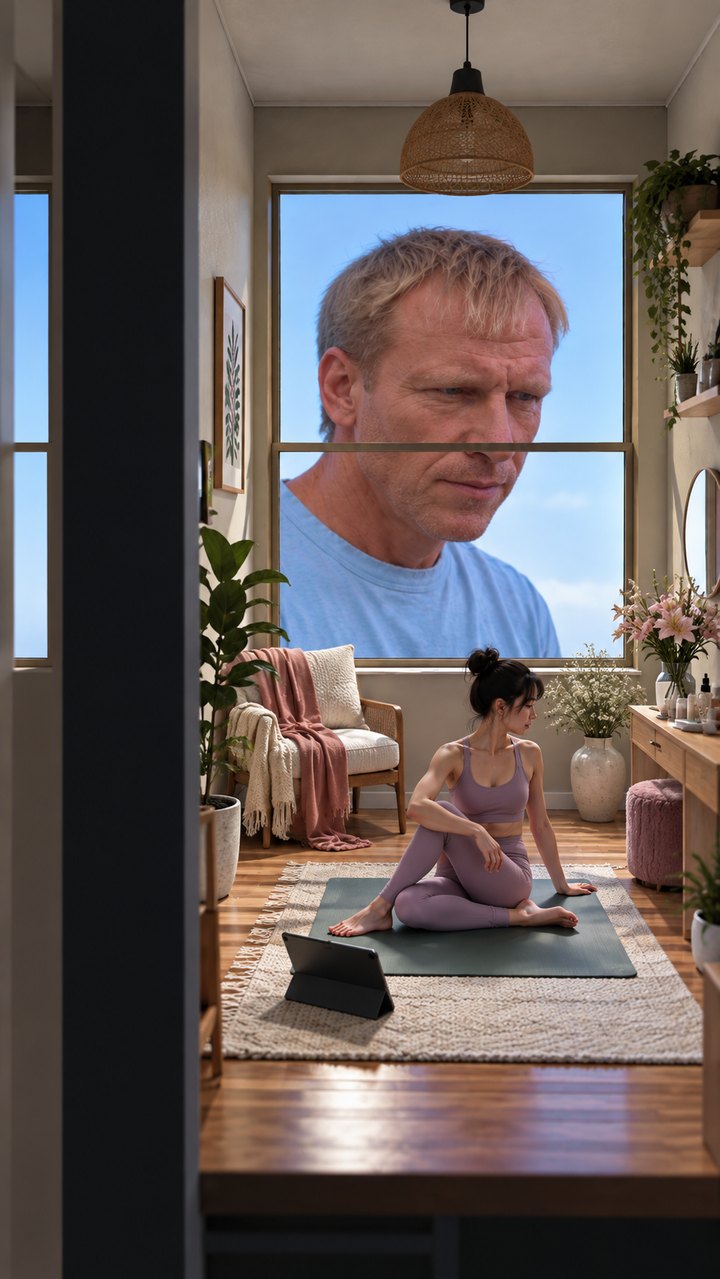
Fin
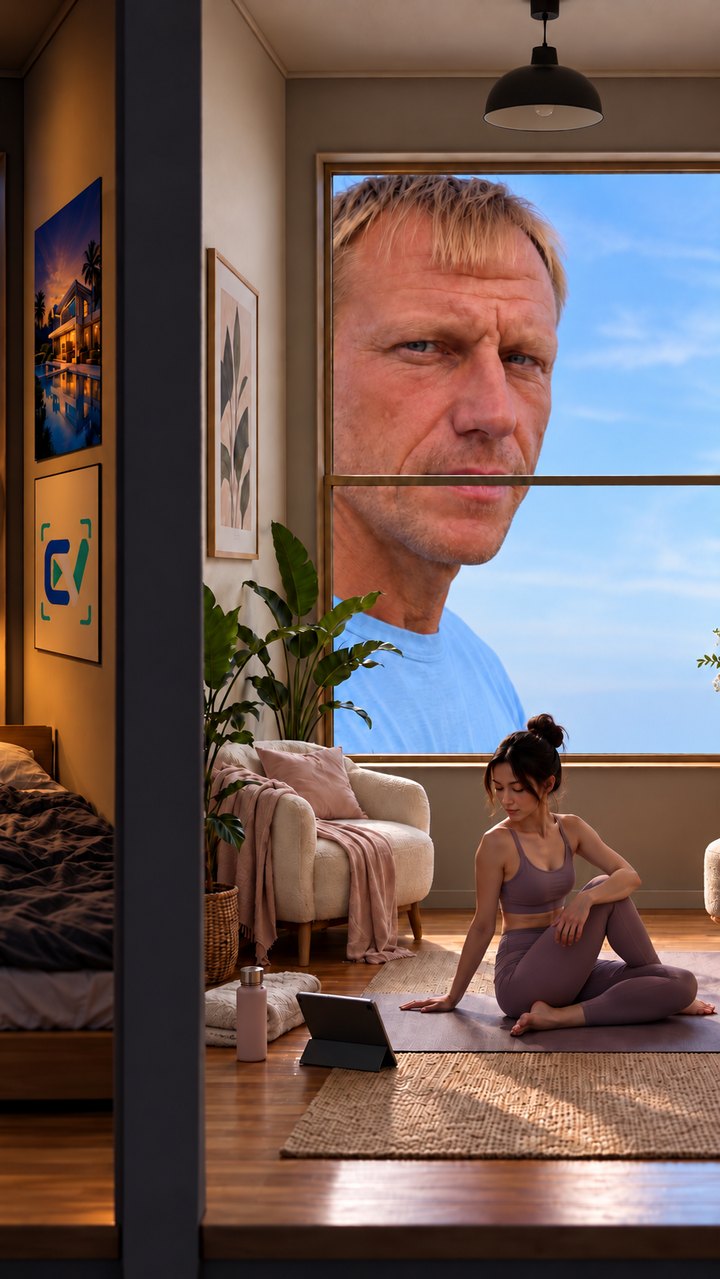
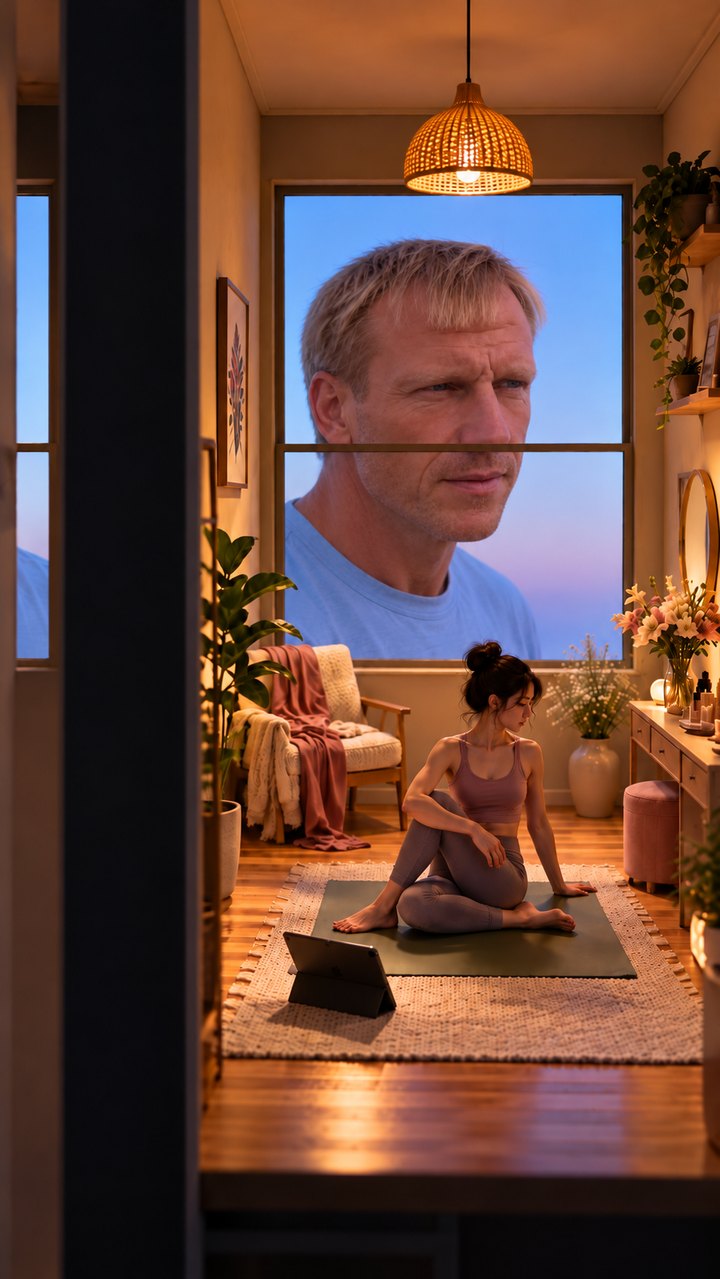
La salle de yoga
Même taille de fenêtre, même hauteur de sol et même échelle de visage, une pièce vers la droite.
Images, tour 1 : 33 images dans un chat ChatGPT
La première tentative était une conversation ChatGPT ordinaire sur un forfait Plus : décrire la pièce, joindre une photo de mon visage, demander des modifications. Cela m'a pris 26 messages et a produit 33 images, et environ 18 de mes messages étaient des corrections. Chaque réponse reconstruisait la scène de zéro, donc corriger un élément en brisait un autre.
Pas de moniteurs, pas de trader.Trop désordonné, et le géant est absent.Le trader de l'ancienne pièce est toujours dans l'image.« Une personne totalement différente. »Moi, divisé entre deux fenêtres.Fenêtre à 78% de la taille demandée.
Vers la fin, j'ai donné la géométrie de pixels exacte pour la fenêtre et les deux personnes, et j'ai demandé au chat de mesurer son propre résultat. Il a rapporté une fenêtre de 485 × 644 px par rapport aux 621 × 811 px du prompt : 136 px trop étroite et 167 px trop courte. Un modèle qui redessine une image à partir de mots ne peut pas atteindre des nombres de pixels précis, aussi précis que soient les mots.
Images, tour 2 : 11 images, principalement du premier essai
Le second tour a démarré à partir de la meilleure image du tour 1 et s'est déroulé en Codex connecté à la plateforme easyai.video, avec nos compétences d'image installées. Huit requêtes ont produit onze images. Six des huit requêtes étaient de nouveaux changements, chacun approuvé dès le premier essai ; les deux autres étaient des corrections, pour la position du mur et la hauteur du sol.
Début : la meilleure image du tour 1.1 · une seule source de lumière, visage plus net.2 · focus sur le trader.3 · le mur entre les pièces.4 · la salle de yoga.
Rien de magique n'a changé entre les sessions. C'est la manière de demander qui a changé :
Modifiez, ne régénérez pas. Chaque requête est partie de la dernière image approuvée en conservant tout ce qui était déjà correct.
Un seul changement par requête. La lumière, puis le visage, puis le regard, puis la disposition. Jamais quatre corrections en un seul message.
Un seul travail par image source. « L'image 1 est la cible d'édition faisant foi. L'image 2 ne fournit que la bande de gauche. »
Mesurez, puis ancrez. Au lieu de « rendre la pièce plus étroite », le prompt indiquait où se trouvaient les éléments dans la source et où ils devaient aller : déplacez la pièce de 275 px vers la droite à une échelle de ⪀ 100%, la traverse de la fenêtre reste à y = 626.
Utilisez une compétence, pas de l'improvisation. Les compétences d'image nommaient le cas d'usage (compositing, conservation d'identité) et rédigeaient le prompt avec la même structure à chaque fois.
Vous pouvez procéder de la même manière dans votre propre configuration. Codex et Claude Code chargent tous deux des compétences : un dossier d'instructions et, facultativement, des scripts, que l'agent lit avant d'agir. Une large gamme de compétences d'image et de vidéo est disponible sur GitHub et d'autres ressources publiques. Choisissez les compétences adaptées à votre modèle et à votre tâche de montage, et utilisez-les pour améliorer automatiquement vos prompts. La plateforme easyai.video inclut ces compétences, ainsi que les formats de prompt attendus par chaque modèle vidéo.
Vidéo, prise 1 : toute la scène en un seul plan de 8 seconde
Une fois les trois images approuvées, les premières tentatives vidéo demandaient tout en une seule génération : manger, remarquer, crier, jeter, s'excuser, glisser vers la pièce suivante. Pour l'expérience, j'ai commencé avec des générations Google Flow gratuites. Google Flow a utilisé les trois images comme références ; la prise 2 a utilisé un prompt réécrit nommant l'interlocuteur de chaque réplique et traçant la tasse jusqu'à la fenêtre arrière. Seedance 2.5 a utilisé les images comme image de début, référence d'image et image de fin, dans son mode omni-référence.
Prise 1
Google Flow
Commence sur notre image, puis le géant prononce les deux répliques, avant que quoi que ce soit ne soit lancé. La tasse vole vers la caméra, pas vers la fenêtre, et le trader garde sa propre tasse. La salle de yoga apparaît par substitution au lieu de glisser.
Prise 2
Google Flow
Notre première image est ignorée : une porte voûtée et une pièce plus claire. Deux géants apparaissent, puis un homme de taille normale entre et lance la tasse. Personne ne dit « Pardon ». Cela se termine dans une salle de yoga différente.
Prise 3
Seedance 2.5 · brouillon 480p
Le plus proche des trois : la tasse s'envole vers nous et éclate sur la vitre arrière, tandis que la caméra glisse vers la salle de yoga. Rendu sous forme de brouillon 480p.
Les images n'étaient pas le problème. Le plan demandait trop de choses à la fois, et le modèle en a ignoré certaines et en a réordonné d'autres.
Vidéo, prise 2 : deux plans courts à travers une image commune
La solution a consisté à diviser la scène là où elle se rompt naturellement. Le plan A s'étend de l'image initiale à l'image centrale en 3 secondes : le trader mange et le géant surgit dans la fenêtre. Le plan B s'étend de cette même image centrale à l'image finale en 6 secondes : la ligne, le lancer, l'excuse et le passage vers la salle de yoga. Les deux plans partagent une image, ce qui leur donne une composition commune au montage. Dans cette version, le trader lance son casque au lieu du bol de nouilles : les éclaboussures de nouilles sur la fenêtre étaient désagréables à regarder, et Seedance les dessinait bien trop grandes.
Les deux plans ont été réalisés avec Wan 3.0 sur Higgsfield, en résolution native 1080 × 1920 à 30 fps avec son généré.
Plan A · 3 s
Wan 3.0
Le trader continue de manger sans jamais lever les yeux ; le géant glisse et se stabilise sur l'image centrale.
Plan B · 6 s
Wan 3.0
« Laisse-moi tranquille ! », le casque frappe la vitre et tombe, « Désolé. », puis le glissement vers la salle de yoga, s'arrêtant sur l'image finale. Cela a ajouté quelques notes de musique à la fin, ce que le prompt avait pourtant exclu.
A + B · 9 s
Jointes à l'image partagée
Le visage présente une texture de peau légèrement différente dans la seconde partie, rendant la raccord visible. Un modèle capable de générer un plan unique et ininterrompu, comme Seedance, est préférable pour la continuité.
Le même plan sur MiniMax H3 : modèle complet vs turbo
Nous avons ensuite rendu le plan B à nouveau sur MiniMax H3, sur notre propre copie du modèle via le quota GPU quotidien de Hugging Face, avec les deux mêmes images, la même histoire et la même graine (42). La plateforme easyai.video réécrit d'abord le prompt au format attendu par H3 ; le prompt ci-dessous est ce qui a été envoyé au modèle après cette réécriture.
Plan B · Wan 3.0
1080 × 1920 · 30 ips
La référence : chaque mouvement dans l'ordre, aboutissant à l'image finale.
Plan B · H3 complet
768 × 1344 · 24 fps · 28 étapes
Comparable à Wan 3.0 sur ce plan : la réplique, le jet, l'excuse et le mouvement sont tous respectés. Résolution inférieure ; utilise une partie du quota GPU quotidien.
Plan B · H3 turbo
768 × 1344 · 24 fps · 6 étapes
Respecte les étapes du récit, mais le visage large, le casque et le mouvement entre les pièces trahissent l'IA.
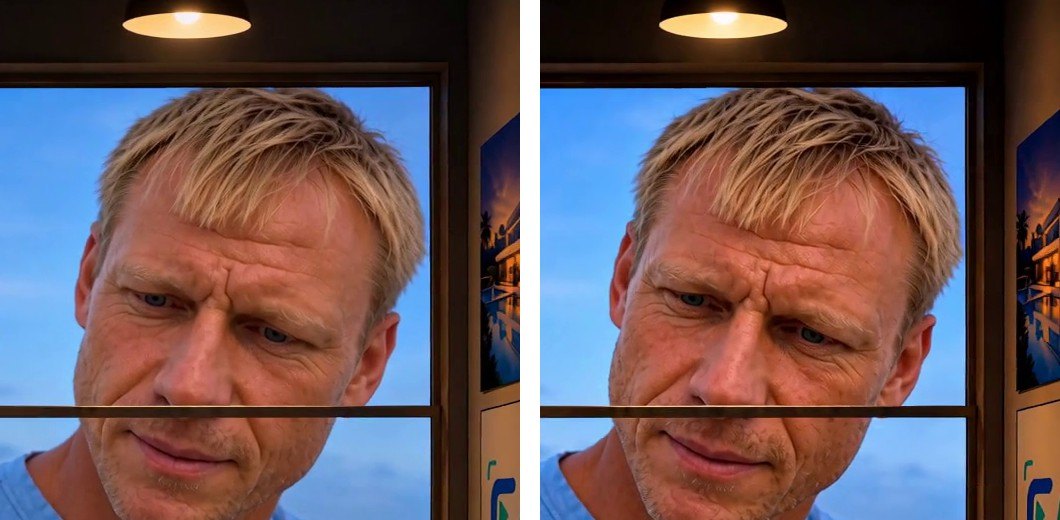
Au même moment, à 1.6 s dans le plan B, en taille réelle. À gauche : H3 complet. À droite : H3 turbo, avec des taches sombres marbrées sur la peau.
Turbo, 2.0 s : le casque ressemble à une icône plate collée sur le visage, et non à un objet en mouvement.Turbo, 4.3 s : personne n'a demandé de dérive au premier plan pendant le mouvement.
Turbo est destiné aux brouillons. C'est idéal pour prévisualiser un mouvement de caméra ou vérifier la cohérence des images. Lorsqu'un visage occupe toute l'image, générez la prise avec le modèle complet.
Récapitulatif des coûts par modèle
Les croix rouges marquent les prises inacceptables. Les coches jaunes marquent les prises proches de l'objectif, avec des incohérences résiduelles ; pour Seedance, cela inclut des nouilles surdimensionnées. Chaque ligne du tableau correspond à un modèle et une plateforme, avec le coût total des séquences indiqué.
Modèle · plateforme
Séquences
Résultat
Base de coût
Env. EUR
Google Flow
2 × 8 s
720 × 1280
Crédits quotidiens gratuits
€0
Brouillon Seedance 2.5 · Higgsfield
8 s
480 × 854
24 crédits
€1.05
Wan 3.0 · Higgsfield
3 s + 6 s
1080 × 1920 · 30 ips
31.5 crédits (3.5 par seconde)
€1.38
MiniMax H3 complet · Hugging Face
6.58 s
768 × 1344 · 24 fps
≈ 10.9 / 40 minutes de GPU quotidiennes (27.3%)
€0.073
MiniMax H3 turbo · Hugging Face
6.58 s
768 × 1344 · 24 fps
≈ ⪀ 4.2 / 40 minutes de GPU quotidiennes (10.5%)
€0.028
Les estimations de Higgsfield sont basées sur le tarif enregistré de 49 $ / plan de 1,000 crédits, avec tous les crédits utilisés. Les estimations de Hugging Face répartissent son abonnement mensuel de 9 $ sur 30 jours, puis multiplient cette part quotidienne par le pourcentage de quota dans les journaux d'exécution, incluant le conditionnement. Il s'agit de coûts d'abonnement alloués, et non de factures par exécution ; un quota inutilisé augmente le coût effectif.
Conversion : $1 ≈ €0.893, basée sur le taux de référence de la BCE. Les plans et les quotas sont susceptibles de changer ; consultez les tarifs Higgsfield et Hugging Face PRO de votre compte.
Ce qu'il faut retenir
Concevez d'abord les images clés, puis animez entre elles. Les images partagées aident à aligner une scène multi-plans, mais vérifiez la texture de la peau et l'éclairage lors de la transition.
Modifiez l'image approuvée au lieu de faire une nouvelle demande. Un seul changement par requête, un seul travail par image source, utilisez des positions réelles plutôt que des adjectifs.
Les modèles Turbo sont destinés aux brouillons. Pour les prises finales, utilisez le modèle complet lorsque le visage occupe une grande partie de l'image.
Un modèle open source peut égaler un modèle payant sur un plan donné. H3 complet face à Wan 3.0 ici. Déployer un modèle OSS sur un GPU peut donner un résultat similaire à un coût bien inférieur à celui d'un modèle payant via une API, selon l'utilisation du matériel et les coûts d'hébergement.
Utilisez des compétences pour améliorer automatiquement les prompts d'images et de vidéos. Laissez des instructions spécialisées traduire une requête courte en la structure et les contraintes dont chaque modèle a besoin.
Créez un plan comme celui-ci vous-même
AI Video Starter est un atelier en direct de trois heures : idée, plan de caméra, images de référence, génération, correction des prises ratées et montage, sur votre propre vidéo courte.