Waarom het juiste AI-model en gespecialiseerde vaardigheden de opname laten werken
Eén korte komische scène in een miniatuur poppenhuis, getest via verschillende workflows: afbeeldingen in een chat en met een montage-workflow, video in Google Flow, Seedance 2.5, Wan 3.0 en MiniMax H3. Wat er misging, wat het oploste, en elke prompt.
Gepubliceerd 15 oktober 20267 videogeneraties vergeleken10 min leestijd
Het doel was één opname in één specifieke kamer van een fotorealistisch miniatuurpoppenhuis, eindigend met een beweging van de camera naar de volgende kamer. Het duurt ongeveer negen seconden. Een kleine handelaar eet noedels voor drie monitoren. Een reusachtige man, ikzelf, kijkt hem door het achterste raam aan. De handelaar snauwt: “Laat me met rust!” en gooit iets tegen het glas. De reus zegt: “Sorry!”, en de camera glijdt door naar de aangrenzende yogaruimte, waar een vrouw haar ogen op haar tablet houdt.
De oorspronkelijke korte opname leek simpel, maar bleek bij elke stap van de productie lastig: twee sprekende personages met lip-sync, een worp met realistische fysica, een continue camerabeweging tussen twee kamers en een groot gezicht dat secondenlang het beeld vult. Dit zijn de resultaten, naast elkaar, inclusief de prompts.
Het plan: eerst drie afbeeldingen
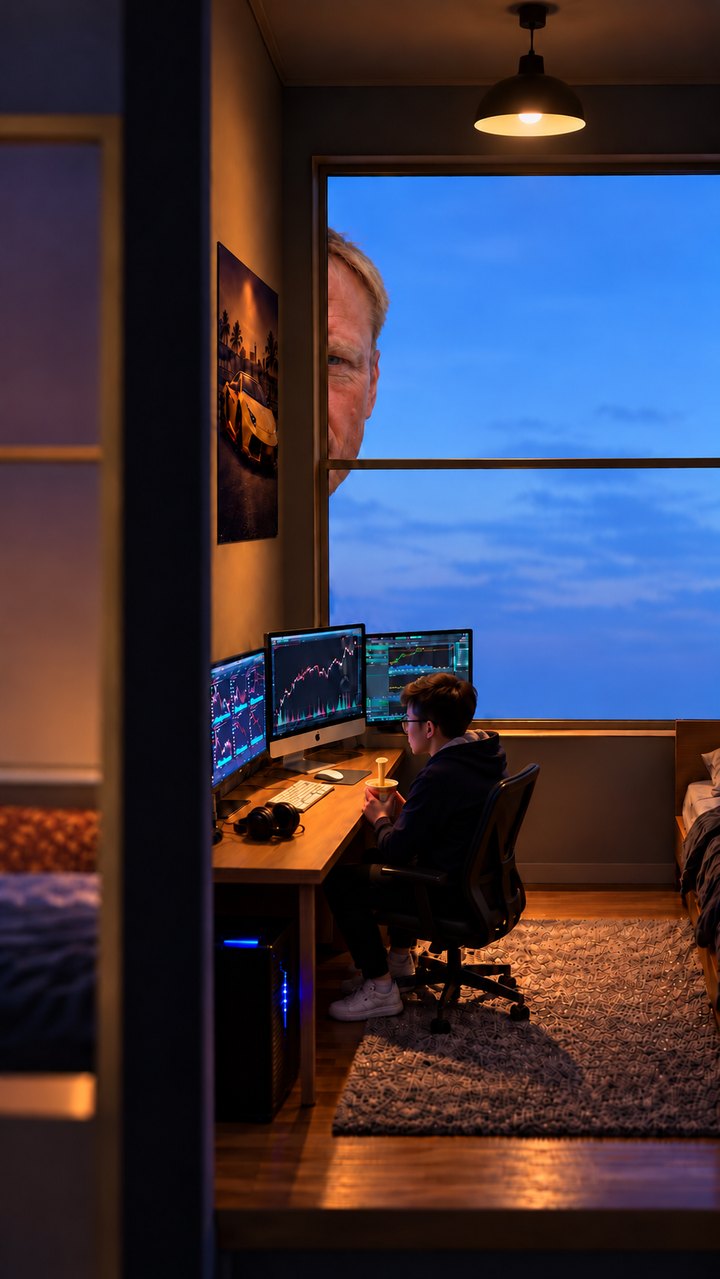
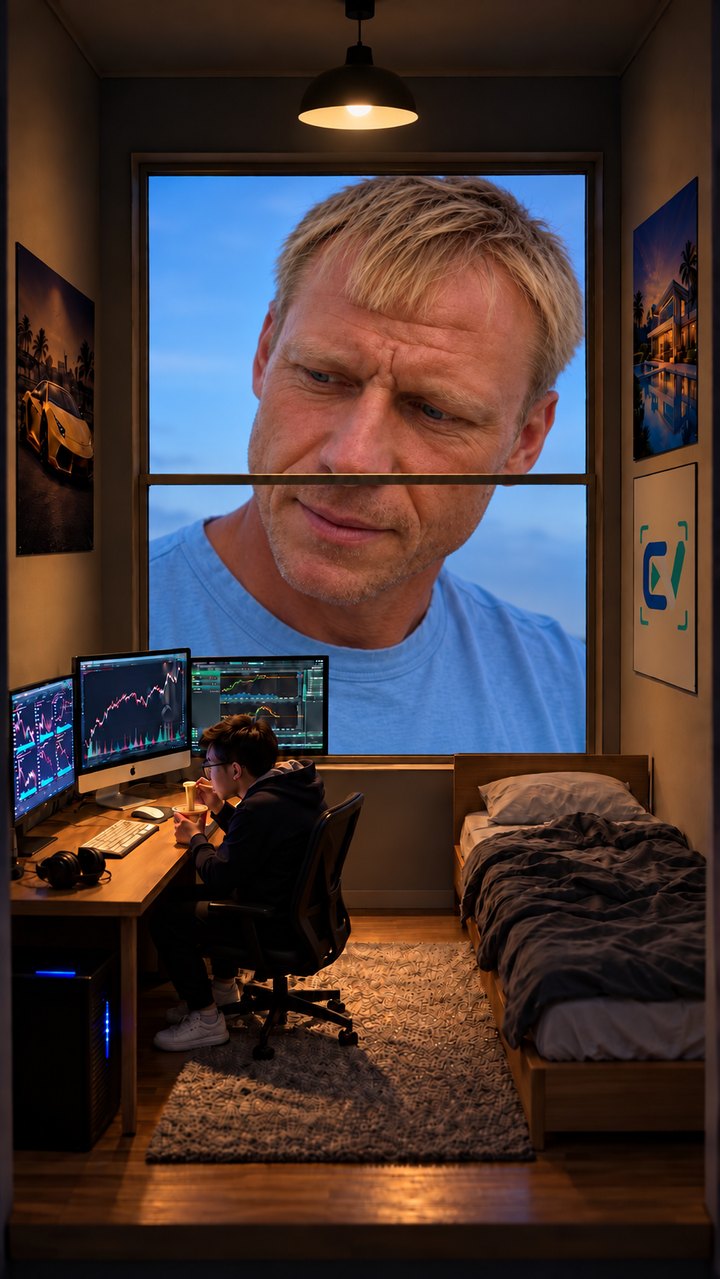
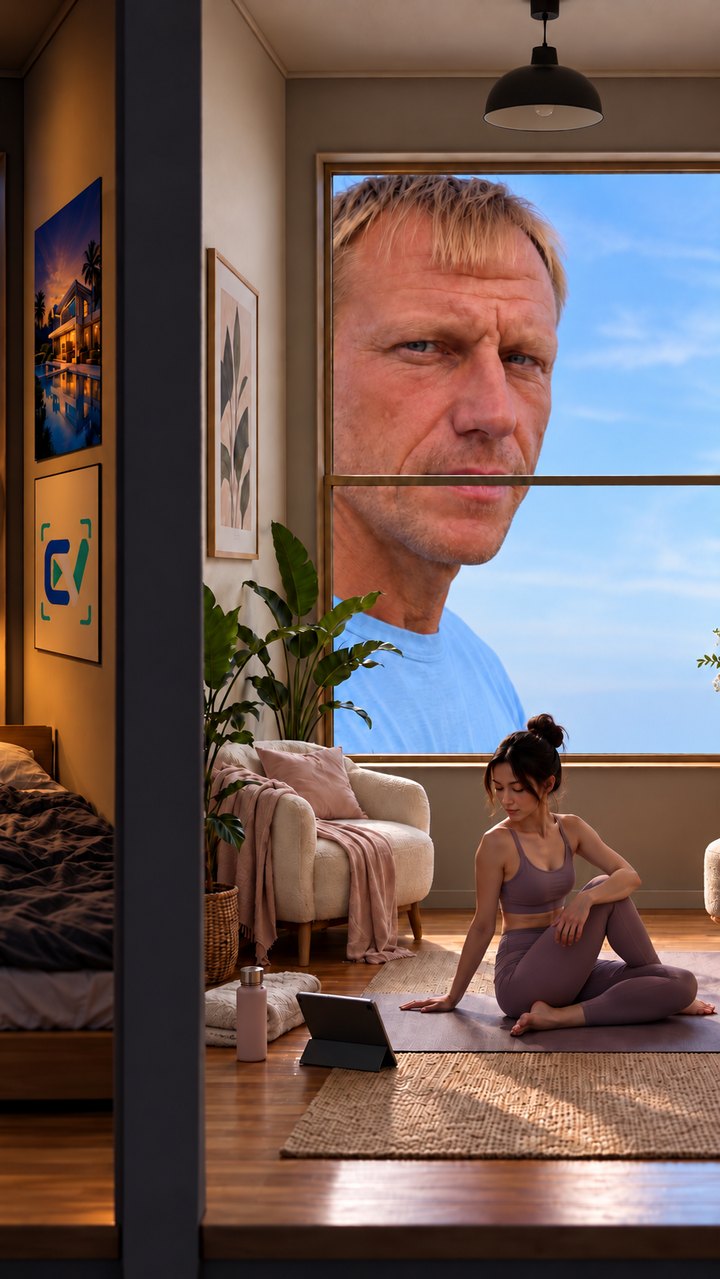
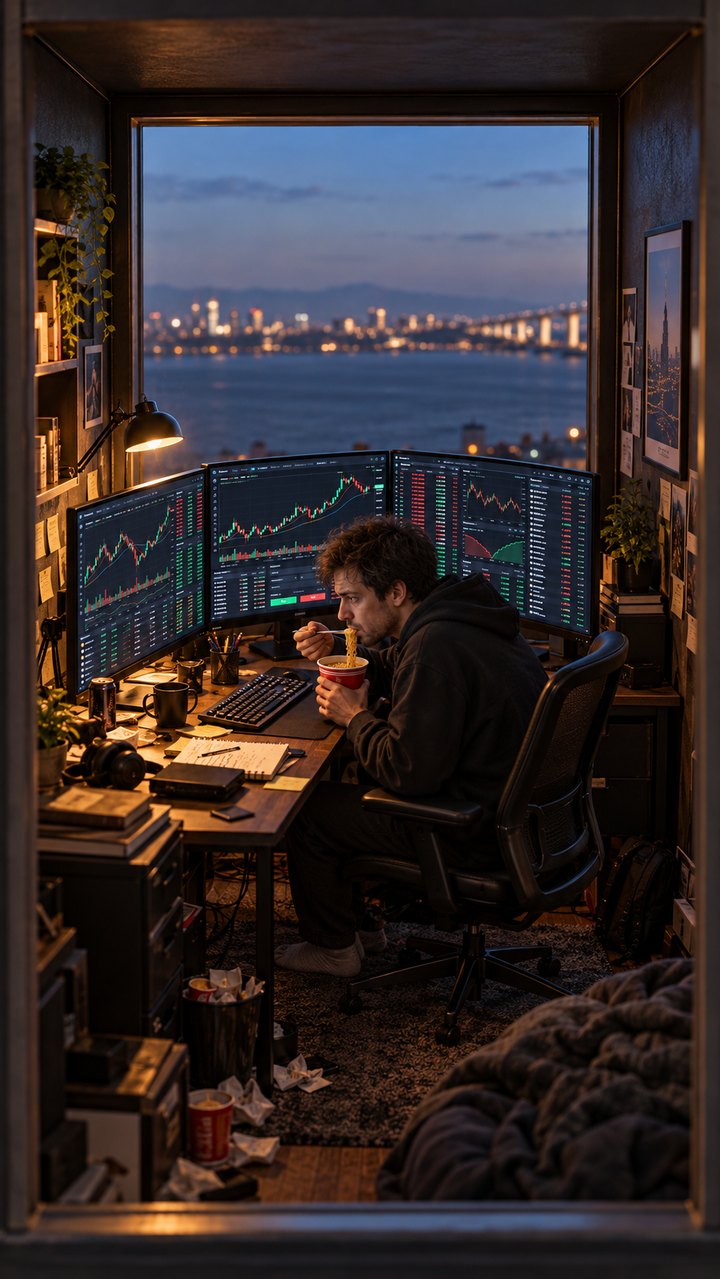
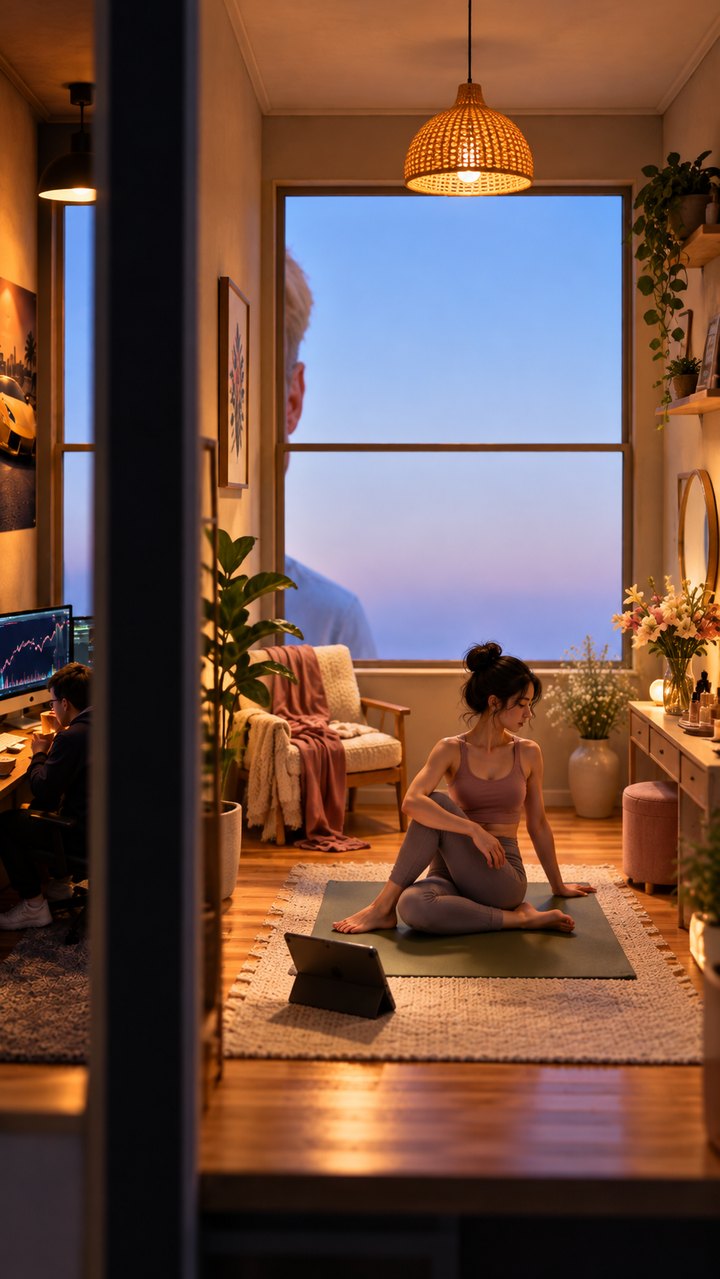
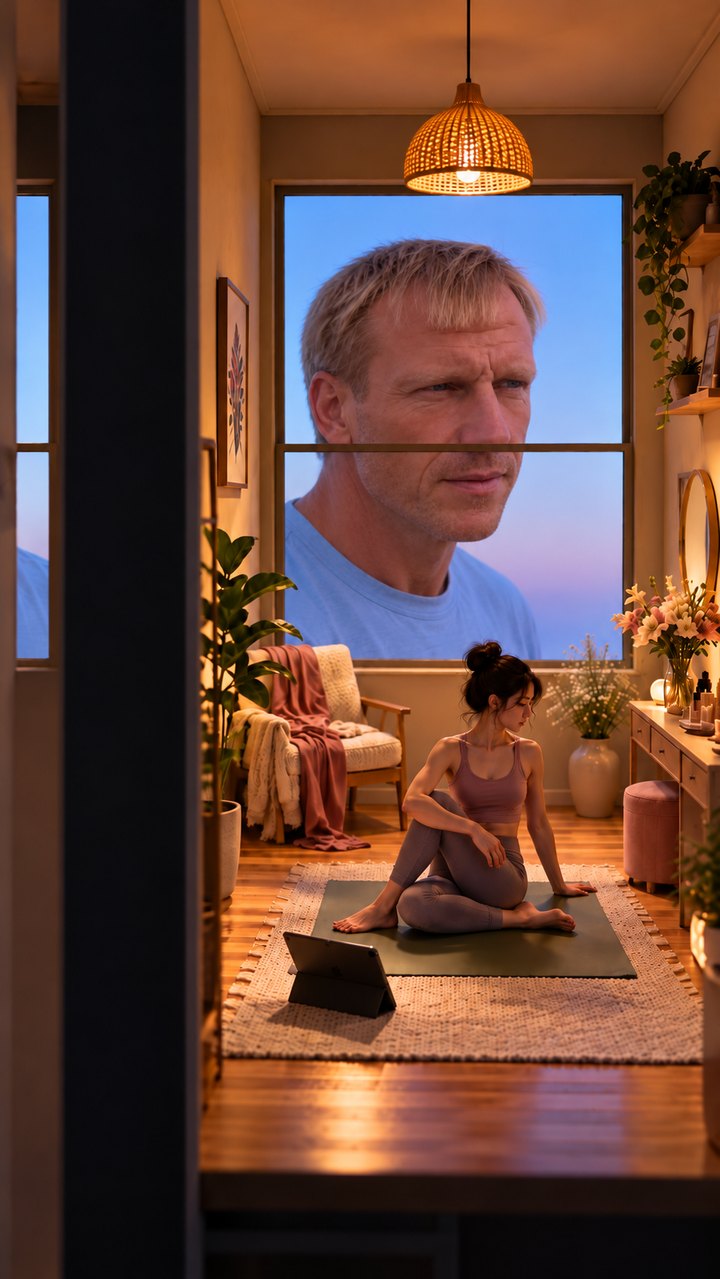
De methode was om de belangrijkste beelden goed te keuren voordat er video werd gegenereerd: de opening van de kamer van de handelaar, de reus die hem observeert, en het slotbeeld in de yogaruimte.
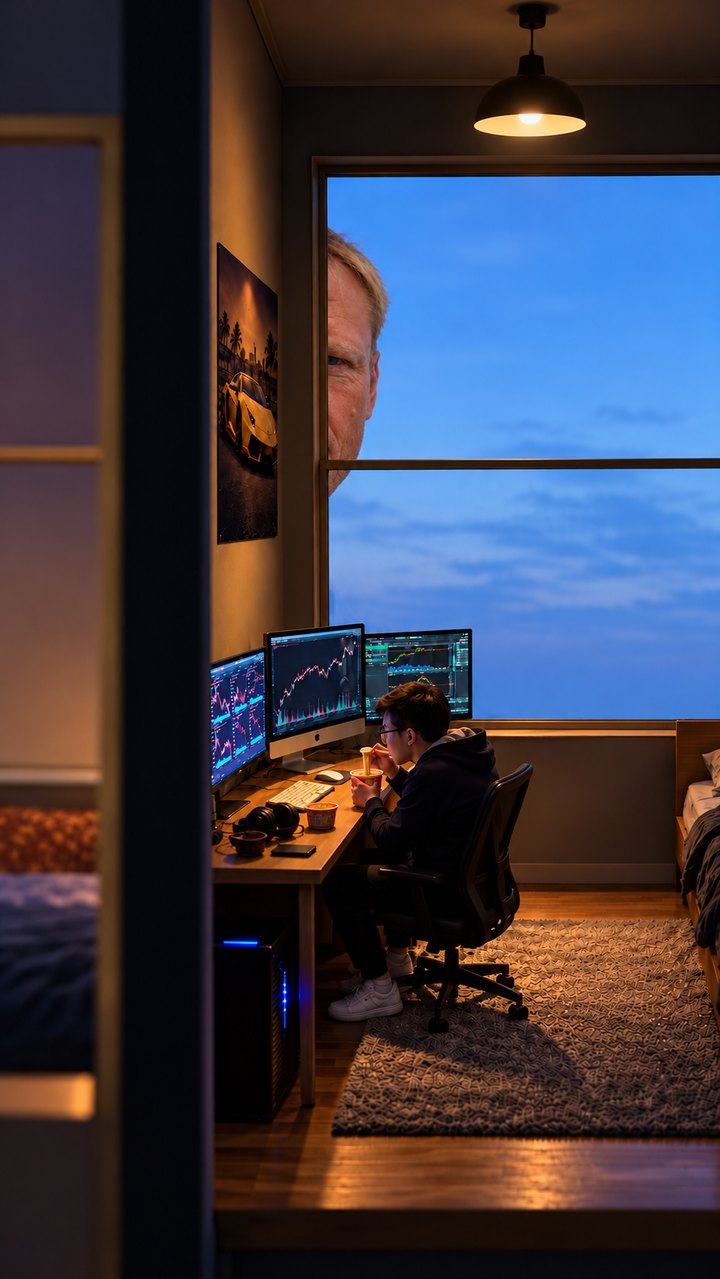
Start
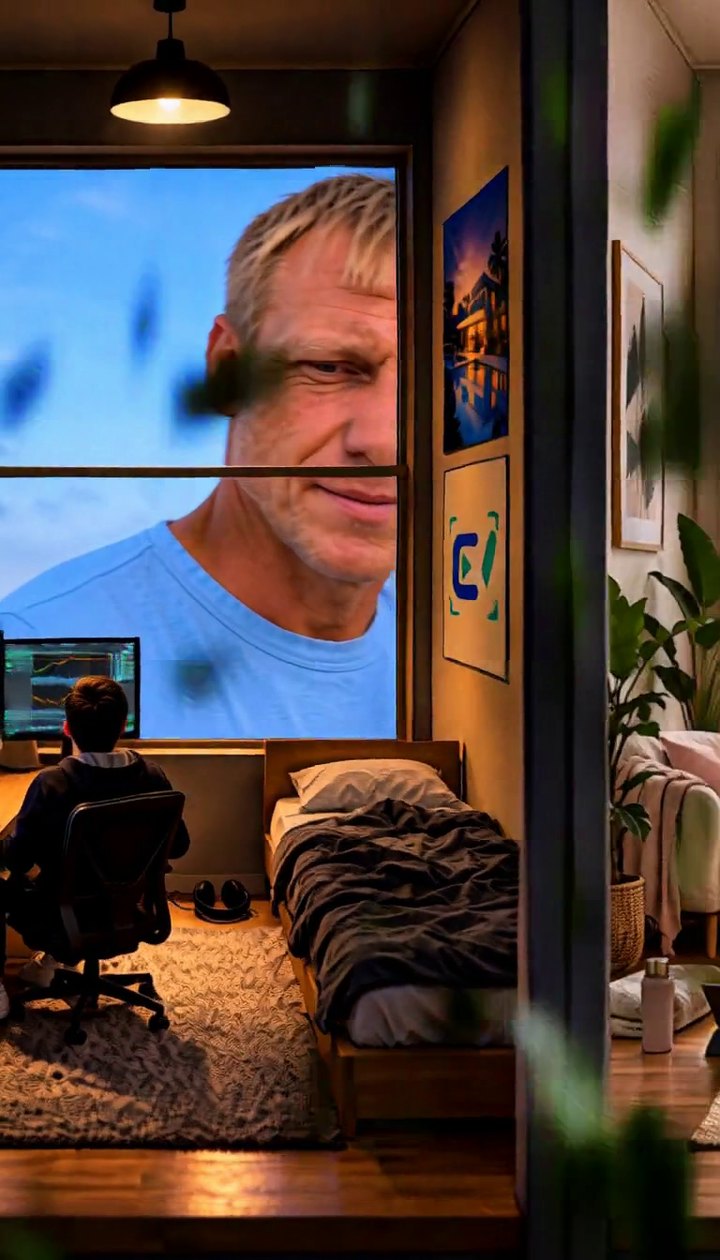
De kamer van de handelaar
Een fragment van de vorige kamer, de scheidingswand, en alleen de rand van het gezicht van de reus.
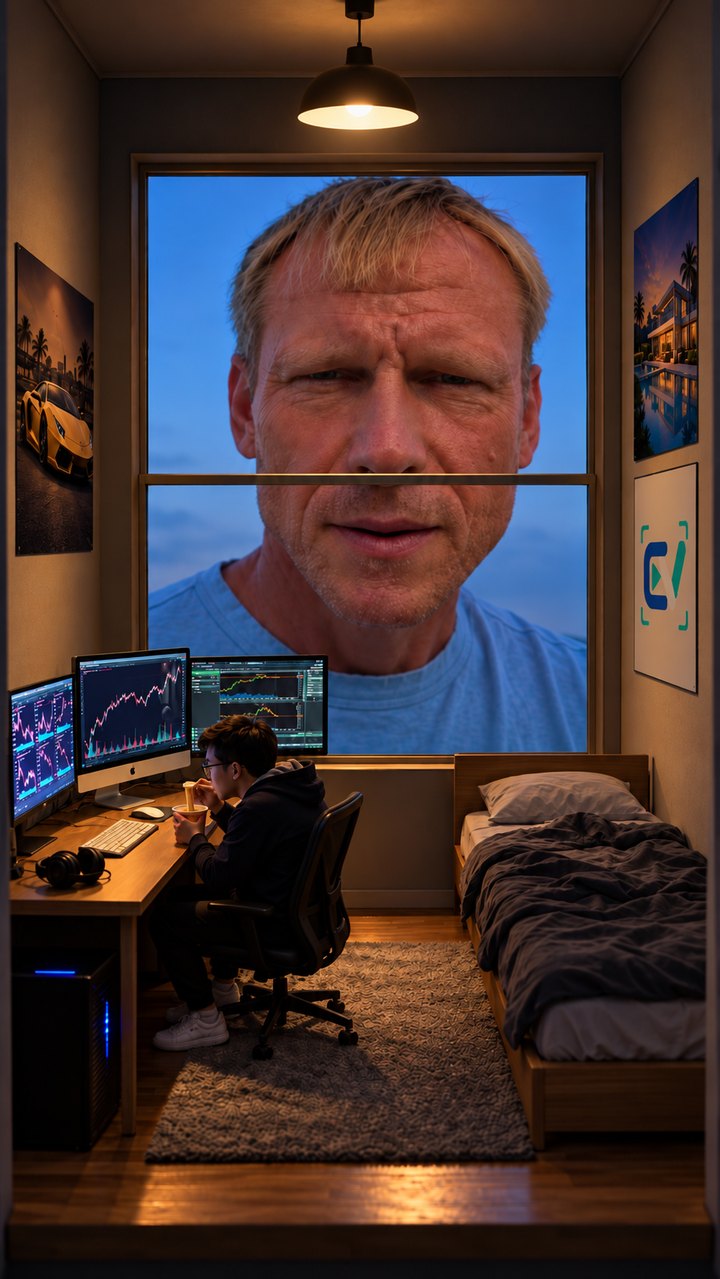
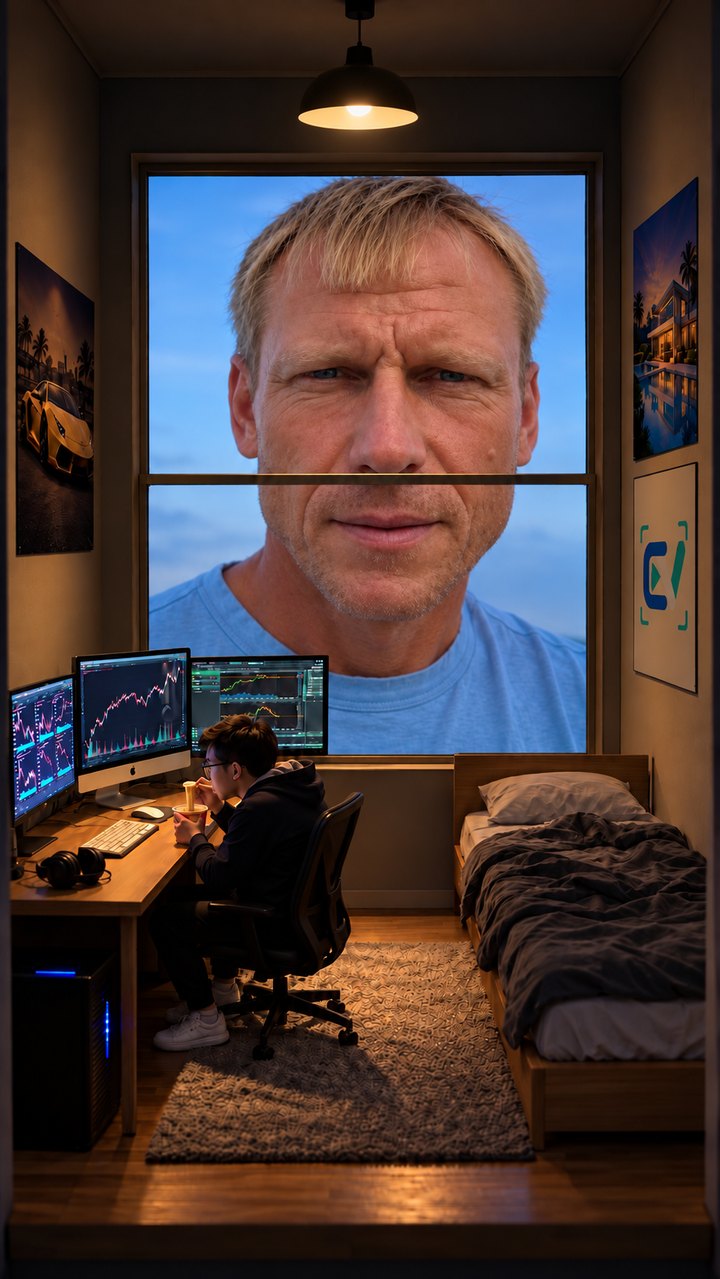
Midden
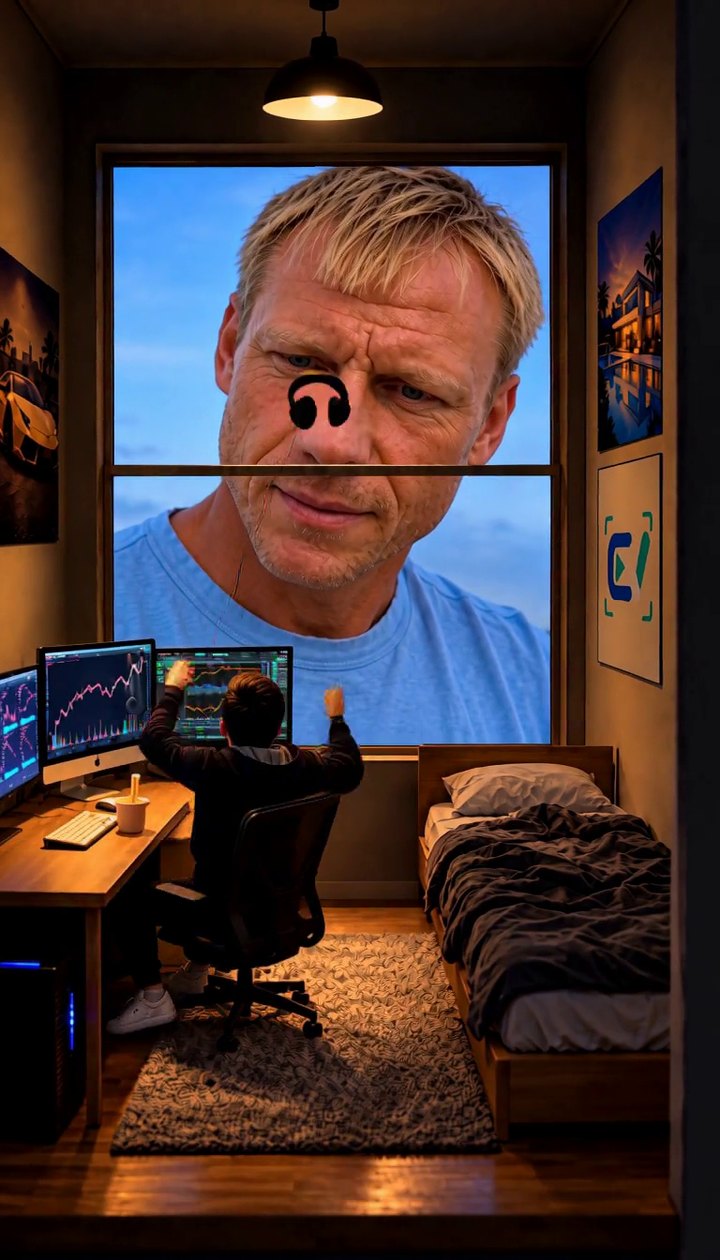
De reus kijkt toe
Zijn gezicht vult het raam, zijn ogen op de handelaar gericht. Dit frame wordt later het gezamenlijke snijpunt in de montage.
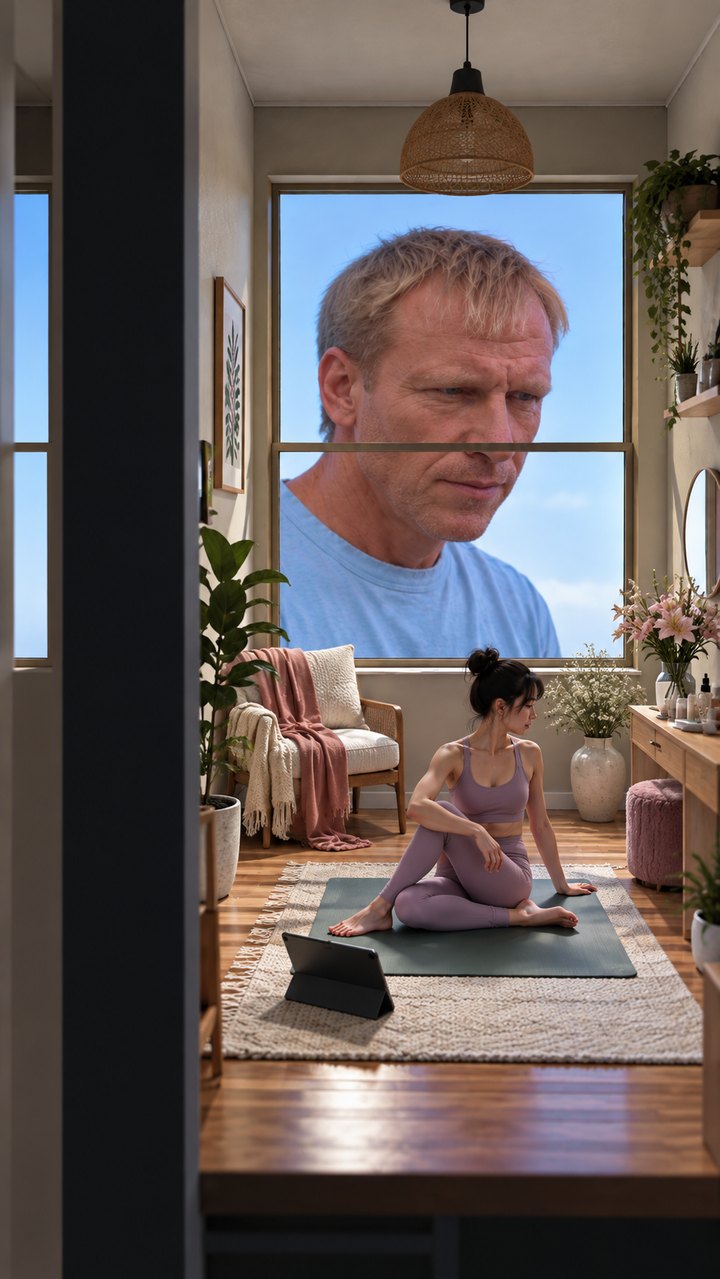
Einde
De yogaruimte
Zelfde raamgrootte, vloerhoogte en gezichtsschaal, één kamer naar rechts.
Foto's, ronde 1: 33 afbeeldingen in een ChatGPT chat
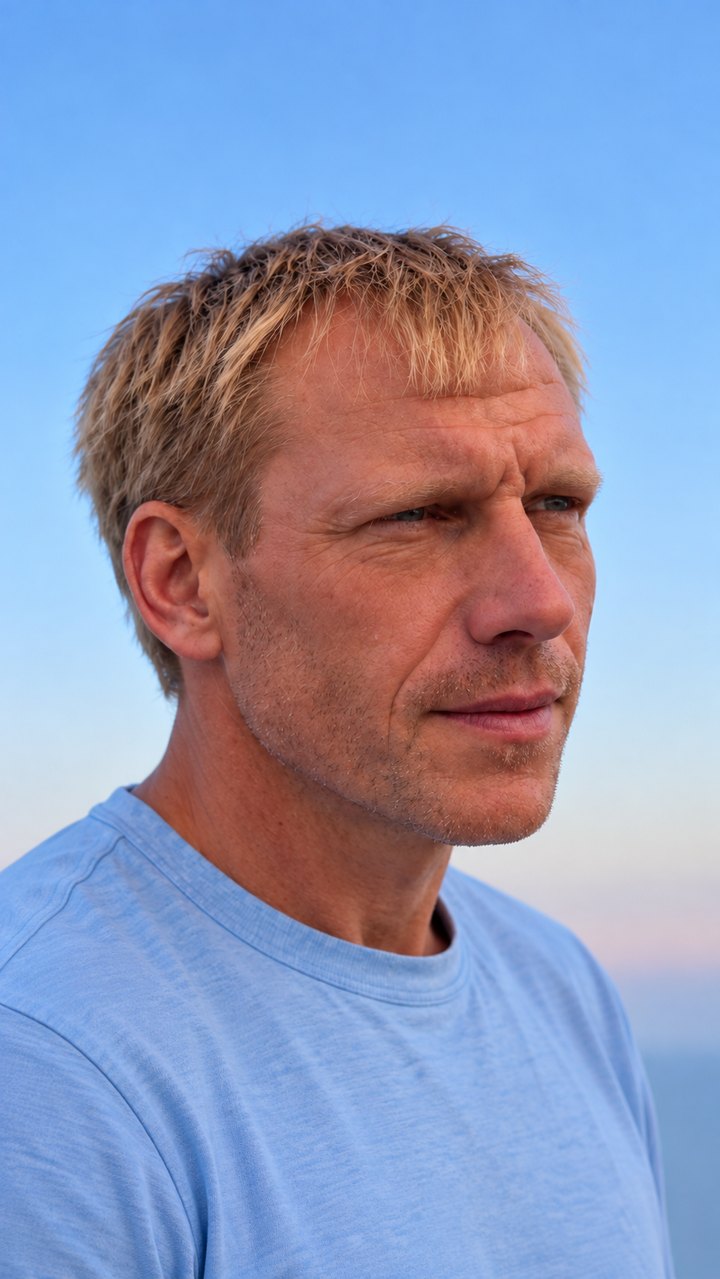
De eerste poging was een gewone ChatGPT-conversatie op een Plus-abonnement: beschrijf de kamer, voeg een foto van mijn gezicht toe, vraag om wijzigingen. Het kostte me 26 berichten en leverde 33 afbeeldingen op, waarbij ongeveer 18 van mijn berichten correcties waren. Elk antwoord bouwde de scène vanaf nul op, waardoor het herstellen van het ene ding het andere verstoorde.
Geen monitoren, geen handelaar.Te rommelig, en de reus ontbreekt.De handelaar uit de oude kamer is nog steeds in beeld.“Een totaal ander persoon.”Ik, verdeeld over twee vensters.Venster op 78% van de gevraagde grootte.
Aan het einde gaf ik de exacte pixelgeometrie voor het raam en beide personen op, en vroeg ik de chat om het eigen resultaat te meten. Het rapporteerde een raam van 485 × 644 px ten opzichte van de 621 × 811 px in de prompt: 136 px te smal en 167 px te kort. Een model dat een afbeelding opnieuw tekent op basis van woorden, kan geen exacte pixelwaarden raken, hoe nauwkeurig de woorden ook zijn.
Afbeeldingen, ronde 2: 11 afbeeldingen, meestal de eerste poging
De tweede ronde begon vanaf de beste afbeelding van ronde 1 en draaide in Codex verbonden met het easyai.video platform, met onze picture skills geïnstalleerd. Acht verzoeken leverden elf afbeeldingen op. Zes van de acht verzoeken waren nieuwe wijzigingen, die elk bij de eerste poging werden goedgekeurd; de andere twee waren correcties voor de muurpositie en de vloerhoogte.
Start: het beste beeld uit ronde 1.1 · één lichtbron, scherper gezicht.2 · focus op de handelaar.3 · de muur tussen de kamers.4 · de yogaruimte.
Er is niets magisch veranderd tussen de rondes. De manier van vragen wel:
Bewerk, genereer niet opnieuw. Elk verzoek vertrok vanuit de laatst goedgekeurde afbeelding en behield alles wat al goed was.
Eén wijziging per verzoek. Licht, dan het gezicht, dan de blik, dan de lay-out. Nooit vier correcties in één bericht.
Eén taak per invoerfoto. “Afbeelding 1 is het definitieve bewerkingsdoel. Afbeelding 2 levert alleen de linkerstrook.”
Meet, en veranker dan. In plaats van “maak de kamer smaller”, bevatte de prompt de positie van objecten in de bron en waar ze naartoe moesten: verplaats de kamer 275 px naar rechts op 100% schaal, de dwarslat van het raam blijft op y = 626.
Gebruik een skill, geen improvisatie. De picture skills benoemden de use case (compositing, identity-preserve) en schreven de prompt telkens in dezelfde structuur.
Dit kun je ook in je eigen setup doen. Codex en Claude Code laden beide vaardigheden: een map met instructies en optioneel scripts die de agent leest voordat hij actie onderneemt. Een breed scala aan beeld- en videoskills is beschikbaar op GitHub en andere publieke bronnen. Kies vaardigheden die passen bij je model en montageopdracht, en gebruik ze om je prompts automatisch te verbeteren. Het easyai.video platform is voorzien van deze vaardigheden, plus de promptformaten die elk videomodel verwacht.
Video, take 1: de hele scène als één 8-seconden opname
Nu de drie afbeeldingen zijn goedgekeurd, vroegen de eerste video-pogingen om alles in één generatie te doen: eten, opmerken, schreeuwen, gooien, verontschuldigen, naar de volgende kamer glijden. Voor een experiment begon ik met gratis Google Flow generaties. Google Flow gebruikte de drie afbeeldingen als referenties; take 2 gebruikte een herschreven prompt waarin de spreker van elke regel werd benoemd en de beker naar het achterste raam werd herleid. Seedance 2.5 gebruikte de afbeeldingen als startframe, een beeldreferentie en een eindframe in de omni-referentiemodus.
Take 1
Google Flow
Begint in ons frame, waarna de reus beide regels uitspreekt, voordat er iets wordt gegooid. De beker vliegt naar de camera, niet naar het raam, en de trader houdt zijn eigen beker vast. De yogaruimte verschijnt via een swap in plaats van een slide.
Take 2
Google Flow
Onze eerste frame wordt genegeerd: een boogvormige deuropening en een lichtere kamer. Twee reuzen verschijnen, waarna een man op ware grootte binnenloopt en de beker werpt. Niemand zegt “Sorry”. Het eindigt in een andere yogaruimte.
Take 3
Seedance 2.5 · 480p concept
De meest nabije van de drie: de beker vliegt van ons af en spat uiteen op de achterruit, terwijl de camera de yogaruimte in glijdt. Gerenderd als een goedkope 480p conceptversie.
De afbeeldingen waren niet het probleem. De opname vroeg om te veel dingen tegelijk, waardoor het model er een aantal wegliet en andere anders rangschikte.
Video, take 2: twee korte opnames via een gedeeld frame
De oplossing was om de scène te splitsen op het punt waar deze natuurlijk breekt. Opname A loopt van het eerste frame tot het middelste frame in 3 seconden: de handelaar eet en de reus verschijnt in het raam. Opname B loopt vanaf datzelfde middelste frame tot het laatste frame in 6 seconden: de lijn, de worp, de verontschuldiging en de beweging naar de yogaruimte. De twee opnames delen één frame, wat zorgt voor een gemeenschappelijke compositie bij de montage. In deze versie gooit de handelaar zijn koptelefoon in plaats van de noedels: noedels die tegen het raam spatten waren onprettig om naar te kijken, en Seedance maakte ze veel te groot.
Beide opnames zijn gemaakt met Wan 3.0 op Higgsfield, op een native resolutie van 1080 × 1920 en 30 fps met gegenereerd geluid.
Opname A · 3 s
Wan 3.0
De handelaar blijft eten en kijkt nooit op; de reus glijdt het beeld in en staat stil in het middelste frame.
Opname B · 6 s
Wan 3.0
“Laat me met rust!”, de koptelefoon raakt het glas en valt, “Sorry.”, gevolgd door de overgang naar de yogaruimte, eindigend op het laatste frame. Er werden aan het einde een paar muzieknoten toegevoegd, wat de prompt juist uitsloot.
A + B · 9 s
Samengevoegd bij het gedeelde frame
Het gezicht heeft in het tweede deel een iets andere huidtextuur, waardoor de overgang zichtbaar is. Een model dat één ononderbroken opname kan maken, zoals Seedance, is te verkiezen voor continuïteit.
Dezelfde opname op MiniMax H3: volledig model vs turbo
Vervolgens hebben we opname B opnieuw gerenderd op MiniMax H3, op onze eigen kopie van het model binnen de dagelijkse GPU quotum van Hugging Face, met dezelfde twee frames, hetzelfde verhaal en dezelfde seed (42). Het easyai.video platform herschrijft de prompt eerst naar het formaat dat H3 verwacht; de onderstaande prompt is wat er na die herschrijving in het model ging.
Opname B · Wan 3.0
1080 × 1920 · 30 fps
De referentie: elke beat in volgorde, eindigend op het laatste frame.
Opname B · H3 volledig
768 × 1344 · 24 fps · 28 stappen
Vergelijkbaar met Wan 3.0 bij deze opname: de tekst, de worp, de verontschuldiging en de beweging komen allemaal goed uit. Lagere resolutie; verbruikt een deel van de dagelijkse GPU quotum.
Opname B · H3 turbo
768 × 1344 · 24 fps · 6 stappen
Volgt de verhaallijn, maar het grote gezicht, de koptelefoon en de beweging tussen de kamers verraden het.
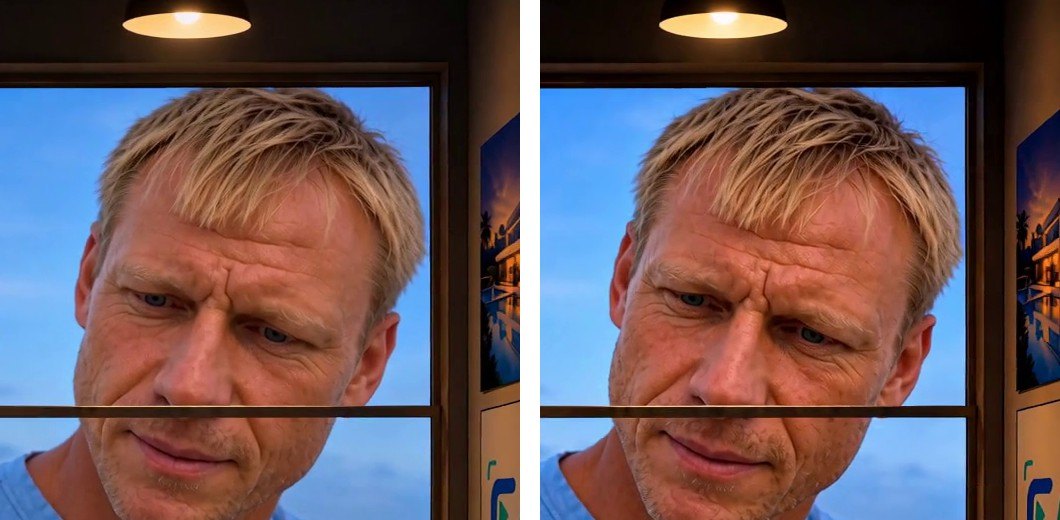
Op hetzelfde moment, 1.6 s in opname B, op volledige grootte. Links: H3 full. Rechts: H3 turbo, met donkere gevlekte plekken op de huid.
Turbo, 2.0 s: de hoofdtelefoon ziet eruit als een plat icoontje dat op het gezicht is geplakt, niet als een object in beweging.Turbo, 4.3 s: laat niemand ongevraagde drift over de voorgrond zien tijdens de beweging.
Turbo is voor concepten. Het is prima om een camerabeweging te blokken of te testen of de frames werken. Wanneer een gezicht het hele beeld vult, render je de take met het volledige model.
Kostenoverzicht per model
Rode kruisen markeren onacceptabele takes. Gele vinkjes markeren takes die dicht bij het doel liggen, met resterende inconsistenties; voor Seedance zijn dit onder andere te grote noedels. Elke rij in de tabel beslaat één model en platform, met de totale kosten van de beelden vermeld.
Model · platform
Beelden
Output
Kostenbasis
Ongeveer EUR
Google Flow
2 × 8 s
720 × 1280
Gratis dagelijkse credits
€0
Seedance 2.5 concept · Higgsfield
8 s
480 × 854
24 credits
€1.05
Wan 3.0 · Higgsfield
3 s + 6 s
1080 × 1920 · 30 fps
31.5 credits (3.5 per seconde)
€1.38
MiniMax H3 full · Hugging Face
6.58 s
768 × 1344 · 24 fps
≈ 10.9 / 40 dagelijkse GPU minuten (27.3%)
€0.073
MiniMax H3 turbo · Hugging Face
6.58 s
768 × 1344 · 24 fps
≈ 4.2 / 40 dagelijkse GPU minuten (10.5%)
€0.028
Higgsfield schattingen zijn gebaseerd op het geregistreerde $49 / 1,000-creditplan, waarbij alle credits zijn verbruikt. Hugging Face schattingen verdelen het maandelijkse abonnement van $9 over 30 dagen, en vermenigvuldigen dat dagelijkse deel vervolgens met het quotagepercentage in de run-logs, inclusief conditioning. Dit zijn toegewezen abonnementskosten, geen facturen per run; ongebruikte quota verhogen de effectieve kosten.
Ontwerp eerst de sleutelbeelden en animeer daarna tussen deze beelden. Gedeelde frames helpen bij het afstemmen van een scène met meerdere opnames, maar controleer de huidtextuur en belichting bij de montage.
Bewerk de goedgekeurde afbeelding in plaats van opnieuw te vragen. Eén wijziging per verzoek, één taak per invoerfoto, gebruik echte posities in plaats van bijvoeglijke naamwoorden.
Turbo-modellen zijn bedoeld voor concepten. Render de definitieve takes met het volledige model wanneer een gezicht groot in beeld is.
Een open-source model kan een betaald model evenaren bij een specifieke opname. H3 volledig afgezet tegen Wan 3.0 hier. Het inzetten van een OSS-model op een GPU kan een vergelijkbaar resultaat geven tegen veel lagere kosten dan een betaald model via een API, afhankelijk van hardwaregebruik en hostingkosten.
Gebruik vaardigheden om beeld- en videoprompts automatisch te verbeteren. Laat gespecialiseerde instructies een korte aanvraag vertalen naar de structuur en beperkingen die elk model nodig heeft.
Bouw zelf een opname zoals deze
AI Video Starter is een live workshop van drie uur: idee, opnameplan, referentieafbeeldingen, generatie, het herstellen van mislukte takes en montage, gericht op je eigen korte video.