Warum das richtige KI-Modell und spezialisierte Fähigkeiten die Einstellung retten
Eine kurze Comedy-Szene in einem Miniatur-Puppenhaus, getestet in verschiedenen Workflows: Bilder in einem Chat und mit einem Editing-Workflow, Video in Google Flow, Seedance 2.5, Wan 3.0 und MiniMax H3. Was schiefging, was es behob und jeder einzelne Prompt.
Veröffentlicht am 15. Oktober 20267 Videogenerierungen im Vergleich10 Min. Lesezeit
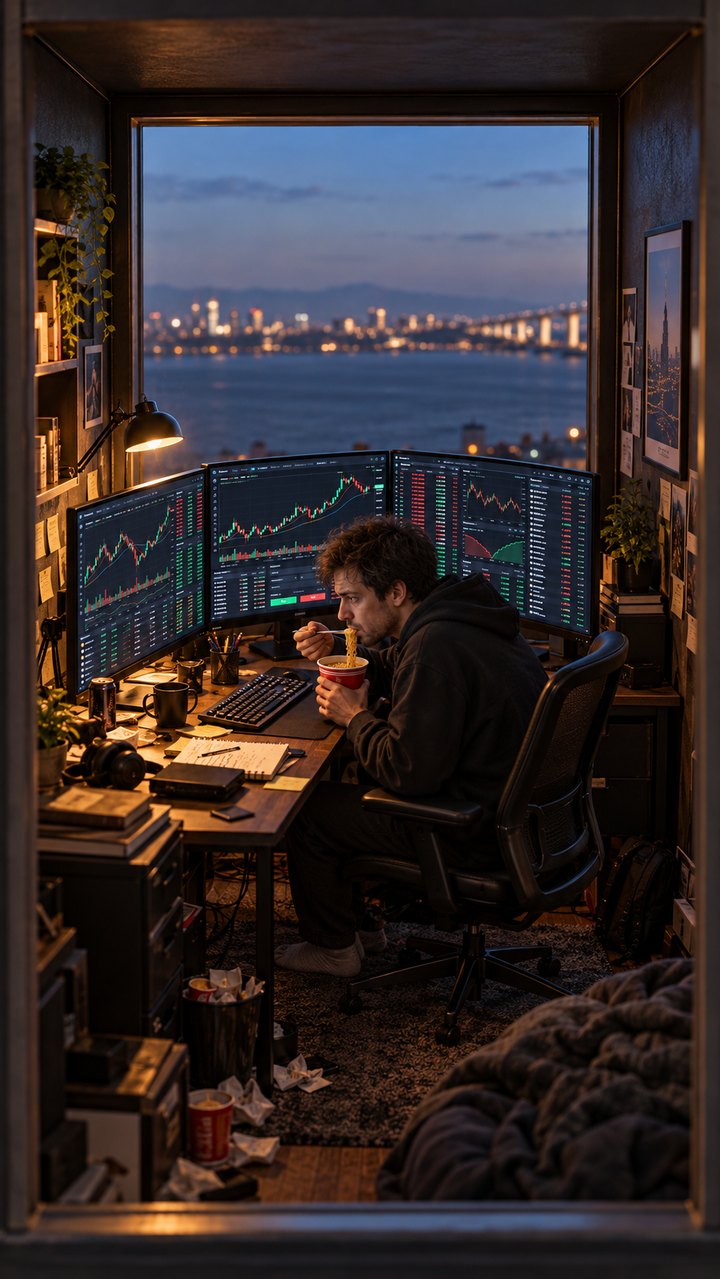
Das Ziel war eine einzige Einstellung in einem speziellen Raum eines fotorealistischen Miniatur-Puppenhauses, die mit einer Kamerabewegung in den nächsten Raum endet. Sie dauert etwa neun Sekunden. Ein winziger Händler isst Nudeln vor drei Monitoren. Ein riesiger Mann - ich - beobachtet ihn durch das hintere Fenster. Der Händler schnauzt: „Lass mich in Ruhe!“ und wirft etwas gegen das Glas. Der Riese sagt „Sorry!“, und die Kamera gleitet weiter in den benachbarten Yoga-Raum, in dem eine Frau auf ihr Tablet starrt.
Die ursprüngliche kurze Einstellung wirkte einfach, erwies sich aber in jedem Produktionsschritt als schwierig: zwei sprechende Charaktere mit Lippensynchronität, ein Wurf mit echter Physik, eine kontinuierliche Kamerabewegung zwischen zwei Räumen und ein großes Gesicht, das den Frame für Sekunden ausfüllt. Hier sind die Ergebnisse im direkten Vergleich, zusammen mit den Prompts.
Der Plan: zuerst drei Bilder
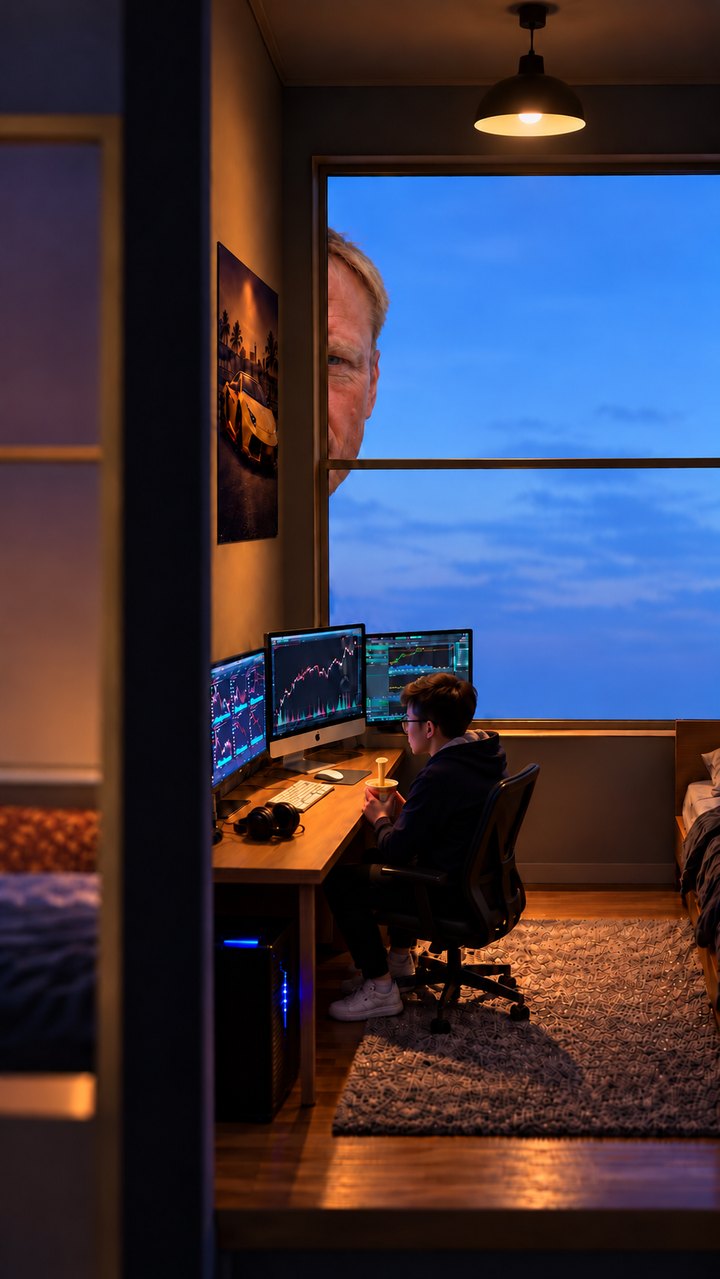
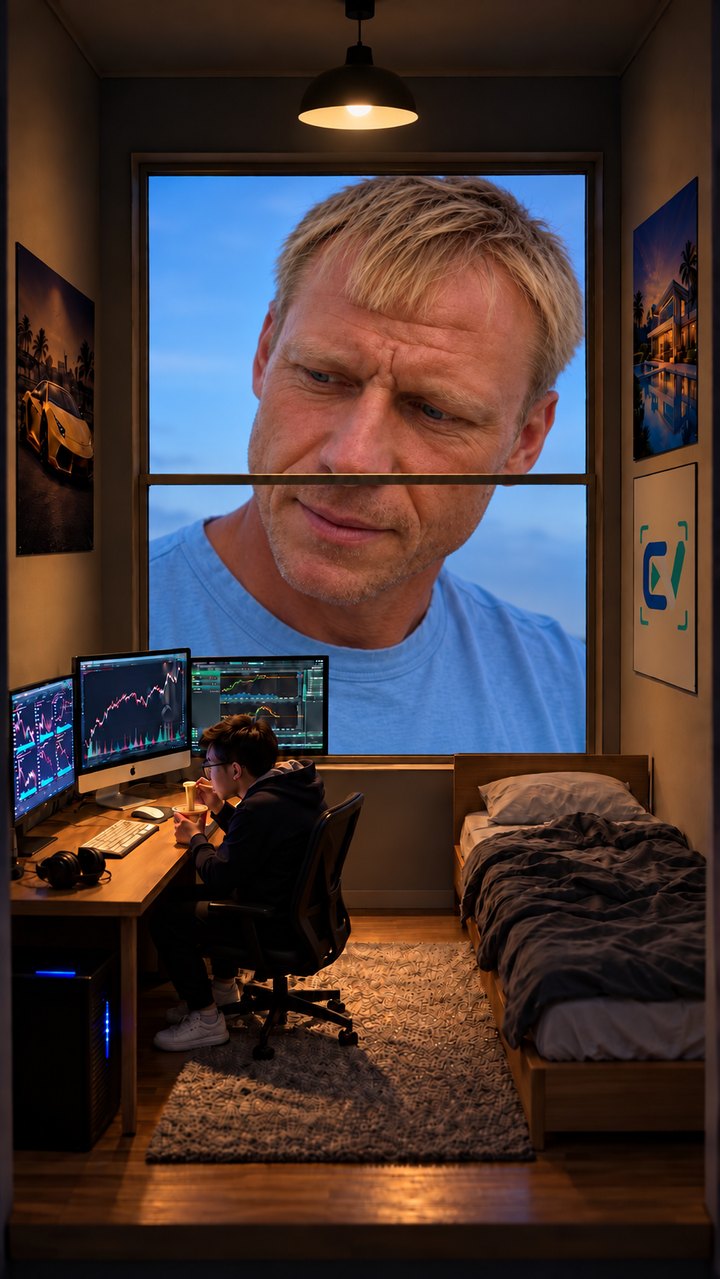
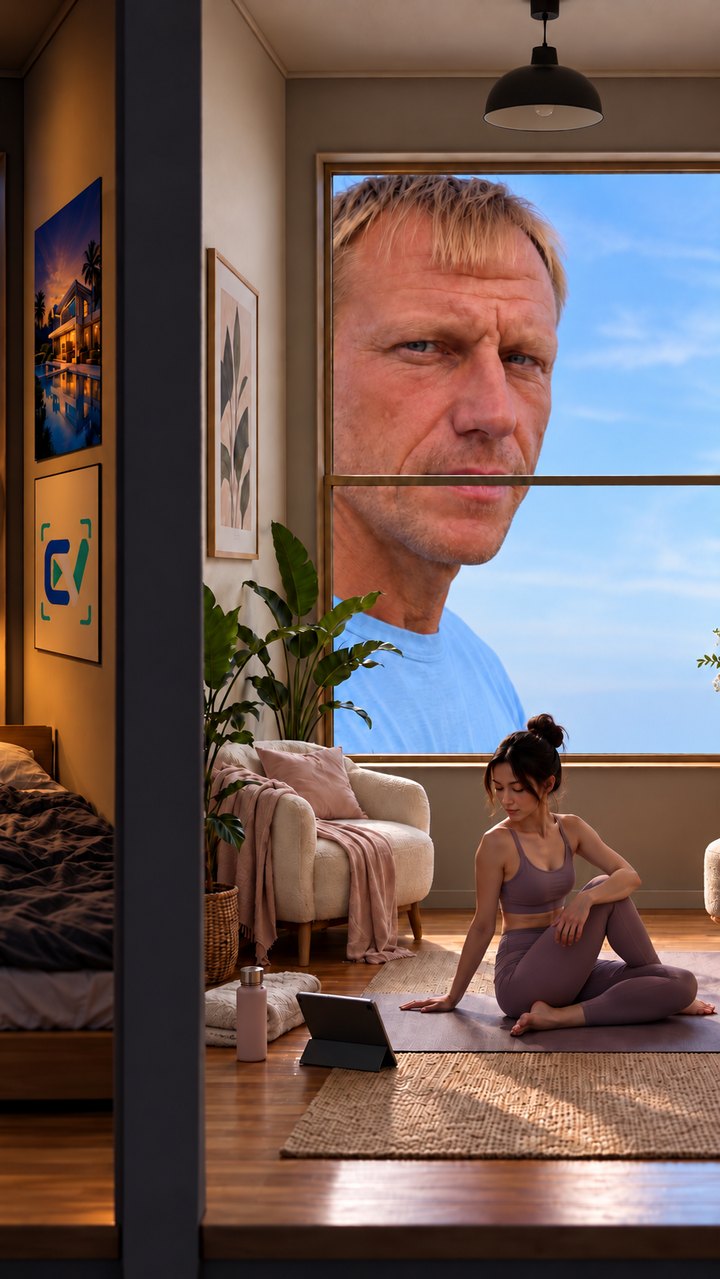
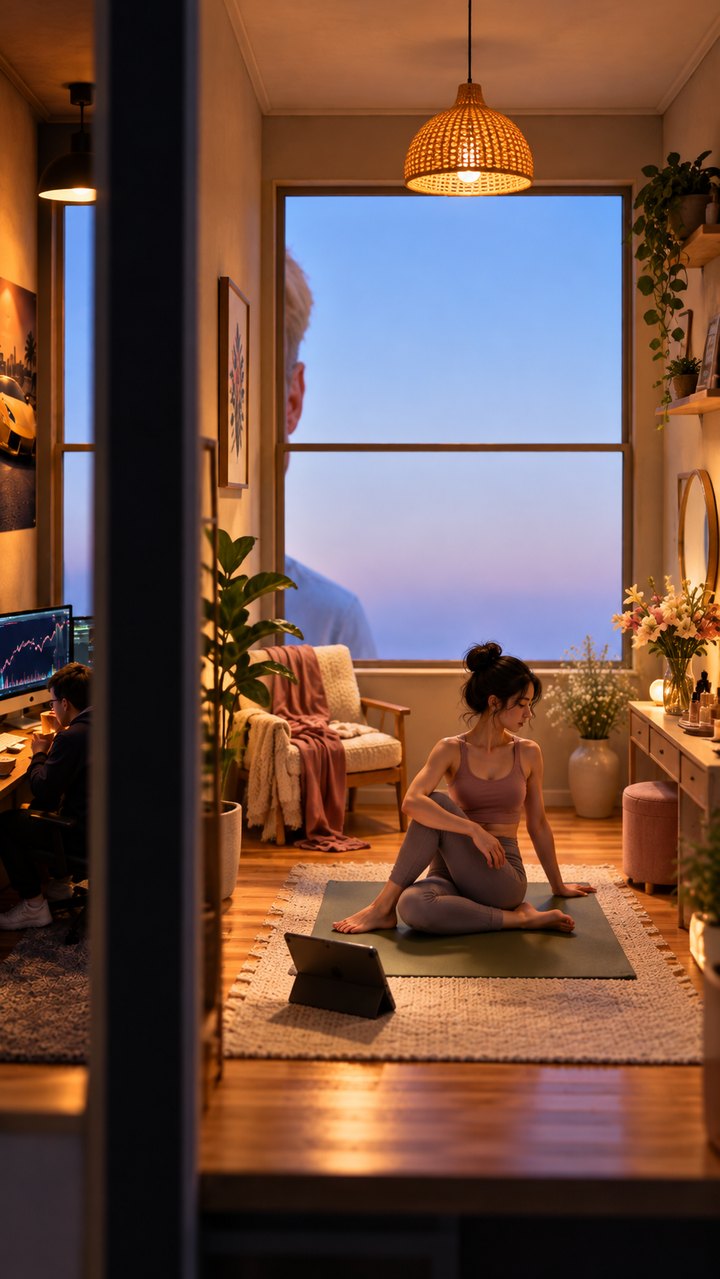
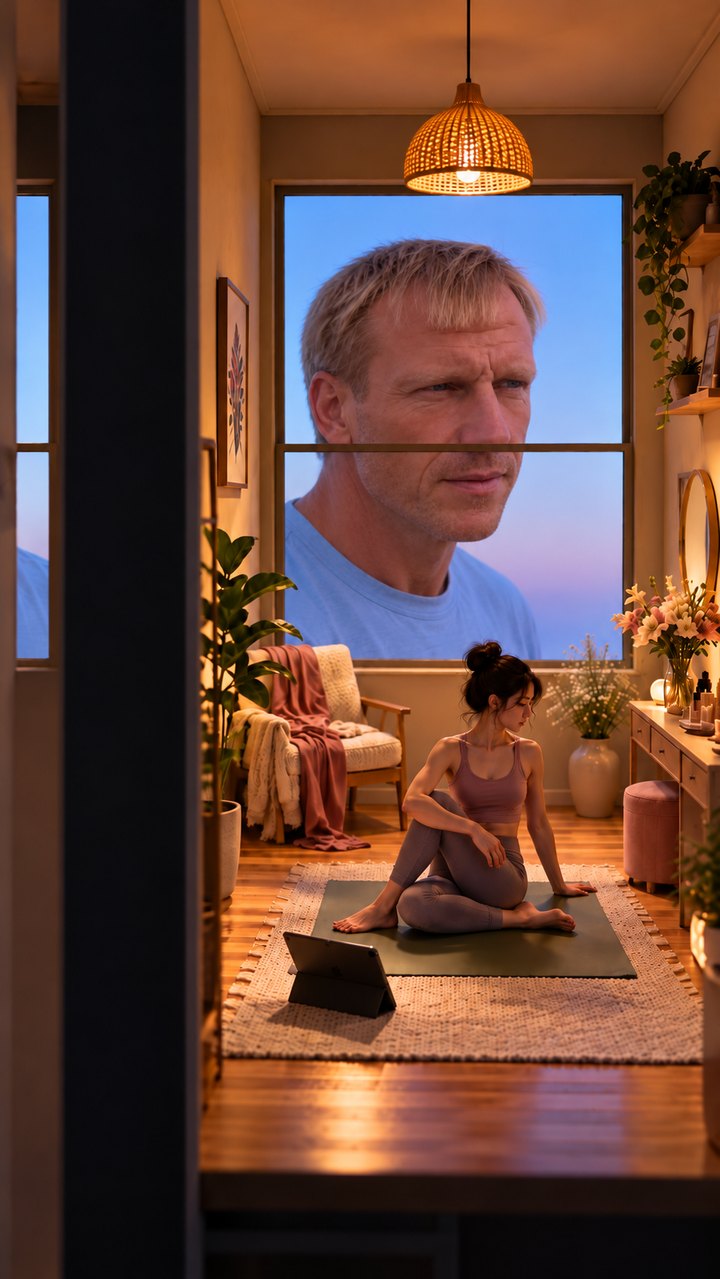
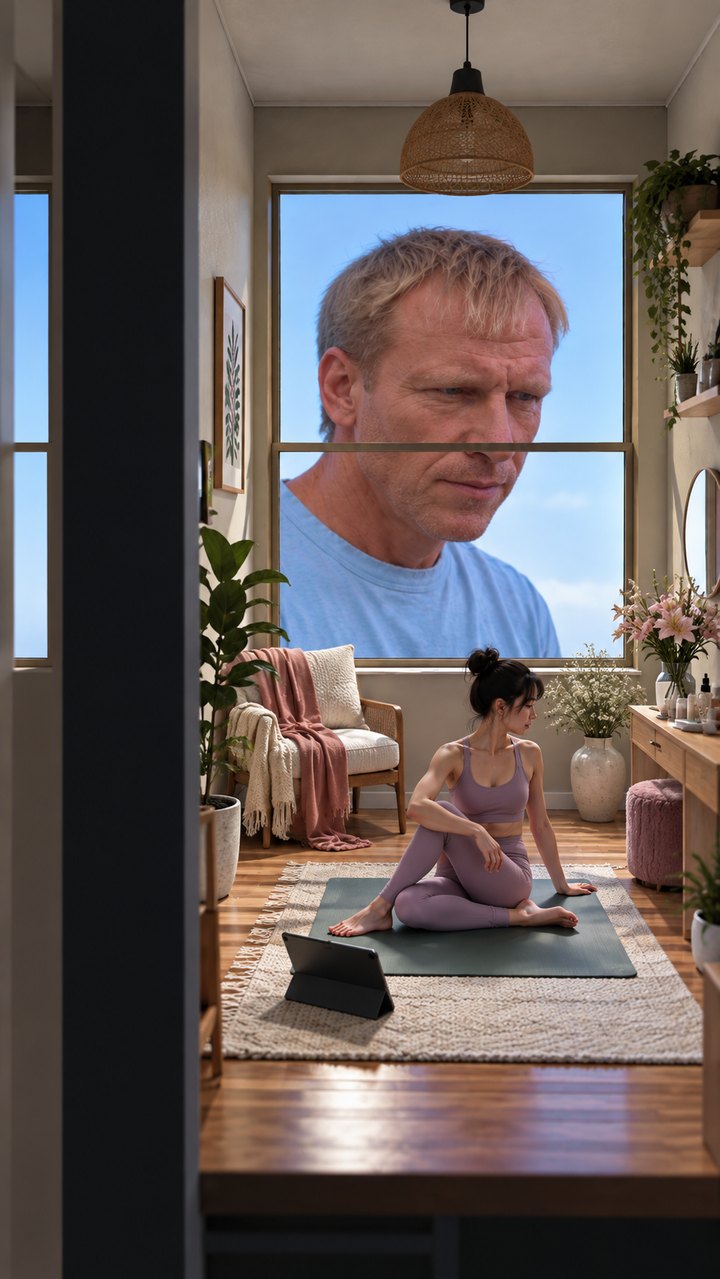
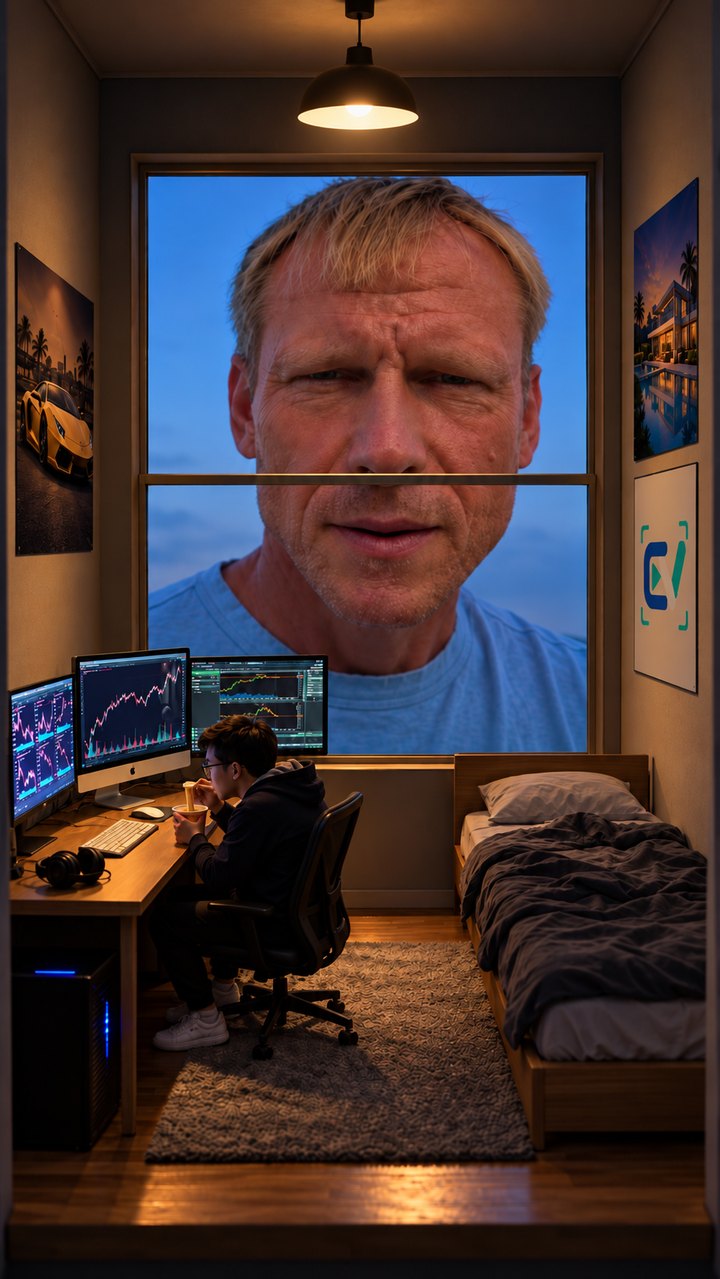
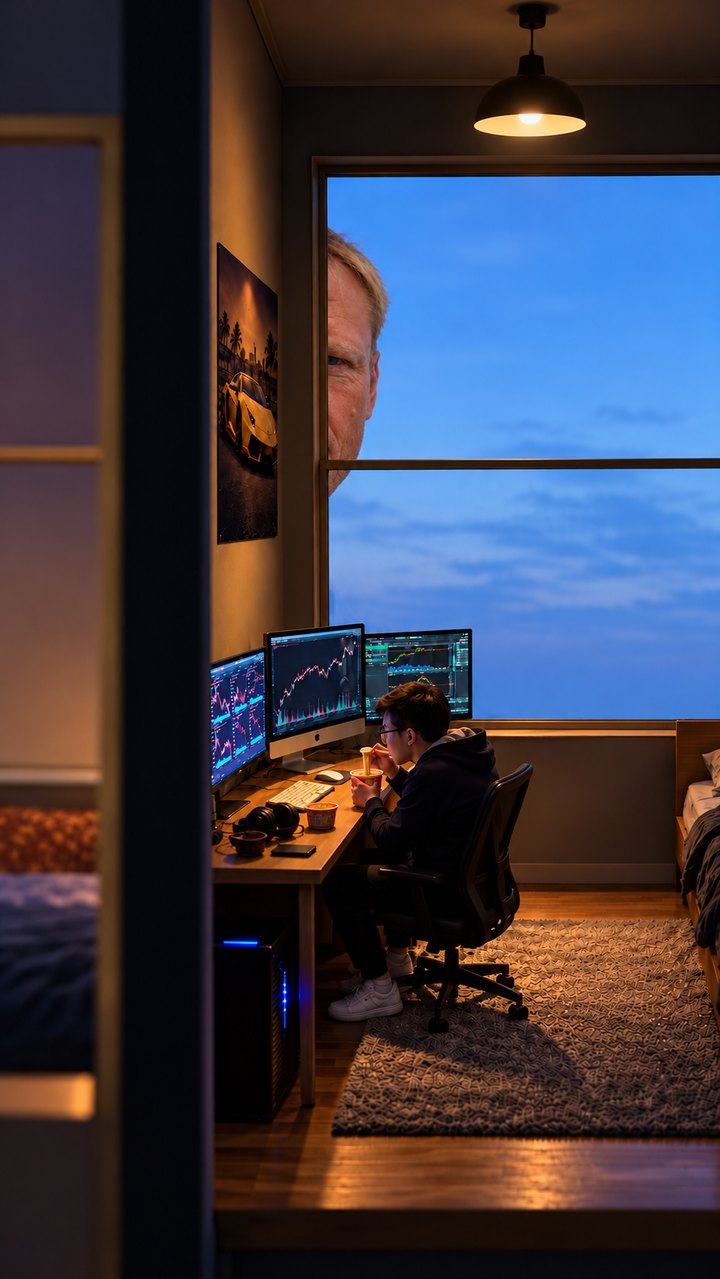
Die Methode bestand darin, die Schlüsselbilder zu genehmigen, bevor Videos generiert wurden: die Eröffnung des Trader-Zimmers, der Riese, der ihn beobachtet, und der Schlussframe im Yoga-Raum.
Start
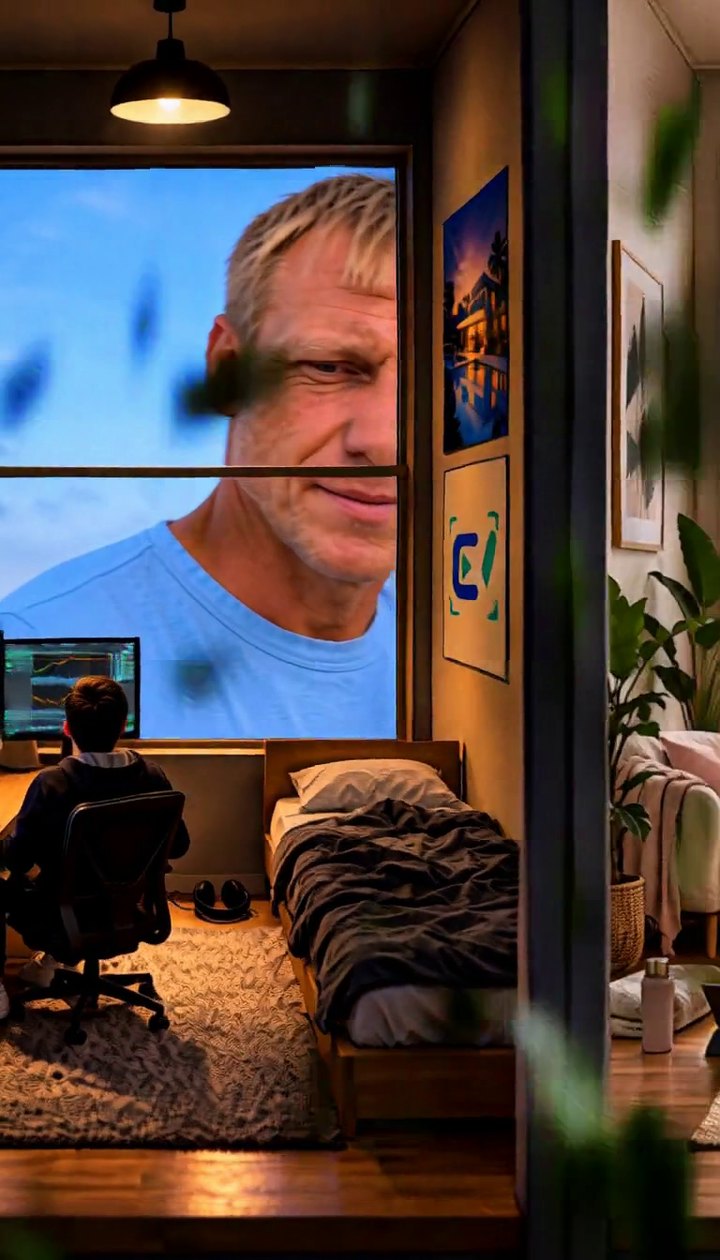
Das Zimmer des Traders
Ein Ausschnitt des vorherigen Raums, die Trennwand und nur der Rand des Gesichts des Riesen.
Mitte
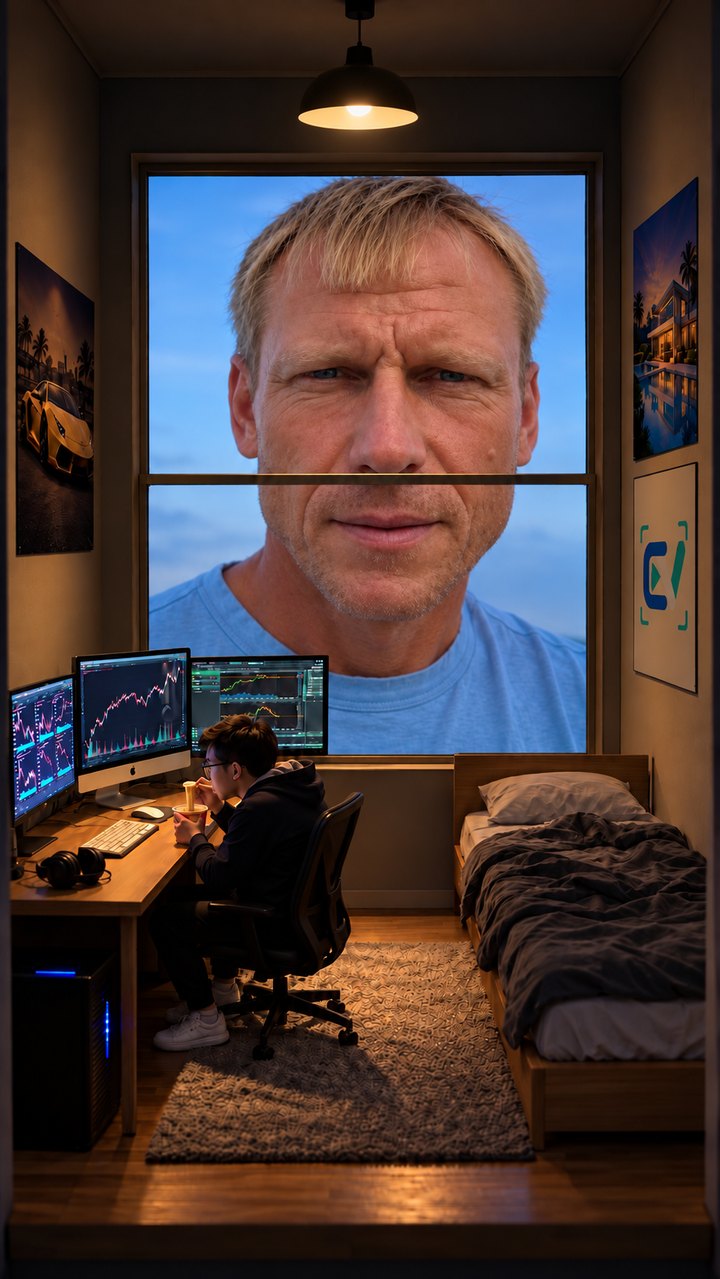
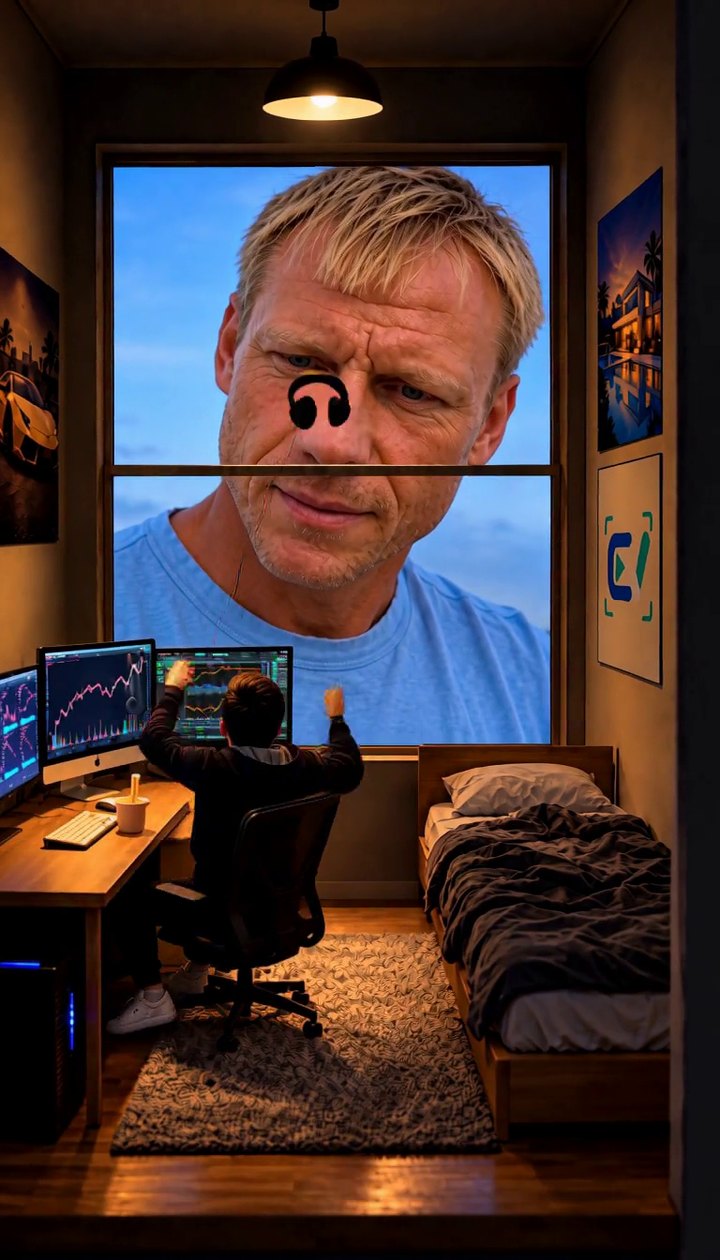
Der Riese beobachtet
Sein Gesicht füllt das Fenster aus, die Augen sind auf den Trader gerichtet. Dieser Frame wird später zum gemeinsamen Schnittpunkt.
Ende
Der Yoga-Raum
Gleiche Fenstergröße, Bodenhöhe und Gesichtsskalierung, ein Raum weiter rechts.
Bilder, Runde 1: 33 Bilder in einem ChatGPT-Chat
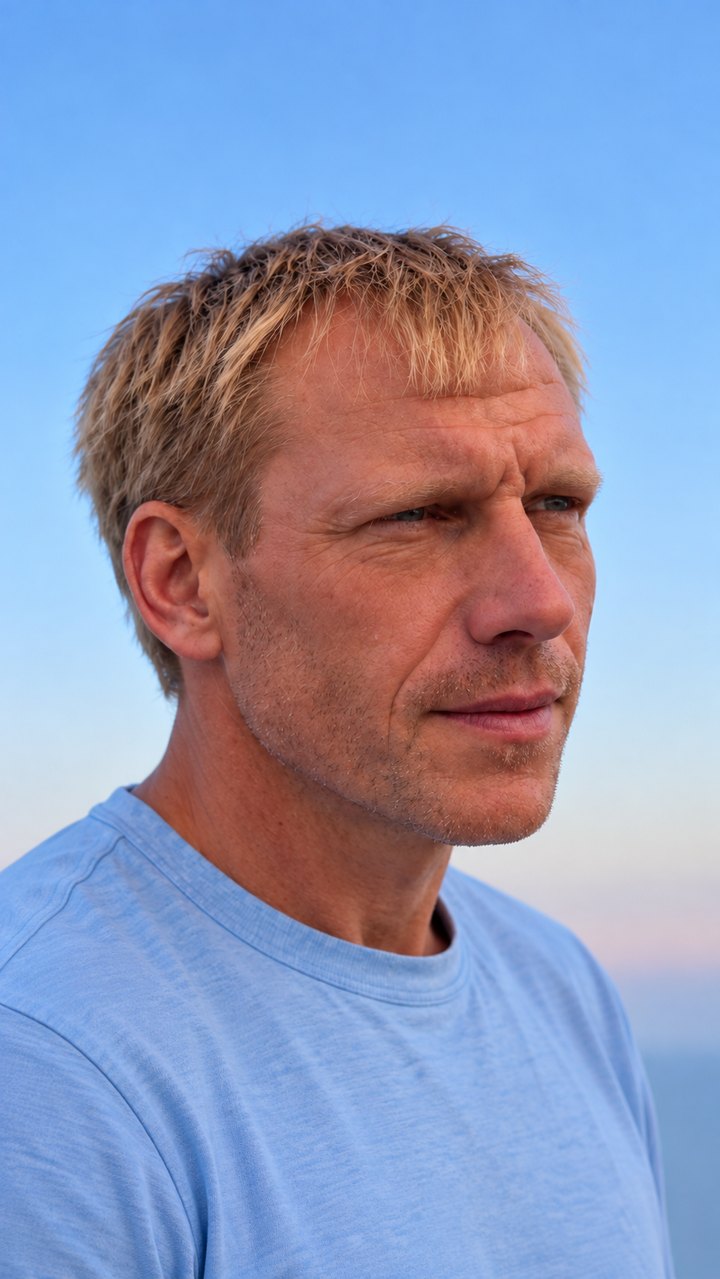
Der erste Versuch war ein gewöhnliches ChatGPT-Gespräch in einem Plus-Plan: Beschreiben Sie den Raum, fügen Sie ein Foto meines Gesichts bei, bitten Sie um Änderungen. Ich benötigte 26 Nachrichten und es wurden 33 Bilder erzeugt, wobei etwa 18 meiner Nachrichten Korrekturen waren. Jede Antwort baute die Szene von Grund auf neu auf, sodass die Korrektur einer Sache eine andere beschädigte.
Keine Monitore, kein Trader.Zu unordentlich, und der Riese fehlt.Der Trader aus dem alten Raum ist noch im Bild.„Eine völlig andere Person.“Ich, aufgeteilt auf zwei Fenster.Fenster bei 78% der angeforderten Größe.
Gegen Ende habe ich die exakte Pixelgeometrie für das Fenster und beide Personen angegeben und den Chat gebeten, sein eigenes Ergebnis zu messen. Er meldete ein Fenster von 485 × 644 px im Vergleich zu den 621 × 811 px im Prompt: 136 px zu schmal und 167 px zu kurz. Ein Modell, das ein Bild aus Worten neu zeichnet, kann keine exakten Pixelwerte treffen, egal wie präzise die Worte sind.
Bilder, Runde 2: 11 Bilder, meist beim ersten Versuch
Die zweite Runde startete vom besten Bild aus Runde 1 und lief in Codex verbunden mit der easyai.video-Plattform, mit unseren installierten Bildtechniken. Acht Anfragen erzeugten elf Bilder. Sechs der acht Anfragen waren neue Änderungen, die jeweils beim ersten Versuch genehmigt wurden; die anderen zwei waren Korrekturen für die Wandposition und die Bodenhöhe.
Start: Das beste Bild aus Runde 1.1 · eine Lichtquelle, schärferes Gesicht.2 · Fokus auf den Trader.3 · die Wand zwischen den Räumen.4 · der Yoga-Raum.
Zwischen den Runden hat sich nichts Magisches geändert. Die Art der Fragestellung hingegen schon:
Bearbeiten, nicht neu generieren. Jede Anfrage basierte auf dem zuletzt genehmigten Bild und behielt alles bei, was bereits korrekt war.
Eine Änderung pro Anfrage. Licht, dann das Gesicht, dann der Blick, dann das Layout. Niemals vier Korrekturen in einer Nachricht.
Ein Auftrag pro Eingabebild. „Bild 1 ist das maßgebliche Ziel für die Bearbeitung. Bild 2 liefert nur den linken Streifen.“
Messen, dann verankern. Anstatt „mache den Raum schmaler“ zu sagen, gab der Prompt an, wo sich die Dinge in der Quelle befanden und wohin sie verschoben werden mussten: Übersetze den Raum um 275 px nach rechts bei 100% Skalierung, der Fensterquerschnitt bleibt bei y = 626.
Nutzen Sie eine Technik, keine Improvisation. Die Bildtechniken gaben den Anwendungsfall an (Compositing, Identitätserhalt) und schrieben den Prompt jedes Mal in derselben Struktur.
Sie können dasselbe in Ihrem eigenen Setup tun. Codex und Claude Code laden beide Skills: einen Ordner mit Anweisungen und optional Skripte, die der Agent vor der Ausführung liest. Eine breite Palette an Bild- und Videoskills ist auf GitHub und anderen öffentlichen Ressourcen verfügbar. Wählen Sie Skills aus, die zu Ihrem Modell und Ihrer Schnittaufgabe passen, und nutzen Sie diese, um Ihre Prompts automatisch zu verbessern. Die easyai.video-Plattform enthält diese Skills sowie die Prompt-Formate, die das jeweilige Videomodell erwartet.
Video, Take 1: Die gesamte Szene als eine 8-sekündige Einstellung
Nachdem die drei Bilder genehmigt wurden, verlangten die ersten Video-Versuche alles in einer Generierung: essen, bemerken, rufen, werfen, sich entschuldigen, in den nächsten Raum gleiten. Für ein Experiment begann ich mit kostenlosen Google Flow-Generierungen. Google Flow erhielt die drei Bilder als Referenzen; Take 2 nutzte einen umgeschriebenen Prompt, der den Sprecher jeder Zeile benannte und die Tasse zum hinteren Fenster verfolgte. Seedance 2.5 erhielt die Bilder als Startframe, Bildreferenz und Endframe in seinem Omni-Referenz-Modus.
Take 1
Google Flow
Beginnt in unserem Frame, dann sagt der Riese beide Zeilen, bevor etwas geworfen wird. Der Becher fliegt auf die Kamera, nicht zum Fenster, und der Händler behält seinen eigenen Becher. Der Yoga-Raum blendet ein, anstatt hineinzuschieben.
Take 2
Google Flow
Unser erster Frame wird ignoriert: ein Torbogen und ein hellerer Raum. Zwei Riesen erscheinen, dann tritt ein Mann in Originalgröße ein und wirft den Becher. Niemand sagt „Sorry“. Es endet in einem anderen Yoga-Raum.
Take 3
Seedance 2.5 · 480p Entwurf
Die nächste der drei: Der Becher fliegt von uns weg, prallt gegen die Rückscheibe und die Kamera gleitet in den Yoga-Raum. Gerendert als einfacher 480p-Entwurf.
Die Bilder waren nicht das Problem. Die Einstellung verlangte zu viele Dinge gleichzeitig, woraufhin das Modell einige wegließ und andere umordnete.
Video, Take 2: Zwei kurze Einstellungen durch einen gemeinsamen Frame
Die Lösung bestand darin, die Szene dort aufzuteilen, wo sie natürlich bricht. Einstellung A läuft vom Startframe bis zum mittleren Frame in 3 Sekunden: Der Trader isst und die Riesenfigur ragt in das Fenster hinein. Einstellung B läuft von diesem mittleren Frame bis zum Endframe in 6 Sekunden: Die Linie, der Wurf, die Entschuldigung und der Wechsel in den Yogaraum. Die beiden Einstellungen teilen sich einen Frame, was ihnen beim Schnitt eine gemeinsame Komposition verleiht. In dieser Version wirft der Trader seine Kopfhörer statt des Nudelbechers: Die über das Fenster gespritzten Nudeln waren unangenehm anzusehen, und Seedance stellte sie viel zu groß dar.
Beide Einstellungen wurden mit Wan 3.0 auf Higgsfield erstellt, in nativen 1080 × 1920 bei 30 fps mit generiertem Sound.
Einstellung A · 3 s
Wan 3.0
Der Händler isst weiter und schaut nie auf; der Riese gleitet hinein und positioniert sich im mittleren Frame.
Einstellung B · 6 s
Wan 3.0
„Lass mich in Ruhe!“, die Kopfhörer treffen auf das Glas und fallen, „Entschuldigung.“, dann der Übergang in den Yogaraum, endend auf dem letzten Frame. Am Ende wurden einige Musiknoten hinzugefügt, was der Prompt eigentlich ausschloss.
A + B · 9 s
Verbunden am gemeinsamen Frame
Das Gesicht hat im zweiten Teil eine leicht andere Hauttextur, weshalb der Schnitt sichtbar ist. Ein Modell, das eine einzige ununterbrochene Einstellung erzeugen kann, wie etwa Seedance, ist für die Kontinuität vorzuziehen.
Dieselbe Einstellung auf MiniMax H3: Full-Modell vs. Turbo
Wir haben Einstellung B anschließend erneut auf MiniMax H3 gerendert, mit unserer eigenen Kopie des Modells innerhalb des täglichen GPU-Kontingents von Hugging Face, mit denselben zwei Frames, derselben Geschichte und demselben Seed (42). Die easyai.video-Plattform schreibt den Prompt zuerst in das Format um, das H3 erwartet; der folgende Prompt ist das, was nach dieser Umformulierung in das Modell eingegeben wurde.
Einstellung B · Wan 3.0
1080 × 1920 · 30 fps
Die Referenz: jeder Beat in der richtigen Reihenfolge, endend beim letzten Frame.
Einstellung B · H3 vollständig
768 × 1344 · 24 fps · 28 Schritte
Vergleichbar mit Wan 3.0 in dieser Einstellung: Die Linie, der Wurf, die Entschuldigung und die Bewegung sitzen alle. Niedrigere Auflösung; verbraucht einen Teil des täglichen GPU-Kontingents.
Einstellung B · H3 Turbo
768 × 1344 · 24 fps · 6 Schritte
Erfüllt die erzählerischen Punkte, aber das große Gesicht, die Kopfhörer und der Übergang zwischen den Räumen verraten die KI.
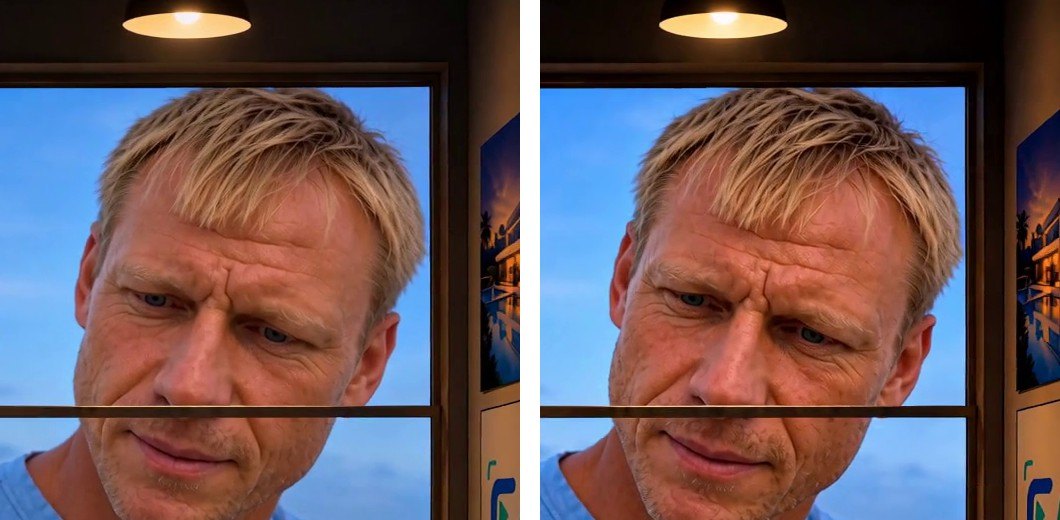
Im selben Moment, 1.6 s in Einstellung B, in voller Größe. Links: H3 voll. Rechts: H3 turbo, mit dunklen Flecken auf der Haut.
Turbo, 2.0 s: Die Kopfhörer wirken wie ein flaches Icon, das auf das Gesicht geklebt wurde, nicht wie ein Objekt im Flug.Turbo, 4.3 s: Es wurde niemand gefragt, warum während der Bewegung ein Drift durch den Vordergrund entsteht.
Turbo ist für Entwürfe gedacht. Es eignet sich gut, um eine Kamerabewegung zu planen oder zu testen, ob die Frames funktionieren. Wenn ein Gesicht das Bild ausfüllt, rendern Sie den Take mit dem vollen Modell.
Kostenübersicht pro Modell
Rote Kreuze markieren inakzeptable Takes. Gelbe Häkchen markieren Takes, die dem Ziel nahekommen, aber noch Unstimmigkeiten aufweisen; bei Seedance betrifft dies beispielsweise überdimensionierte Nudeln. Jede Tabellenzeile deckt ein Modell und eine Plattform ab, wobei die Gesamtkosten des Materials aufgeführt sind.
Modell · Plattform
Material
Ausgabe
Kostenbasis
ca. EUR
Google Flow
2 × 8 s
720 × 1280
Kostenlose tägliche Credits
€0
Seedance 2.5 Entwurf · Higgsfield
8 s
480 × 854
24 Credits
€1.05
Wan 3.0 · Higgsfield
3 s + 6 s
1080 × 1920 · 30 fps
31.5 Credits (3.5 pro Sekunde)
€1.38
MiniMax H3 voll · Hugging Face
6.58 s
768 × 1344 · 24 fps
≈ 10.9 / 40 täglich GPU Minuten (27.3%)
€0.073
MiniMax H3 Turbo · Hugging Face
6.58 s
768 × 1344 · 24 fps
≈ 4.2 / 40 täglich GPU Minuten (10.5%)
€0.028
Higgsfield Schätzungen basieren auf dem gebuchten $49 / 1,000-Credit-Plan, wobei alle Credits aufgebraucht sind. Hugging Face Schätzungen verteilen das $9 Monatsabonnement auf 30 Tage und multiplizieren diesen Tagesanteil dann mit dem Quotenprozentsatz in den Run-Logs, einschließlich Conditioning. Dies sind zugewiesene Abonnementkosten, keine Rechnungen pro Run; eine nicht genutzte Quote erhöht die effektiven Kosten.
Entwerfen Sie zuerst die Schlüsselbilder und animieren Sie dann zwischen ihnen. Gemeinsame Frames helfen dabei, eine Szene mit mehreren Einstellungen auszurichten, aber überprüfen Sie Hauttextur und Beleuchtung beim Schnitt.
Bearbeiten Sie das genehmigte Bild, anstatt erneut anzufragen. Eine Änderung pro Anfrage, ein Auftrag pro Eingabebild, reale Positionen statt Adjektive.
Turbo-Modelle sind für Entwürfe gedacht. Rendern Sie die finalen Takes mit dem vollen Modell, wenn ein Gesicht groß im Bild zu sehen ist.
Ein Open-Source-Modell kann bei einer bestimmten Einstellung mit einem kostenpflichtigen Modell mithalten. H3 im Vergleich zu Wan 3.0 hier. Das Bereitstellen eines OSS-Modells auf einer GPU kann je nach Hardwarenutzung und Hosting-Kosten ein ähnliches Ergebnis bei deutlich geringeren Kosten als ein kostenpflichtiges Modell über eine API liefern.
Nutzen Sie Fähigkeiten, um Bild- und Videoprompts automatisch zu verbessern. Spezielle Anweisungen übersetzen eine kurze Anfrage in die Struktur und die Einschränkungen, die jedes Modell benötigt.
Erstellen Sie eine Einstellung wie diese selbst
AI Video Starter ist ein dreistündiger Live-Workshop: Idee, Einstellungsplan, Referenzbilder, Generierung, Korrektur misslungener Takes und Montage - an Ihrem eigenen Kurzvideo.