Porque o modelo de IA correto e competências especializadas fazem o plano funcionar
Uma curta cena de comédia numa casa de bonecas em miniatura, testada em vários fluxos de trabalho: imagens num chat e com um fluxo de montagem, vídeo em Google Flow, Seedance 2.5, Wan 3.0 e MiniMax H3. O que falhou, o que o resolveu e todos os prompts.
Publicado 15 outubro 20267 gerações de vídeo comparadas10 min de leitura
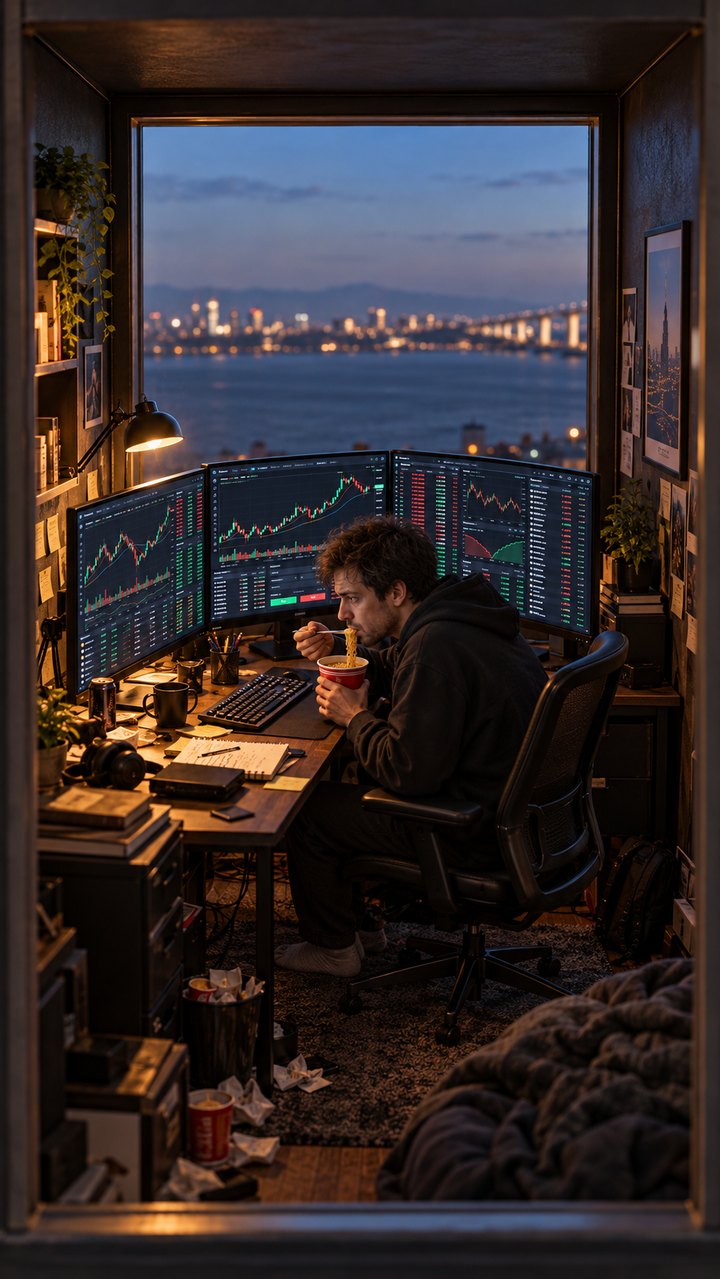
O objetivo era um único plano numa sala específica de uma casa de bonecas fotorrealista, terminando com a câmara a mover-se para a sala seguinte. Dura cerca de nove segundos. Um pequeno trader come massa à frente de três monitores. Um homem gigante, eu, observa-o através da janela traseira. O trader exclama “Deixe-me em paz!” e atira algo contra o vidro. O gigante diz “Desculpe!”, e a câmara desliza para a sala de ioga vizinha, onde uma mulher mantém os olhos no seu tablet.
O plano curto original parecia simples, mas revelou-se complexo em cada etapa da produção: duas personagens a falar com sincronia labial, um lançamento com física real, um movimento de câmara contínuo entre duas divisões e um rosto grande que ocupa o plano durante segundos. Estes são os resultados, lado a lado, com os prompts.
O plano: primeiro três imagens
O método consistiu em aprovar as imagens principais antes de gerar qualquer vídeo: a abertura da sala do trader, o gigante a observá-lo e o fotograma final na sala de ioga.
Iniciar
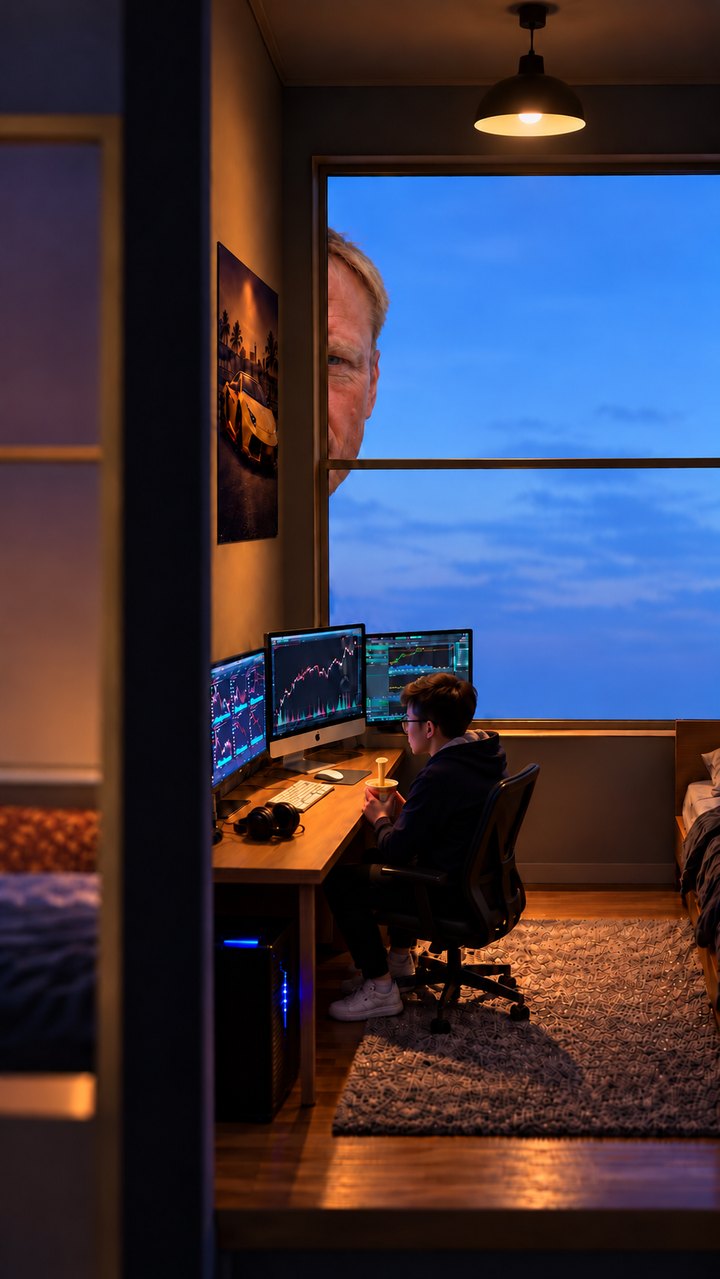
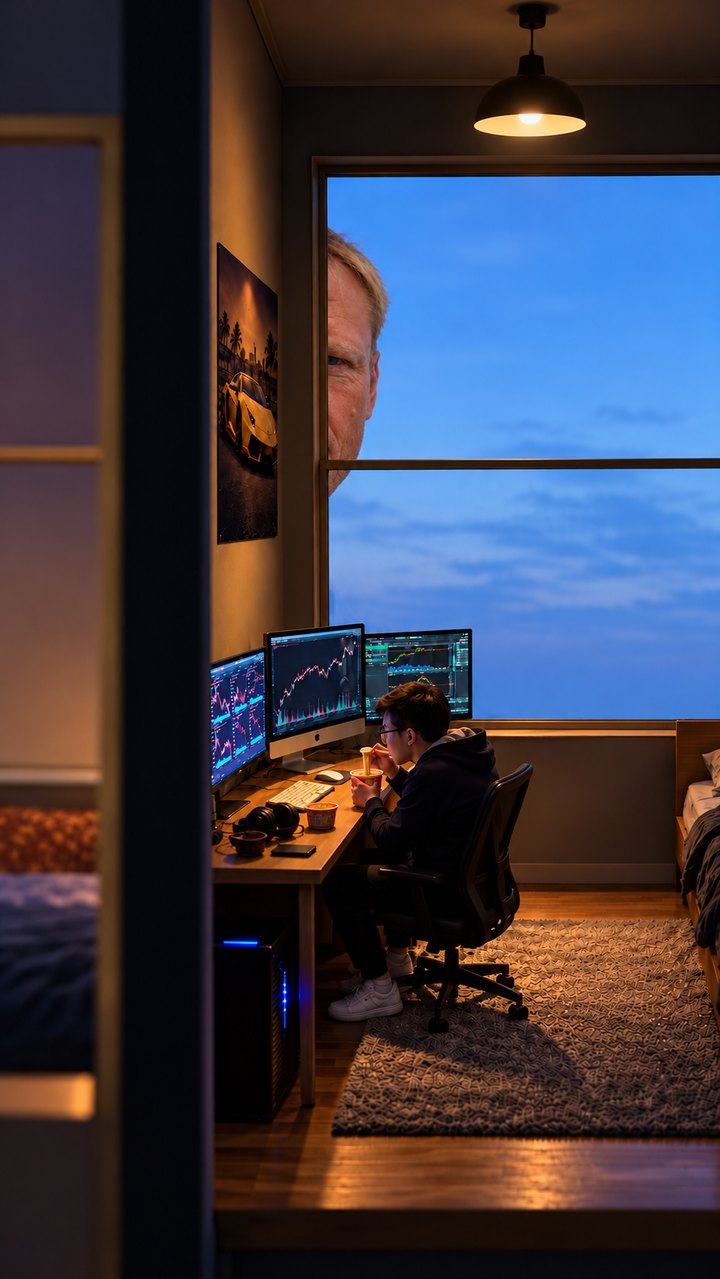
A sala do trader
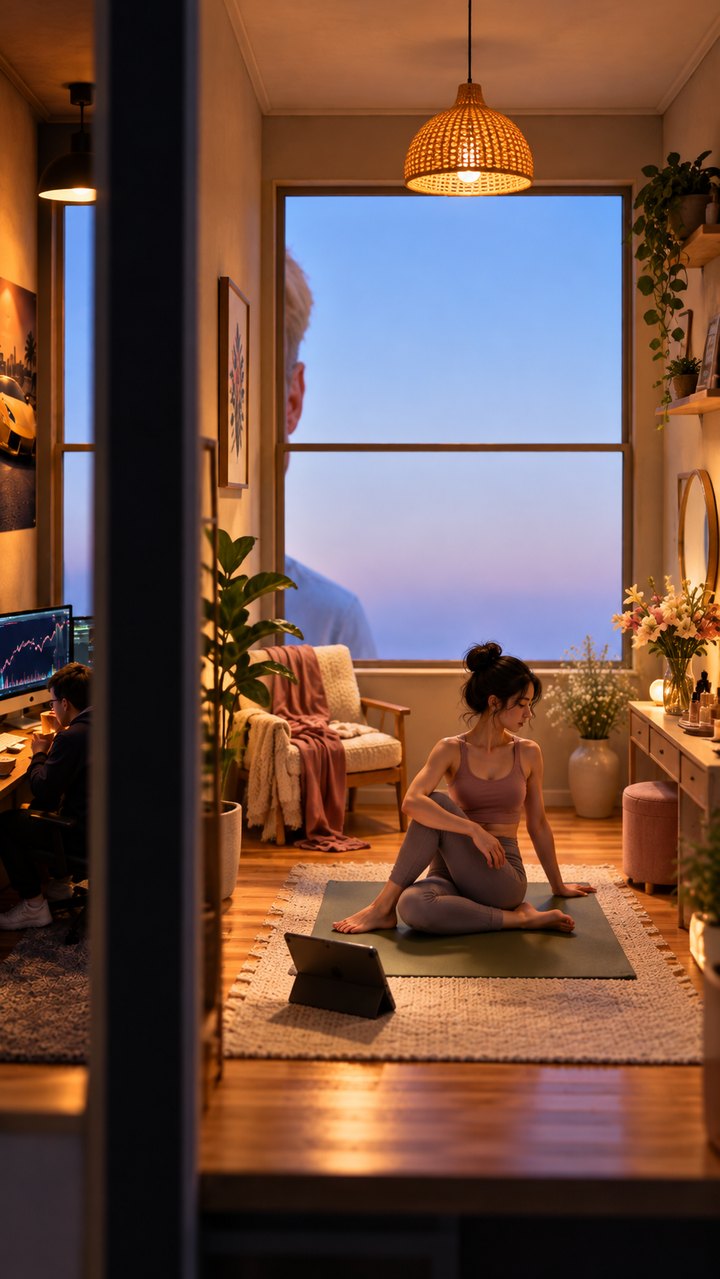
Um fragmento da sala anterior, a parede divisória e apenas a extremidade do rosto do gigante.
Intermédio
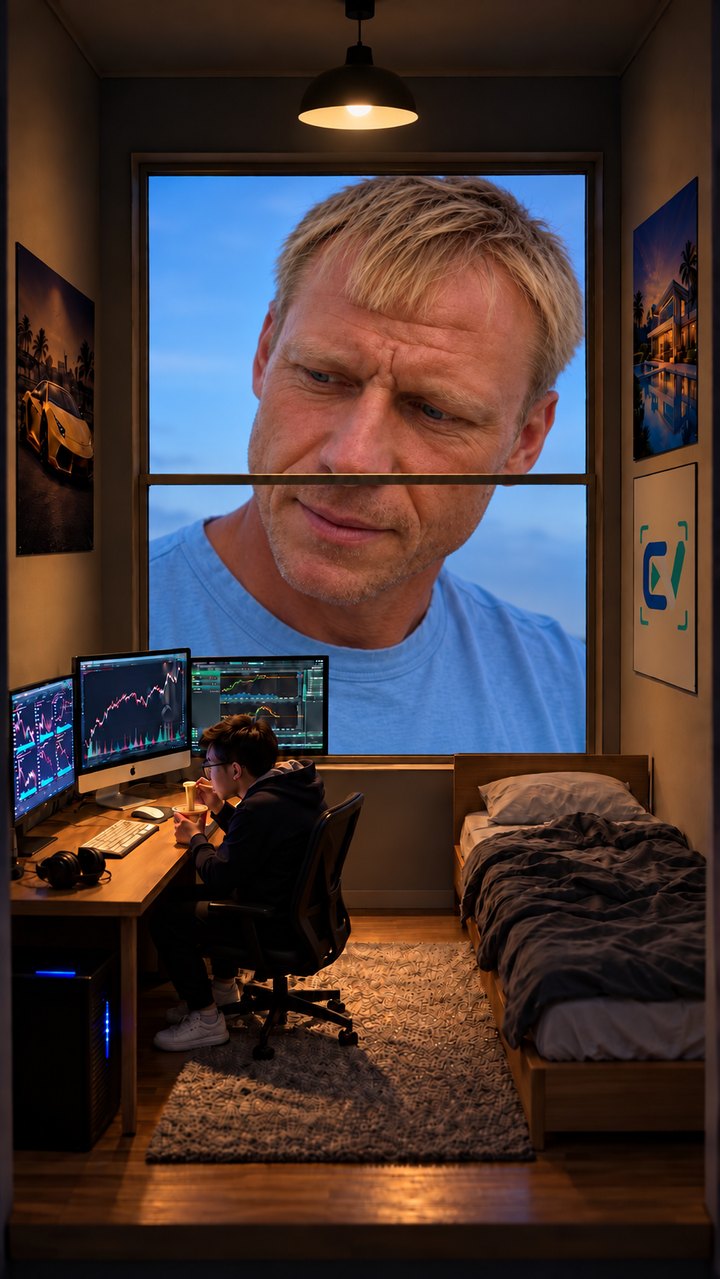
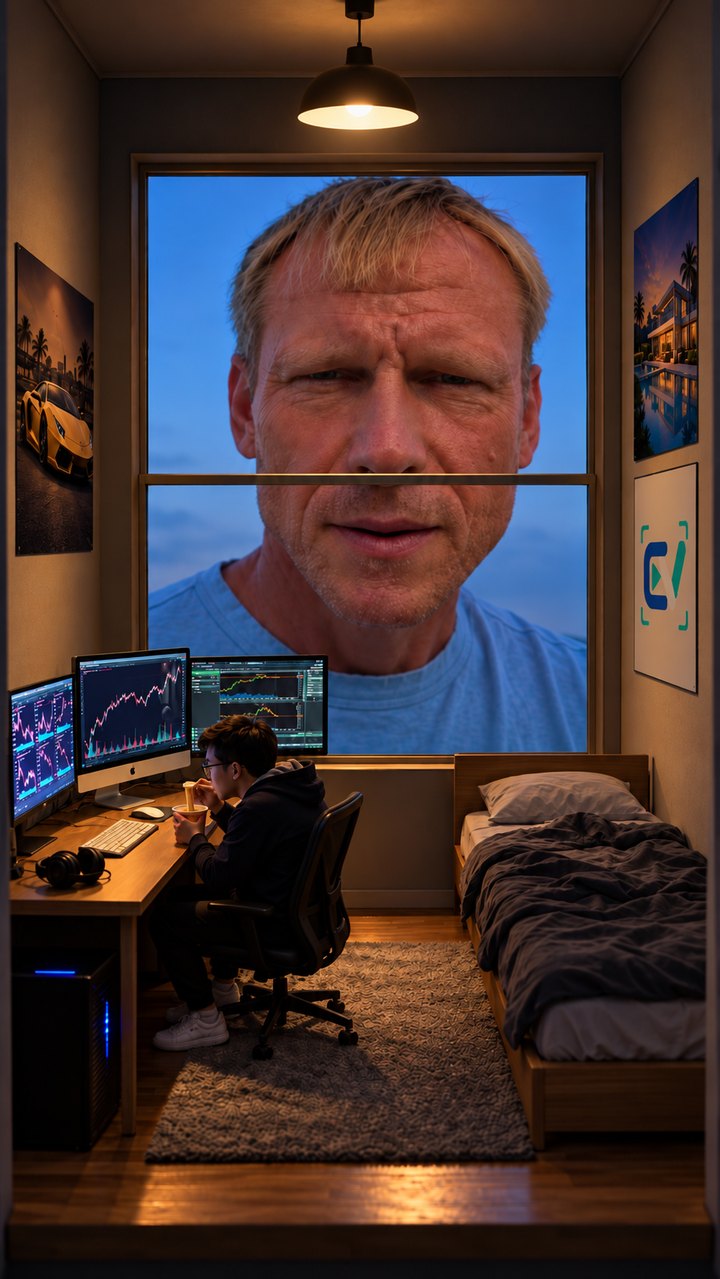
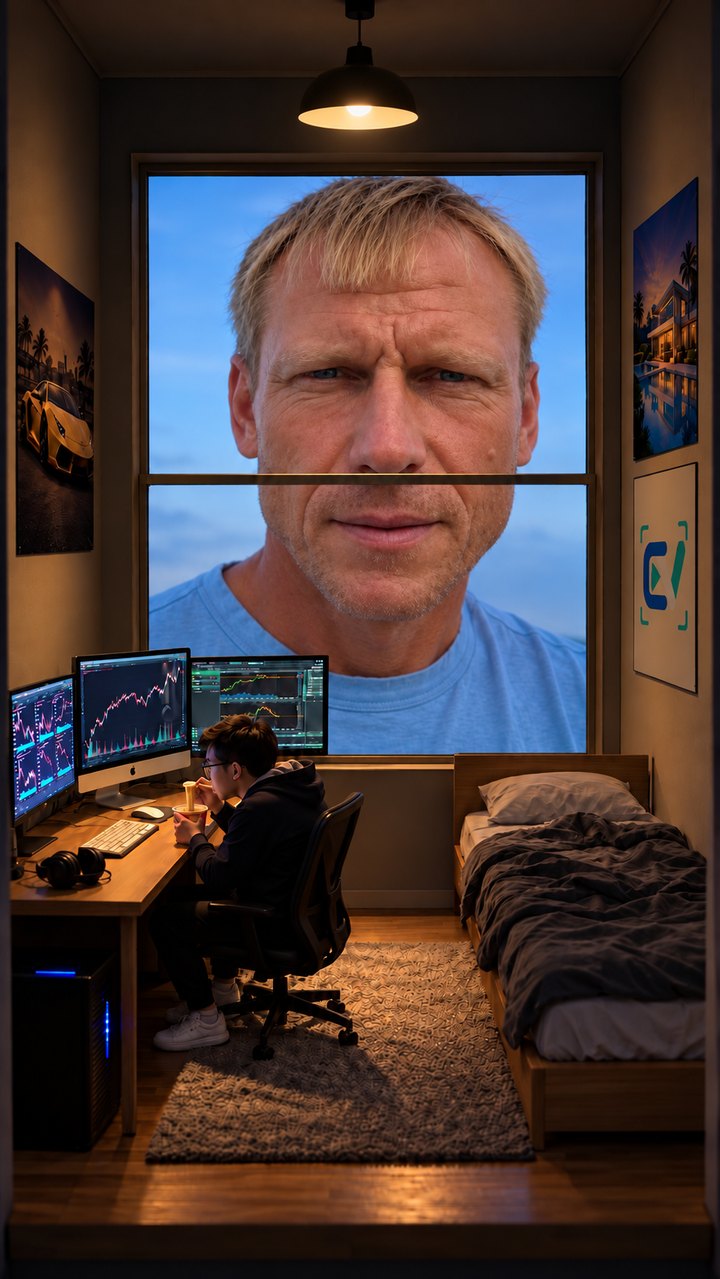
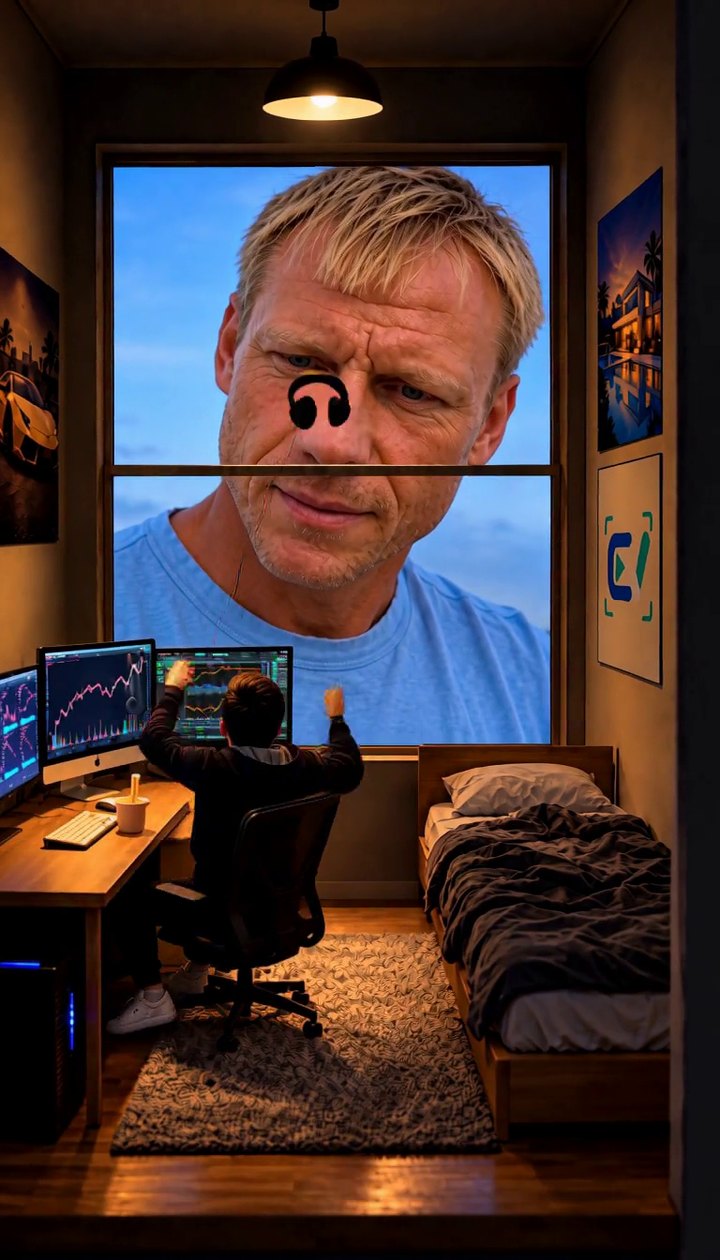
O gigante está a observar
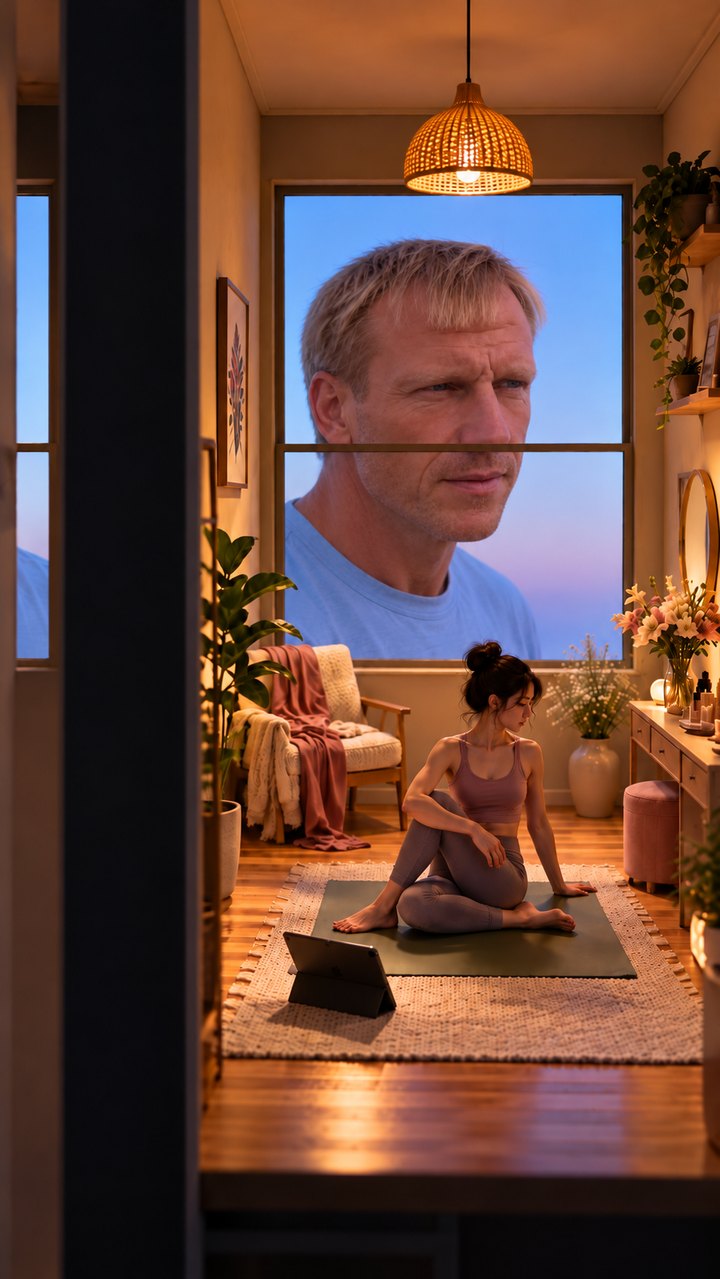
O rosto dele preenche a janela, com os olhos fixos no trader. Este fotograma torna-se o ponto de corte partilhado mais tarde.
Fim
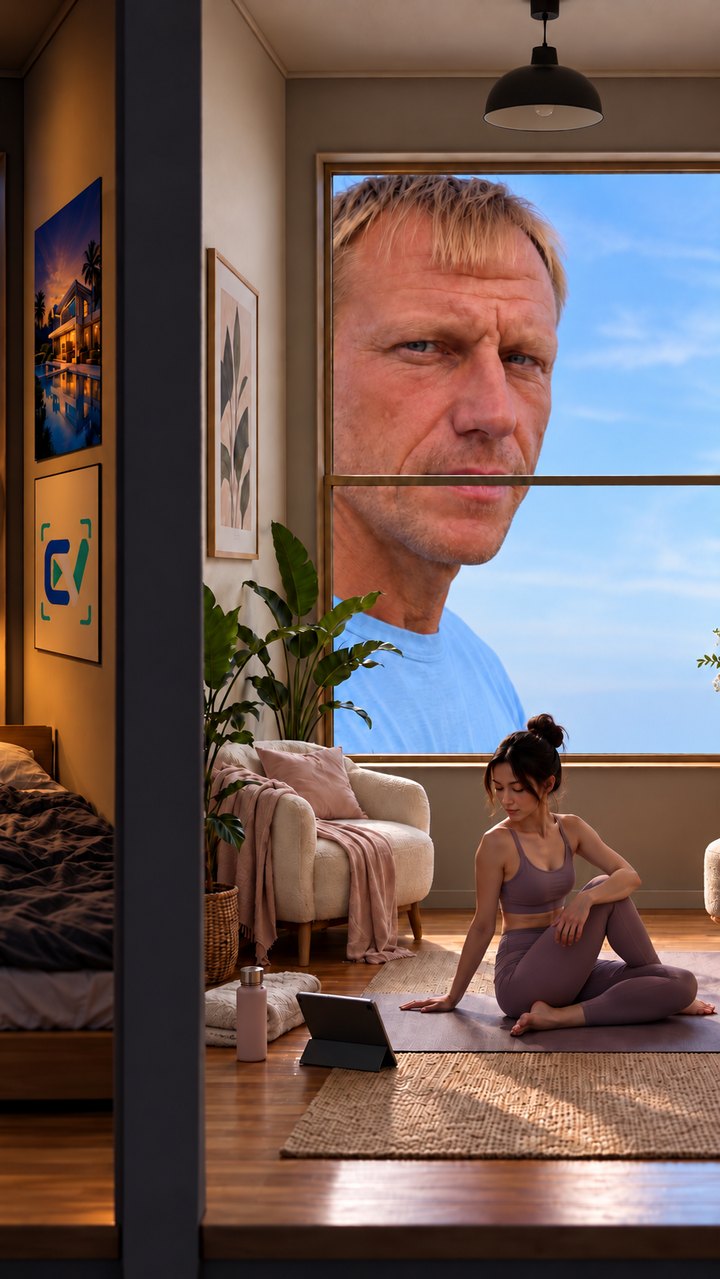
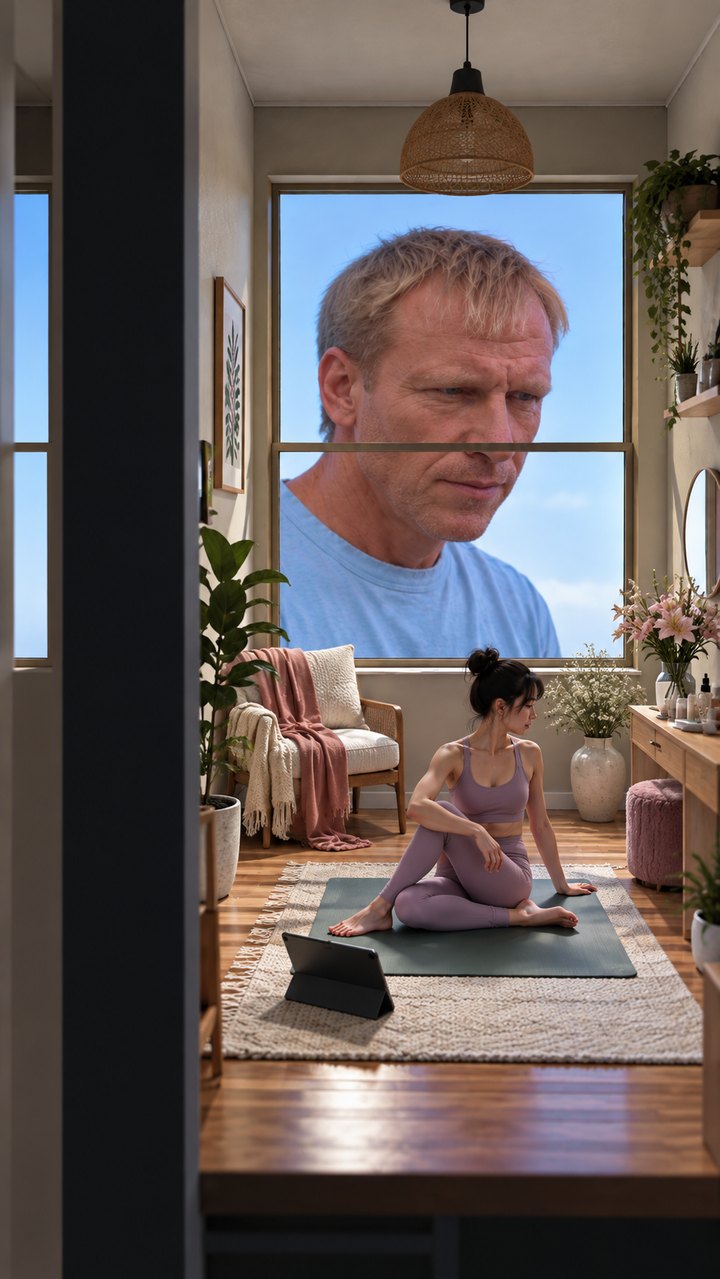
A sala de ioga
Mesmo tamanho de janela, altura do chão e escala facial, uma sala à direita.
Imagens, ronda 1: 33 imagens num chat ChatGPT
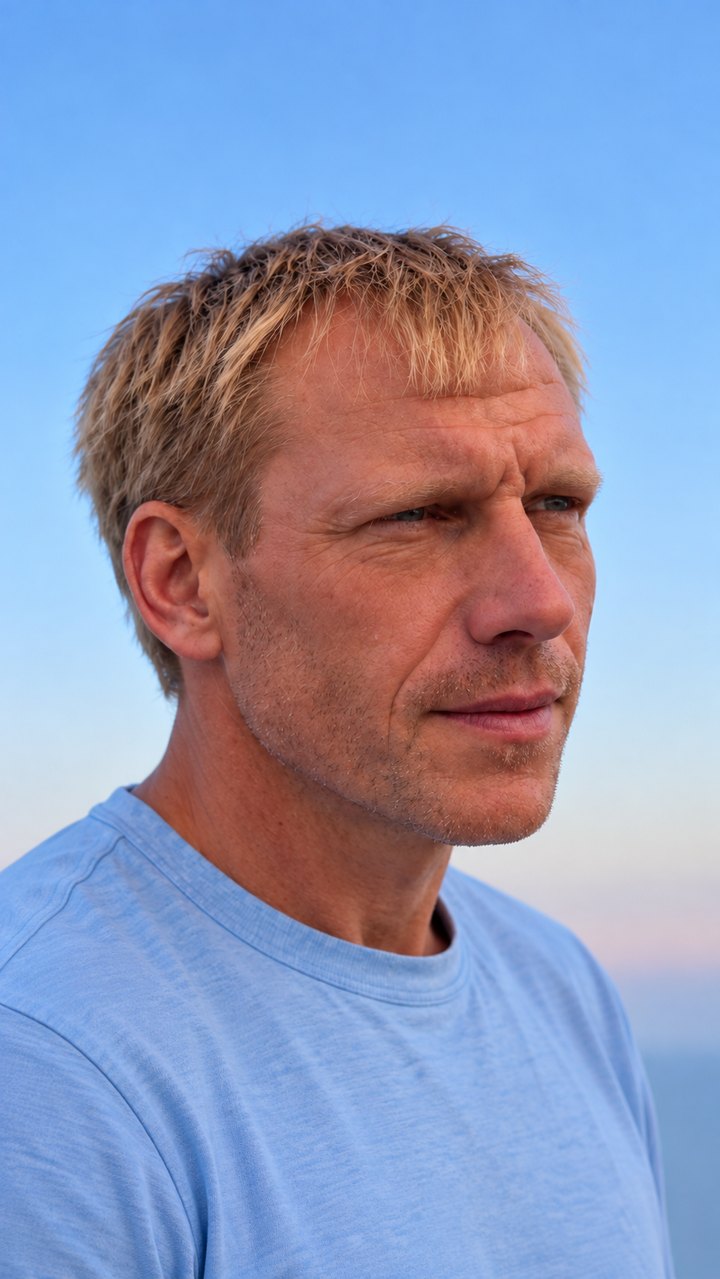
A primeira tentativa foi uma conversa comum com o ChatGPT num plano Plus: descrever a sala, anexar uma foto do meu rosto, pedir alterações. Foram necessárias 26 mensagens da minha parte e foram produzidas 33 imagens, sendo que cerca de 18 das minhas mensagens foram correções. Cada resposta reconstruía a cena do zero, pelo que corrigir uma coisa estragava outra.
Sem monitores, sem trader.Demasiado confuso, e o gigante não aparece.O trader da sala antiga ainda está no plano.“Uma pessoa totalmente diferente.”Eu, dividido por duas janelas.Janela a 78% do tamanho solicitado.
Perto do fim, forneci a geometria de píxeis exata para a janela e para ambas as pessoas, e pedi ao chat que medisse o seu próprio resultado. Reportou uma janela de 485 × 644 px face aos 621 × 811 px do prompt: 136 px demasiado estreita e 167 px demasiado curta. Um modelo que redesenha uma imagem a partir de palavras não consegue atingir números de píxeis exatos, por mais precisas que as palavras sejam.
Imagens, ronda 2: 11 imagens, maioritariamente à primeira tentativa
A segunda ronda começou a partir da melhor imagem da ronda 1 e correu em Codex ligada à plataforma easyai.video, com as nossas competências de imagem instaladas. Oito pedidos produziram onze imagens. Seis dos oito pedidos foram alterações novas, cada uma aprovada à primeira tentativa; os outros dois foram correções, para a posição da parede e a altura do chão.
Iniciar: a melhor imagem da ronda 1.1 · uma fonte de luz, rosto mais nítido.2 · foco no trader.3 · a parede entre as salas.4 · a sala de ioga.
Nada de mágico mudou entre as rondas. A forma de pedir mudou:
Edite, não regenere. Cada pedido partia da última imagem aprovada e mantinha tudo o que já estava correto.
Uma alteração por pedido. Luz, depois o rosto, depois o olhar, depois o layout. Nunca quatro correções numa única mensagem.
Um trabalho por imagem de entrada. “A Imagem 1 é o alvo de edição de referência. A Imagem 2 fornece apenas a tira esquerda.”
Meça, depois ancore. Em vez de “torne a sala mais estreita”, o prompt indicou onde as coisas estavam na origem e para onde tinham de ir: desloque a sala 275 px para a direita a uma escala de 100%, a travessa da janela mantém-se em y = 626.
Use uma competência, não improvisação. As competências de imagem nomearam o caso de uso (composição, preservação de identidade) e escreveram o prompt com a mesma estrutura todas as vezes.
Pode fazer o mesmo no seu próprio ambiente. Codex e Claude Code carregam ambos competências: uma pasta com instruções e, opcionalmente, scripts, que o agente lê antes de atuar. Uma vasta gama de competências de imagem e vídeo está disponível no GitHub e noutros recursos públicos. Escolha competências que se adaptem ao seu modelo e tarefa de edição, e utilize-as para melhorar os seus prompts automaticamente. A plataforma easyai.video inclui estas competências, bem como os formatos de prompt que cada modelo de vídeo exige.
Vídeo, tentativa 1: a cena completa como um plano de 8 segundo
Com as três imagens aprovadas, as primeiras tentativas de vídeo pediram tudo numa única geração: comer, notar, gritar, atirar, pedir desculpa, deslizar para a sala seguinte. Para um experimento, comecei com Google Flow gerações gratuitas. O Google Flow utilizou as três imagens como referência; a tomada 2 usou um prompt reescrito que identificava o interlocutor de cada linha e seguia o copo até à janela traseira. O Seedance 2.5 utilizou as imagens como fotograma inicial, uma referência de imagem e um fotograma final, no seu modo de referência omni.
Tomada 1
Google Flow
Começa no nosso enquadramento, depois o gigante diz ambas as frases, antes de algo ser atirado. A chávena voa em direção à câmara, não para a janela, e o trader mantém a sua própria chávena. A sala de ioga entra em vez de deslizar.
Tomada 2
Google Flow
O nosso primeiro fotograma é ignorado: uma porta em arco e uma sala mais clara. Surgem dois gigantes, depois um homem de tamanho real entra e atira a chávena. Ninguém diz “Desculpe”. Termina numa sala de ioga diferente.
Tomada 3
Seedance 2.5 · rascunho 480p
O mais próximo dos três: a chávena voa em nossa direção e estilhaça-se no vidro traseiro, enquanto a câmara desliza para a sala de ioga. Renderizado como um rascunho 480p de baixa qualidade.
As imagens não eram o problema. O plano solicitado tinha demasiados elementos ao mesmo tempo, e o modelo descartou alguns e reordenou outros.
Vídeo, tentativa 2: dois planos curtos através de um fotograma partilhado
A solução foi dividir a cena onde ela se quebra naturalmente. O Plano A decorre do fotograma inicial ao fotograma intermédio em 3 segundos: o trader come e o gigante surge na janela. O Plano B decorre desse mesmo fotograma intermédio até ao fotograma final em 6 segundos: a linha, o lançamento, o pedido de desculpa e a transição para a sala de ioga. Os dois planos partilham um fotograma, o que lhes confere uma composição comum no corte. Nesta versão, o trader lança os seus auscultadores em vez da taça de massa: a massa espalhada pela janela era desagradável de ver, e o Seedance desenhou-a com um tamanho excessivo.
Ambos os planos foram criados com Wan 3.0 no Higgsfield, em resolução nativa de 1080 × 1920 e 30 fps com som gerado.
Plano A · 3 s
Wan 3.0
O trader continua a comer e nunca levanta o olhar; o gigante desliza e estabiliza no fotograma central.
Plano B · 6 s
Wan 3.0
“Deixem-me em paz!”, os auscultadores batem no vidro e caem, “Desculpe.”, e depois o deslize para a sala de ioga, terminando no fotograma final. Adicionou algumas notas de música no fim, o que o prompt tinha excluído.
A + B · 9 s
Unidos no fotograma partilhado
O rosto tem uma textura de pele ligeiramente diferente na segunda parte, pelo que a junção é percetível. Um modelo que consiga fazer um plano contínuo, como o Seedance, é preferível para a continuidade.
O mesmo plano em MiniMax H3: modelo completo vs turbo
Renderizámos depois o plano B novamente no MiniMax H3, na nossa própria cópia do modelo na quota diária de GPU do Hugging Face, com os mesmos dois fotogramas, a mesma história e a mesma semente (42). A plataforma easyai.video reescreve primeiro o prompt para o formato que o H3 espera; o prompt abaixo é o que foi enviado para o modelo após essa reescrita.
Plano B · Wan 3.0
1080 × 1920 · 30 fps
A referência: cada batida por ordem, terminando no fotograma final.
Plano B · H3 completo
768 × 1344 · 24 fps · 28 passos
Comparável com Wan 3.0 neste plano: a linha, o arremesso, o pedido de desculpa e o movimento resultam bem. Resolução mais baixa; utiliza parte da quota diária de GPU.
Plano B · H3 turbo
768 × 1344 · 24 fps · 6 passos
Atinge os pontos da história, mas o rosto grande, os auscultadores e a transição entre divisões revelam a natureza artificial.
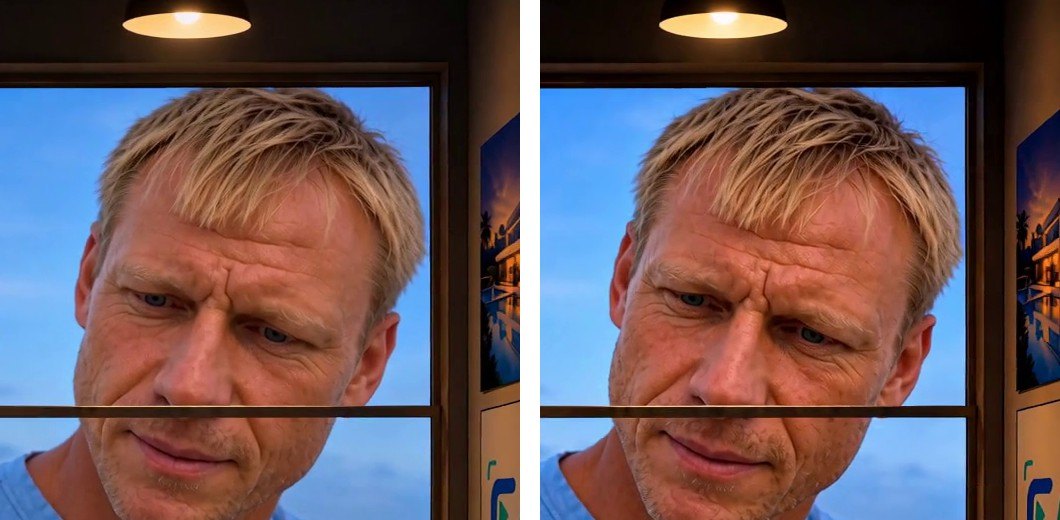
O mesmo momento, aos 1.6 s do plano B, em tamanho real. Esquerda: H3 total. Direita: H3 turbo, com manchas escuras na pele.
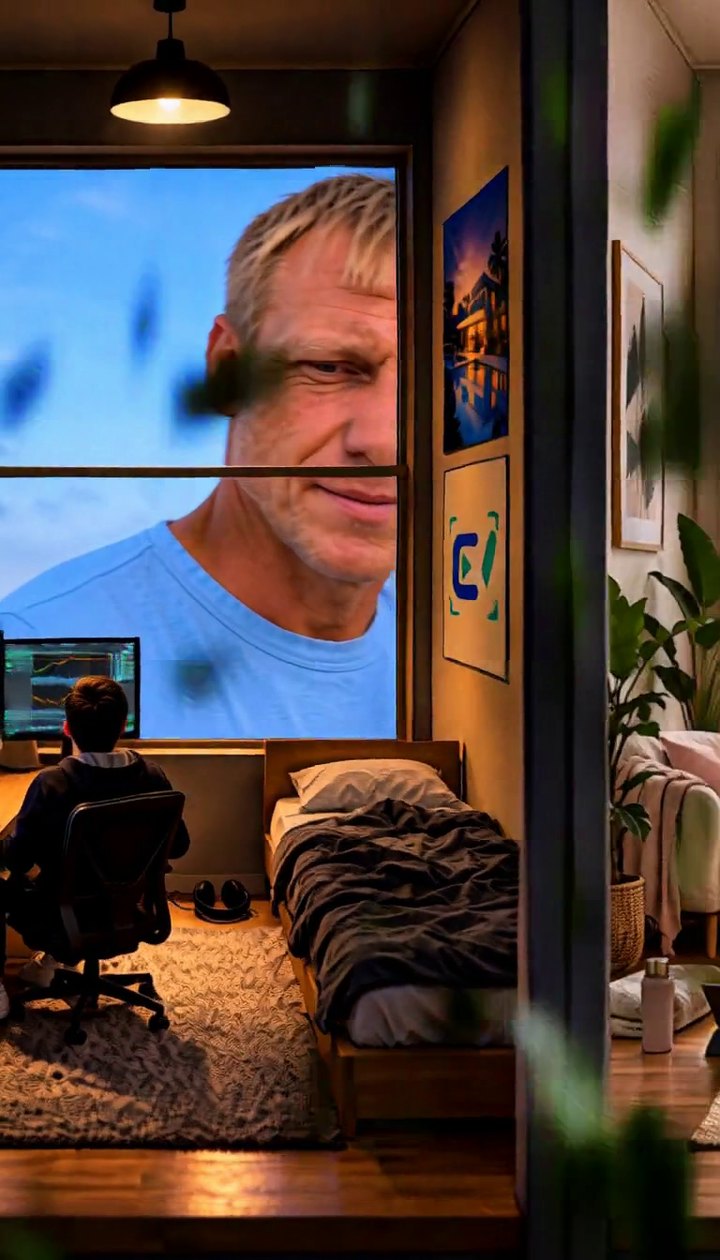
Turbo, 2.0 s: os auscultadores parecem um ícone plano colado no rosto, não um objeto em movimento.Turbo, 4.3 s: as folhas que ninguém pediu deslizam pelo primeiro plano durante o movimento.
Turbo serve para rascunhos. É útil para planear um movimento de câmara ou testar se os fotogramas funcionam. Quando um rosto preenche o plano, renderize a tomada no modelo completo.
Resumo de custos por modelo
Cruzes vermelhas marcam tomadas inaceitáveis. Vistos amarelos marcam tomadas próximas do objetivo, com inconsistências remanescentes; para Seedance, estas incluem massa de tamanho excessivo. Cada linha da tabela cobre um modelo e plataforma, com o custo total do material de vídeo listado.
Modelo · plataforma
Material de vídeo
Resultado
Base de custos
Aprox. EUR
Google Flow
2 × 8 s
720 × 1280
Créditos diários gratuitos
€0
Rascunho Seedance 2.5 · Higgsfield
8 s
480 × 854
24 créditos
€1.05
Wan 3.0 · Higgsfield
3 s + 6 s
1080 × 1920 · 30 fps
31.5 créditos (3.5 por segundo)
€1.38
MiniMax H3 total · Hugging Face
6.58 s
768 × 1344 · 24 fps
≈ 10.9 / 40 minutos de GPU diários (27.3%)
€0.073
MiniMax H3 turbo · Hugging Face
6.58 s
768 × 1344 · 24 fps
≈ 4.2 / 40 minutos de GPU diários (10.5%)
€0.028
As estimativas da Higgsfield baseiam-se no plano de $49 / 1,000 de créditos registado, com todos os créditos utilizados. As estimativas da Hugging Face alocam a sua subscrição mensal de $9 por 30 dias, multiplicando depois essa quota diária pela percentagem de quota nos registos de execução, incluindo o condicionamento. Estes são custos de subscrição alocados, não faturas por execução; a quota não utilizada aumenta o custo efetivo.
Desenhe primeiro as imagens principais e, depois, anime entre elas. Os fotogramas partilhados ajudam a alinhar uma cena de vários planos, mas verifique a textura da pele e a iluminação na junção.
Edite a imagem aprovada em vez de pedir novamente. Uma alteração por pedido, um trabalho por imagem de entrada, posições reais em vez de adjetivos.
Os modelos Turbo são para rascunhos. Renderize as tomadas finais no modelo completo quando o rosto estiver em grande plano.
Um modelo de código aberto pode igualar um pago num determinado plano. H3 completo comparado com Wan 3.0 aqui. Implementar um modelo OSS num GPU pode dar um resultado semelhante a um custo muito inferior ao de um modelo pago através de uma API, dependendo do uso de hardware e dos custos de alojamento.
Utilize competências para melhorar automaticamente os prompts de imagem e vídeo. Deixe que instruções especializadas traduzam um pedido curto na estrutura e restrições de que cada modelo necessita.
Crie um plano como este por si próprio
AI Video Starter é um workshop intensivo de três horas: ideia, plano de planos, imagens de referência, geração, correção de tomadas falhadas e montagem, no seu próprio vídeo curto.